大语言模型能预测患者生存期吗?Survprompt框架给出答案
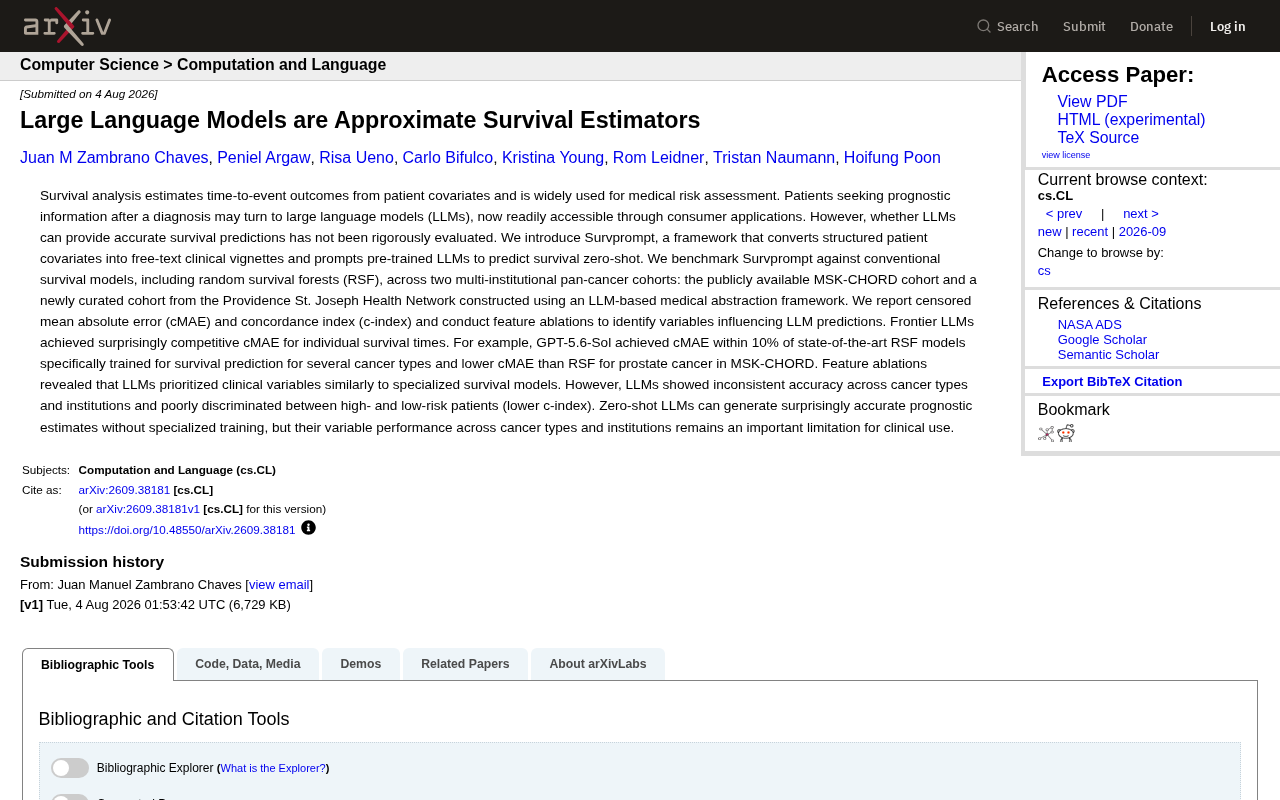
LLM在零样本条件下可近似媲美专业生存模型,但风险分层能力是硬伤。
来自arXiv的最新研究评估了大语言模型(LLM)在癌症预后预测任务上的真实表现。研究团队提出Survprompt框架,将结构化患者数据转化为自由文本临床描述,让LLM在无专项训练的零样本条件下直接预测生存期,并与生存预测领域主力方法——随机生存森林(RSF)——在两个大型泛癌种队列上进行对比。结果显示,以GPT-5.6-Sol为代表的前沿LLM在删失平均绝对误差(cMAE)上与专业模型相差不超过10%,在前列腺癌预测中甚至优于RSF,且特征消融显示LLM关注的临床变量与专业模型高度吻合。然而,LLM在高低风险患者区分能力(c-index)上表现欠佳,跨癌种、跨机构稳定性不足,论文由此将其定位为「近似生存估计器」——方向大致正确,但尚不足以支撑临床决策。
当患者向AI求助预后,LLM靠谱吗?
生存分析(Survival Analysis)是医学风险评估的核心工具,它通过患者的协变量(covariates)来估计「时间到事件」的结局——比如确诊某种癌症后的预期生存时间。随着ChatGPT类消费级应用的普及,越来越多患者在拿到诊断后,会直接向大语言模型(LLM)询问自己的预后情况。
问题在于:这些模型给出的生存预测究竟准不准?在此之前,学界并没有对此进行过严格评估。来自arXiv的一篇最新研究《Large Language Models are Approximate Survival Estimators》正面回应了这一疑问,结论颇具冲击力——前沿LLM在零样本(zero-shot)条件下,竟然能给出相当接近专业模型的预后估计。
Survprompt:把病历变成「临床小故事」
研究团队提出了一个名为 Survprompt 的框架。它的核心思路并不复杂但很巧妙:将结构化的患者协变量(如年龄、肿瘤分期、实验室指标等)转换为自由文本形式的「临床小故事」(clinical vignettes),再把这些文本喂给预训练LLM,让模型以零样本方式直接预测生存期。
这种做法的意义在于,它绕开了传统生存模型需要专门训练、依赖结构化数据格式的限制,直接利用LLM在海量医学文献和临床文本中习得的知识。换句话说,它测试的是「一个没有经过生存预测专项训练的通用模型,到底能从病历描述中读出多少预后信号」。
两大泛癌种队列上的硬核对比
为了检验Survprompt的真实水平,研究在两个多机构泛癌种(pan-cancer)队列上进行了基准测试:
- MSK-CHORD:公开可用的大型癌症队列数据
- Providence St. Joseph Health Network队列:一个全新整理的数据集,由基于LLM的医学信息抽取框架构建
对照组则是传统生存分析模型,重点是 随机生存森林(Random Survival Forests, RSF)——这是生存预测领域的主力方法之一。评估指标采用了两项关键度量:
- 删失平均绝对误差(cMAE):衡量预测生存时间与真实值的偏差
- 一致性指数(c-index):衡量模型对高低风险患者的区分能力
此外,研究还做了特征消融(feature ablations),用于识别哪些变量真正影响了LLM的预测。
随机生存森林(Random Survival Forests, RSF) 是由 Leo Breiman 的随机森林算法延伸而来的集成学习方法,专为处理含删失数据(censored data)的生存分析任务而设计。传统随机森林通过多棵决策树的投票预测分类或回归结果,而RSF的每棵树在分裂节点时以最大化子节点之间的生存差异(通常使用对数秩检验统计量)为准则,最终每棵树输出一条累积风险函数(cumulative hazard function),所有树的平均值即为集成预测。RSF天然能处理高维特征、非线性关系和特征交互,不需要对生存时间分布做参数假设(如Cox模型的等比例风险假设),因此在真实世界肿瘤数据集上往往表现优异,是近年生存预测竞赛和临床研究中的基准首选。
删失(censoring) 是生存分析中的核心概念,指在研究结束或患者失联时,目标事件(如死亡)尚未发生,我们只知道该患者在某时间点之前仍存活,而非确切的事件时间。正确处理删失数据是生存分析区别于普通回归的根本所在,cMAE(删失平均绝对误差)正是在传统MAE基础上对删失样本做了统计校正,使评估更加公平。
关键发现:准得出人意料,但区分能力不足
结果可以拆成「惊喜」与「隐忧」两个方面。
惊喜:cMAE表现极具竞争力
前沿LLM在个体生存时间预测上的cMAE表现令人意外地出色。文中以 GPT-5.6-Sol 为例,它在多种癌症类型上的cMAE与专门训练的SOTA级RSF模型相差在10%以内;在MSK-CHORD的前列腺癌预测中,LLM的cMAE甚至低于RSF,也就是说预测误差更小。
更有意思的是,特征消融显示LLM在给临床变量排序优先级时,与专业生存模型的侧重点高度相似。这意味着模型并非在「瞎猜」,而是确实抓住了与预后相关的核心临床因素。
隐忧:风险分层能力弱
然而硬币的另一面同样明显。LLM在不同癌症类型、不同机构之间的表现并不稳定,一致性参差。更关键的是,它对高风险与低风险患者的区分能力较差(c-index偏低)。
这是一个在临床上极其重要的短板。生存预测的价值不仅在于「预测一个大致的生存时长」,更在于能否把一群患者按风险高低排序——哪些人需要更激进的治疗,哪些人可以观察等待。c-index低意味着LLM在这件事上并不可靠。
一致性指数(c-index,又称 Harrell's C-statistic) 是生存分析中衡量模型判别能力的核心指标,可理解为「对于任意两个患者,模型正确判断谁会先发生事件的概率」。c-index = 0.5 代表随机猜测,= 1.0 代表完美排序。在临床实践中,c-index 低于 0.6 通常被认为判别能力不足。风险分层之所以重要,是因为肿瘤科的核心决策往往是比较性的:同样是肺癌3期,不同分子亚型、不同体能状态的患者预后可能相差数倍,治疗方案也截然不同。一个只能给出「平均生存期约18个月」但无法区分高低风险个体的模型,在个体化医疗场景下价值十分有限。这也是为什么研究者同时报告 cMAE 和 c-index 两项指标——前者考察预测值的绝对精度,后者考察相对排序能力,二者共同构成对模型实用性的完整评估。
对临床应用意味着什么
这项研究传递的信号相当微妙。一方面,它证明了零样本LLM在没有任何专项训练的情况下,就能生成令人惊讶的准确预后估计,这为医学AI的可及性打开了想象空间——患者和基层医生或许能借此获得初步参考。
另一方面,模型跨癌种、跨机构表现的不稳定性,以及薄弱的风险区分能力,构成了其临床落地的重要障碍。把一个「平均误差小但分层能力差」的工具直接用于患者决策,风险显而易见。
论文标题中的「Approximate(近似)」一词用得恰到好处:LLM是一个近似的生存估计器。它能给出方向大致正确的数字,却尚不足以替代经过严格训练与验证的专业模型。对于关心AI医疗边界的从业者而言,这项工作既是一次鼓舞,也是一记提醒。
相关推荐

只想要一个自定义域名邮箱,为何如此艰难?
拥有一个自定义域名邮箱看似简单,实则涉及 SPF/DKIM/DMARC 配置、IP 信誉、托管服务成本等诸多难题。本文梳理自建与托管方案的权衡,并给出实用建议。

Claude意外帮用户发现燃气泄漏:AI助手的安全应用边界
一位Reddit用户借助AI助手Claude识别出家中燃气泄漏隐患,PG&E上门确认并修复。本文分析AI助手在家庭安全场景中的真实价值与使用边界,以及处理燃气泄漏的正确做法。

Gemini 4 Argon发布:谷歌重返前沿,但故事没那么简单
谷歌时隔半年发布前沿模型Gemini 4 Argon,跑分重返一线却暂不开放。本文解析其基准表现、与Sonnet 5.5的竞争,以及模型能力与产品体验之争。