Gemini 4 Argon发布:谷歌重返前沿,但故事没那么简单

谷歌时隔六个月发布Gemini 4 Argon,跑分亮眼却不对公众开放,AI竞赛已从模型能力转向模型+harness+产品体验的综合角力。
谷歌发布了六个多月来的首个前沿模型Gemini 4 Argon,在VALS知识工作、DeepSui编程等多项基准上刷新SOTA,并在法律智能体任务上以三倍优势领先竞争对手,显示出显著的追赶势头。但该模型以网络安全为由暂不向公众开放,且在FrontierSui和TerminalBench等编程基准上仍落后Opus 5.5等对手;加之历史上"跑分优异、落地欠佳"的前车之鉴,社区反应分歧明显。与此同时,Anthropic推出的Sonnet 5.5在编程基准上表现突出,但实测token消耗远超预期,成本优势存疑。更深层的趋势是:AI竞赛的核心已从单纯的模型智能,转向模型与编程harness、个人智能体产品体验的综合组合——谷歌在这一新维度上仍在补课。
进入2026年,谷歌在AI竞赛中的处境曾一度令人乐观。DeepMind内部的诸多问题得到解决,Gemini系列模型保持竞争力,加上谷歌在消费端分发、数据等方面的天然优势,不少人看好它成为头部竞争者。但随后「vibe coding」浪潮兴起,编程能力的跃升叠加Claude Code、Codex等新型harness的威力,让智能体(agent)能力以前所未有的方式释放。谷歌突然发现自己落在了后面。
客气点说,谷歌在2026年的大部分时间里一直在追赶;不客气地说,它基本被排除在了「顶级模型实验室」的讨论之外。本周,谷歌发布了六个多月来的首个前沿模型——Gemini 4 Argon。从跑分看,谷歌似乎「王者归来」。但这真是全部真相吗?
Gemini 4 Argon:跑分亮眼,访问受限
谷歌的2026年困境已被充分记录。我们从未见到Gemini 3.5 Pro——公司认为它不够好,干脆放弃发布。而本周亮相的Gemini 4 Argon,确实在多项基准上拿下了最新的state-of-the-art。
在智能体知识工作方面,Gemini 4在VALS指数上拿到68.9%,击败Fable 5.1、GPT-6 Astra,并超过当前领先者Opus 5.5几个百分点。在AutomationBench和VALS FinanceAgent上的领先幅度更大。Harvey的LegalAgent基准上,Gemini 4以19.6%的成绩,是当前领先者Fable 5.1的三倍多。

智能体编程的表现则参差不齐。在DeepSui上它以77.9%刷新纪录(Opus 5.5为74.2%),但在FrontierSui上仅55%,落后当前领先者Astra 6达10分;在TerminalBench 4.0上以57.4%垫底,落后Opus 5.5约9分。
这里可以有两种解读:编程是最重要的用例之一,没能拿到最高分确实是问题;但换个角度,这对谷歌而言是巨大进步——编程曾是Gemini过去一年最大的短板,如今能与前沿模型同台,已属不易。
VALS指数(Verified Agent Leaderboard Score)是由第三方评测机构设计的、专门衡量AI模型在真实知识工作场景下完成智能体任务能力的综合基准,涵盖法律、金融、研究等垂直领域的多步骤自主任务完成率。与传统的问答或代码生成基准不同,VALS要求模型在较长时间窗口内连续调用工具、处理中间结果并做出决策,更接近现实中"AI员工"的使用场景,因此被业界视为衡量智能体实际落地能力的重要参考。DeepSui和FrontierSui则是针对软件工程自动化的专项基准,前者聚焦于有明确解的代码调试与功能实现,后者侧重开放性工程问题,要求模型在真实代码库中进行多文件修改与架构决策,难度更高、评分标准更严苛,这也解释了为何Gemini 4在两项上的表现出现明显落差。
价格与效率:舒适区外的尴尬
Artificial Analysis证实谷歌重返一线。Gemini 4 Argon在Intelligence Index上得分53,与GPT-6 Astra、Fable 5.1并列第三,落后Sonnet 5.5和Opus 5.5分别3分和5分。
成本上,它在AA基准运行中每任务花费1.99美元,低于Astra的3.26美元和Fable 5.1的7.63美元。但这是谷歌「50%发布折扣」下的价格,折扣期限未公布,全价会让它比Astra更贵。它也处在一个尴尬的中间地带:即便打折,仍比GPT-6 1 Sol贵一倍以上,而基准上又没有明显优势。
更关键的是,谷歌目前并不向公众开放Gemini 4 Argon。官方理由与网络安全有关——该模型在CWE Bench上得分68%,与Grok 4.7、GPT-6 Astra持平。谷歌据此将访问权限限制在所谓「可信网络防御者」范围内,并表示正参与美国政府的自愿测试与预发布访问项目,计划逐步扩大访问,先从API和Google Ultra订阅者开始。
「谷歌回来了」还是又一次跑分幻觉?
发布而不开放,这一选择颇耐人寻味。对老观众来说,这颇有2023年12月谷歌首次落后时急于发布Gemini、而Pro版本数月后才可用的既视感。
不过,社交媒体上确实掀起了一波「Google so back」的热潮。Dr. Daria Anutmaz写道:「谷歌DeepMind带着Gemini 4 Argon回来了,跑分惊人,一举跃至AI前沿顶端。」但他也补了关键一句:「尽快试用Gemini 4。」Ethan Mollick称「又是三方竞赛了」。一向远离炒作的开源模型研究者Nathan Lambert也表示:「更多实验室处于前沿,对消费者(竞争)和世界(权力分散)都是好事。」
反方声音同样尖锐。有用户直言「我们根本用不了这个模型,而且谷歌的跑分一直不可靠,别忘了Gemini 3 Pro的教训」。Ishu Agrawal补充,Gemini 3.1 Pro发布时官方基准号称「全面碾压Opus 4.6」,结果现实并非如此。
谷歌产品负责人Logan Kilpatrick罕见地正面回应:「我们在大规模测试模型方面已经好多了,大多数新Gemini版本在发布前会经过数千名软件工程师数周的测试,希望这能真正缩小跑分与现实的差距。」但彭博社一篇报道《谷歌应对员工对Gemini 4的质疑》指出,模型在员工实际使用中表现不如跑分,尤其在某些编程任务上吃力。谷歌否认了这一说法。
竞争的本质已经改变
谷歌真正的难题在于:它缺席榜首的这段时间里,竞赛的本质已经变了。正如Peter Yang所言,光是模型好已经不够,还需要有竞争力的编程harness(如Antigravity)和个人智能体(如Spark)。
同时,Anthropic推出了Sonnet 5.5。考虑到Opus 5和Sonnet 5此前口碑不佳(后者更贵且极度耗token),人们本有理由质疑。但在Opus 5.5「回归巅峰」之后,Sonnet 5.5似乎延续了这一势头。
Anthropic称Sonnet 5.5比Sonnet 5快30%、便宜30%。在TerminalBench 4.0上它拿到70.6%(Sonnet 5仅10.3%),甚至超过Opus 5.5的66.4%。Artificial Analysis给它56分,排名第二,领先Fable 5.1和GPT-6 Astra。
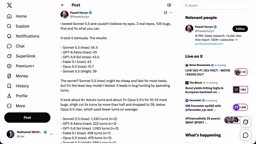
不过成本争议犹存。AA测试发现Sonnet 5.5每任务花费7.60美元,比Opus 5.5贵27%,是GPT-6 Astra的两倍多,token消耗远高于Sonnet 5。开发者Kun Chen的实践结论是:Sonnet适合执行、Opus适合规划有歧义的产品难题,二者并非简单的「便宜版替代」。YouTuber Theo的评价更尖锐——「Sonnet 5.5是个了不起的模型,但你大概不该用它」,因为它在max推理下容易过度思考,而低设置下又没有比Opus更划算的点。
Harness在AI智能体语境中指的是围绕基础模型构建的"脚手架"系统,包括工具调用框架、上下文管理、多步推理编排、错误恢复机制等。Claude Code和Codex本质上都是harness:它们并不只是调用模型生成代码,而是将模型嵌入一个能读写文件、执行终端命令、迭代调试、理解项目结构的完整工作流中。一个强大的harness可以显著放大模型的实际产出——同一个基础模型,配上优秀harness后完成复杂工程任务的成功率可能是裸调用API的数倍。这正是"竞赛本质已经改变"的核心含义:模型能力分差在缩小,harness设计能力和工程集成深度正成为新的差异化战场。谷歌的Antigravity和个人智能体Spark,即是其在这一维度上的补课尝试。
产品体验 vs 模型智能:悬而未决的命题
另一条值得关注的线索是:优秀的用户体验配上非顶级模型,能否打败体验一般但模型顶级的产品?Muse给出了有趣的样本——上线三周多就达到300万周活、100万日活,增长速度甚至快于Codex(约三个月才到300万周活)。
但Eureka联合创始人Sina在用了一段时间后发现「底层模型不够聪明,最近经常出错」,并坦言「作为消费者我不忠于任何产品,谁最好用我就用谁,智能依然是护城河」。而OpenAI的dots发布后,也有用户抱怨其摩擦感太强——「它想帮你在ChatGPT和Codex里管理工作,却没有足够的工具和数据访问权限」。
DoorDash本周也宣布其AI智能体可通过短信接单,复制了Muse式的个人智能体体验。结合亚马逊封杀Muse智能体的决定,一个大问题浮现:最佳智能体策略究竟是与品类领导者合作,还是自建平台专属智能体?DoorDash的逻辑清晰——智能体订单的购物篮价值高出50%,自建能掌握用户画像;但风险是外部智能体可能绕过它直接向餐厅下单。目前它两头下注。
回到Gemini 4 Argon,正如Nathan Lambert所说,谷歌表现好对消费者和竞争都是好事。但在我们能真正上手之前,一切评判都只能靠自报的跑分和向彭博社抱怨的员工——这顿饭,还只是桌边的残羹。
背景补充
**Gemini 3 Pro的「教训」**是理解本次社区怀疑情绪的重要背景。2025年初,谷歌发布Gemini 3.1 Pro时,官方基准显示其在推理、代码等多项指标上全面领先Anthropic的Opus 4.6,一度引发"谷歌重返王座"的舆论浪潮。但随后数周内,大量开发者的实测反馈与基准数据产生了显著背离:模型在实际编程任务中频繁出现逻辑跳跃和幻觉,多轮对话的一致性也不尽如人意。这一事件深刻损伤了谷歌在开发者社区中的公信力,并催生了一种固定认知模式——对谷歌模型的官方跑分保持系统性折扣。Logan Kilpatrick所提到的"数千名软件工程师数周测试",正是针对这一历史污点的直接回应。
相关推荐

腾讯WorkBuddy入门:从AI提问者到AI管理者
腾讯WorkBuddy是一款零配置的桌面AI智能体,能直接操作本地电脑并深度打通飞书、企业微信等国内办公软件。本文梳理其核心用法、与Codex的差异、省积分技巧及三大新手认知误区,帮你从AI提问者进化为AI管理者。

10个开源利器,让AI Agent不再"翻车"的实战清单
海外博主盘点10个开源AI Agent工具,从Unreal Agent运行时、JSON Render界面约束到Bend编译器级规则证明,解析如何用工程手段让AI Agent在真实场景不再翻车。
CUA+Claude打造自主桌面AI智能体:Python全流程实战
手把手教你用开源库 CUA(Computer Use Agent)结合 Claude Sonnet 模型,用 Python 打造一个能看屏幕、点鼠标、自主完成网页调研与推文起草的桌面 AI 智能体,附核心代码流程拆解。