单步99%准确的浏览器Agent,百步后为何只剩36%成功率?

浏览器Agent生产化的核心挑战:成本连续累积而价值只在终点兑现,工程手段才能打破概率困局。
BrowserBase工程师Derek Megan在AI Engineer大会上揭示了浏览器Agent落地生产的核心矛盾:轨迹中每一步都在累积成本和失败风险,但价值只有在任务全部完成后才能实现,没有部分得分。单步99%的成功率在100步任务下整体成功率仅约36%,这一指数衰减效应让"高精度Agent"在现实中远不可靠。解法并非放弃Agent,而是重新定义成功衡量方式(允许重试、按事务计算)、并通过工具封装、确定性验证、剥离稳定逻辑、以及用"技能"约束关键路径等工程手段,把不该由模型承担的步骤从模型职责中移除,在减少步数的同时提升每步成功率,最终实现可靠的生产级交付。
跑一次浏览器Agent的Demo很容易——单个网站、单次运行、风和日丽的一天,你盯着屏幕、祈祷它别出错。但生产环境完全是另一回事:成千上万次无人值守的运行,网站随时可能改版,模型也会有状态不佳的时候。BrowserBase软件工程师Derek Megan在AI Engineer大会的分享,直指一个被很多人忽视的核心矛盾——成本持续累积,而价值只在终点实现。
浏览器Agent到底如何与网页交互
把模型的输出理解成一个概率分布会更清晰:输入token代表页面状态、总目标以及已执行的步骤,模型在可能的动作分布中选出最可能的一个,再把它转译成结构化的工具调用,最终确定性地在浏览器中执行。
但浏览器的接口本身非常复杂,它由多层构成:进出浏览器的网络请求、DOM(HTML页面表示)、页面截图、可访问性树(页面的语义文本表示),以及存储、cookie、控制台、URL、标签页等浏览器状态。底层还有一个代码执行运行时,可以通过任意JavaScript或CDP与浏览器交互。
行业里把这些层级串起来主要有三种策略:第一种是构建浏览器的文本表示,通常把HTML状态和可访问性树混合成一个表示;第二种是computer use,用一系列页面截图来表示浏览器;第三种越来越流行,叫做de-harnessing(去工具化),移除定制工具,转而让Agent在动态执行环境中针对浏览器编写任意代码。实践中大多数生产系统依赖前两种或它们的组合。
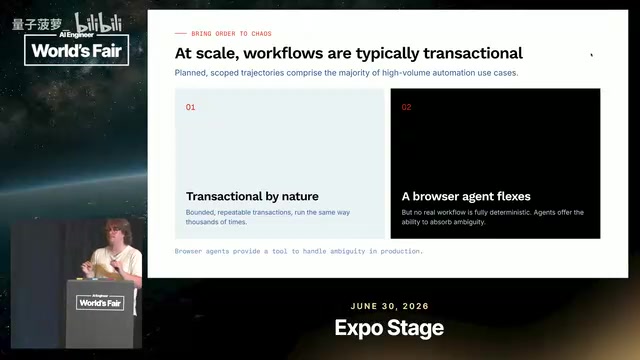
Derek还按"agent化程度"把浏览器轨迹分成三类:一端是为单一任务特制的目的化浏览器轨迹;另一端是最具agent化的即时浏览器自动化,事先不知道任务是什么,由用户临时给出;中间地带则是把浏览器当作实现细节、服务于更大目标,比如深度研究或竞品分析。规模化场景里,他特别聚焦于事务型工作流——不是因为它简单,而是因为这正是大规模落地中最常见的形态。
可访问性树(Accessibility Tree) 是浏览器为辅助技术(如屏幕阅读器)暴露的页面语义结构,它将DOM中的视觉元素转化为带有角色(role)、名称(name)、状态(state)等属性的树形节点。与原始HTML相比,可访问性树过滤掉了大量纯样式信息,保留了对"页面在做什么"的语义描述,因此更适合作为模型的输入——token更少、信噪比更高。CDP(Chrome DevTools Protocol) 则是Chrome/Chromium提供的底层控制协议,Puppeteer、Playwright等自动化库都构建在它之上,允许程序直接操控标签页、拦截网络请求、注入JavaScript,是浏览器Agent与浏览器内核沟通的"原语"层。理解这两层有助于把握为何浏览器接口的复杂性远超普通Web API:Agent需要同时处理视觉、语义、网络、存储等多个异构信号。
为什么在生产环境如此之难
难点可以归结为一个关键的交互关系:成本的累积是连续的,而价值的实现是终端的。轨迹中的每一步都在产生增量成本,也在叠加增量的失败风险,但只有当任务的所有步骤全部完成,你才能从这条轨迹中获得价值。换句话说,浏览器Agent没有部分得分——绝大多数网页自动化都属于这一类。
这里有一个发人深省的思想实验:假设你的浏览器Agent每一步的独立成功率高达99%,听起来非常可靠。但如果一条轨迹要跨越100步,整体成功率会跌到约36%,大约只有三分之一的时间能跑通。这显然算不上好,更谈不上为客户在生产中交付可靠结果。
照这个逻辑推下去,成本持续累积、风险持续累积、而价值实现的概率又极低,似乎在暗示:永远别用浏览器Agent。但Derek强调,这个动态是真实的,数学却不是故事的全部——是时候退一步,重新思考Agent究竟如何创造价值。
这里的数学本质是复合概率的指数衰减。若每步独立成功率为 p,n 步轨迹的整体成功率为 p^n。p=0.99、n=100 时,0.99^100 ≈ 0.366;若 p 降至 0.95,同样100步的成功率就跌到约 0.006,几乎不可用。这一特性在任何需要多步骤全部成功的系统中都会出现,数据库事务、分布式Saga模式等领域早有类似讨论。浏览器Agent的特殊之处在于:步数通常由任务本身决定,难以在不改变任务语义的前提下随意压缩;且每步的失败模式高度异构(网络超时、元素定位失败、模型幻觉、反爬拦截……),难以用单一容错机制覆盖。因此提升单步成功率和减少总步数,是两条同等重要却机制完全不同的优化路径。
重新定义价值:利润 = 收入 − 成本
Derek抛出一个被很多人低估的朴素公式:利润 = 收入 − 成本。它的含义是,你的Agent只是财务报表上的又一个条目,它给你的应当多于它向你索取的。
那么浏览器Agent到底给了你什么?从BrowserBase客户的视角看,他们往往不是为自己自动化网页,而是代表他们的客户在网页上执行操作。所以一个浏览器Agent真正交付的,是"反复为你的客户完成某个任务"——而且是在环境不变时每次都能完成。
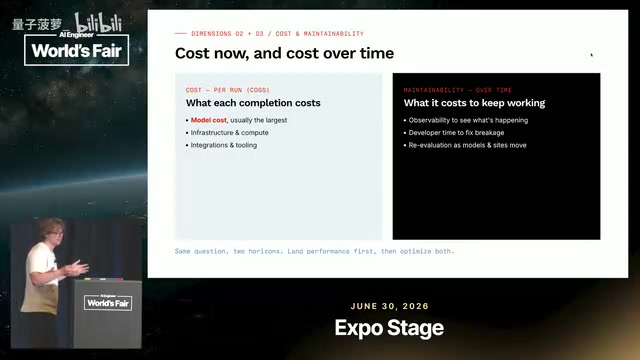
衡量Agent好坏可以从三个维度展开,并按重要性排序:
- 性能(Performance):首要的成功度量。一旦确认Agent能完成任务,成本和可维护性就只是优化问题了——而优化问题可以用工程手段解决。
- 成本(Cost):分为单次运行成本(当下主要是模型成本)、基础设施与计算、额外的集成和工具。随着开源模型带来的降价压力,模型成本在整体中的占比会越来越小。
- 可维护性(Maintainability):包括可观测性投入、开发者时间,以及随问题变化而进行的重新评估。
关于成功的衡量,Derek提出两个关键原则。其一,成功应当是运行留下的具体产物:付账单对应确认邮件,下订单对应订单ID或收据,提交表单对应系统里一条可被确定性查询的新记录。其二,不要按单次运行衡量成功率,而要允许重试、按事务衡量。假设Agent单次成功率只有50%,但如果允许一次事务最多重试4次,单事务成功率会迅速攀升到约94%。客户并不关心你重试了几次,只关心工作流是否被可靠地完成。
让模型只做它该做的事
既然性能达标后一切都是优化问题,Derek用一个真实案例演示了如何把成功率拉上来——自动化一个健康保险门户,目标是登录并下载"福利说明"(EOB)文档。每一步架构改动都应撬动成本、性能、可维护性三个杠杆之一。
从最朴素的Agent开始:请求进来,Agent在浏览器上执行动作,这是能"做点事"的最小系统。
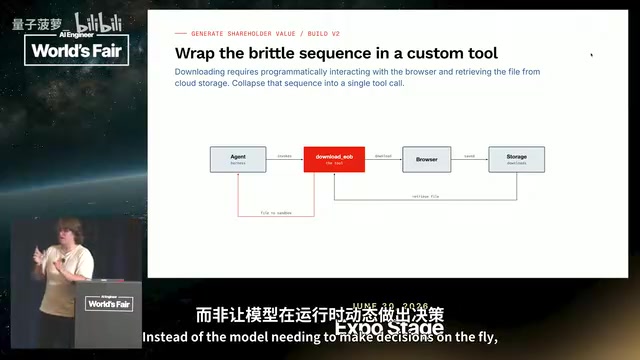
封装复杂操作为单一工具:下载EOB涉及程序化地操作页面,并把下载后的文件从存储取回到Agent运行时。与其让模型临场决策,不如把这一整套复杂操作封装成一次工具调用。
给Agent实时验证能力:再加一个OCR工具,确定性地从文档中抽取实体,并与记录系统(system of record)比对。这样Agent就拥有了一个确定性机制,能真正知道自己有没有把活干对。
把稳定逻辑从模型中剥离:门户的业务逻辑可能有歧义,但认证流程几乎从不变化。把认证逻辑从模型的职责中抽出来做成独立函数,不仅减少了Agent要走的步数,还能在同一门户的多个业务流程间复用——更低的单位成本、更高的性能、更易维护。
用"技能"约束关键路径:最后,把Agent的职责收缩到真正有歧义的区域,并起草一份"技能"(skill)。它很像过去给人类用的标准作业流程(SOP),只不过这份SOP是给Agent用的。回到开篇的概率分布视角——当Agent知道自己处在第二步、并且技能明确写出需要走第三步时,它采取第三步的概率就更高。歧义被从决策过程中移除。
最终形成了一个相当复杂但高效的系统:请求进来,一个无服务器认证函数先完成浏览器认证,再把浏览器交给Agent运行时;Agent依据技能导航门户,调用确定性下载函数,把文件交给验证工具,从而能权威地判断轨迹成功还是失败。整个系统把那些本不该由模型负责的步骤移出模型职责,减少了步数,却依然达成目标——系统更可维护、更高性能,从而破解了浏览器Agent的"36%困局"。
文中提到的技能(Skill) 概念本质上是一种结构化的上下文注入机制。传统RPA(机器人流程自动化)依赖录制好的确定性脚本,而LLM-based Agent依赖模型在每一步从概率分布中采样动作。"技能"处于两者之间:它不是逐步的硬编码脚本,而是用自然语言或伪代码写成的操作规程,明确告诉Agent"在这个情境下你应该走哪条路径",从而压缩模型在关键节点的动作分布方差。这与提示工程中的"Chain-of-Thought"有相似之处,但更强调流程约束而非推理链条。其效果是把那些"有正确答案但模型未必能自行推断出来"的步骤变成近似确定性的执行,同时保留模型处理真正歧义情况的灵活性——这正是在不退回全硬编码脚本的前提下提升成功率的关键工程手段。
别忘了那些会"反扑"的风险因素
即便搭好了系统,这些指标在时间维度上的持久性仍面临几类风险:环境会反击(反爬虫机制,网页对Agent并不友好);任务会变化(底层工作在Agent脚下悄然改变);更好的方法会出现(今天在自动化的网站,明天可能推出API——不过对多数用例而言API短期内不会到来);以及模型会跑偏(本身的不确定性让它未必每次都走关键路径)。好在其中几项会随着模型能力提升而缓解,更强的模型更能理解用户意图、在出错时自我纠正。
Derek最后半开玩笑地总结:欢迎来到生产环境,恭喜——现在你开始on-call了。这句话道出了浏览器Agent工程化的真相:Demo到生产之间,隔着的是对概率、成本与风险的系统性工程治理。
相关推荐

Harness架构实战:企业级智能体项目拆解与AI岗位进阶指南
深度拆解基于Harness(驾驭工程)架构的企业级智能体实战项目,涵盖多模型配置、ASGI部署、MCP协议对接ERP系统、Sandbox沙箱隔离等核心模块,帮助AI大模型求职者理解工程化落地方向的面试要点。

fal.ai API密钥配置与n8n集成完整教程
手把手教你创建 fal.ai API 密钥并连接到 n8n:涵盖官方集成节点配置、凭证保存、HTTP 请求替代方案以及密钥安全注意事项,快速跑通首次 AI 媒体生成工作流。

系统设计面试笔记开源项目:2.4万星的学习利器
开源项目 liquidslr/system-design-notes 整理了经典书籍《System Design Interview》的学习笔记,GitHub 收获 2.4 万 Star。本文解析其内容价值、适用人群及系统设计面试复习建议。