单个神经元竟同时识别猫和车?我们复现后发现了新解释

复现「猫车神经元」发现其真正区分的是尖与圆,而非猫和车。
文章围绕2017年走红的「猫车神经元」展开。该神经元曾被视为神经网络内部混乱、不可理解的证据,并用「叠加」假说解释。2025年10月,当年论文作者之一Cammarata发表长文,提出新解释:特征可视化方法本身偏好动物脸部等易得高分路径,该神经元真正区分的是「尖」与「圆」,并从核心概念向外生长。作者亲自在Inception V1上复现,用未优化过的形状、照片和同种动物对比,发现尖对圆的解释在多数情况下成立,但不适用于汽车,且该神经元并非特例。关闭该神经元对最终分类几乎无影响。文章进一步指出,语言模型可解释性上Anthropic与Goodfire结论分歧明显,负面方向可能携带更多信息,呼吁同模型同方法的公开对比。
单个神经元竟同时识别猫和车?我们复现后发现了新解释
一个神经元,既对猫脸敏感,又对汽车前脸有反应。这个被称为「猫车神经元」的案例,多年来被当作神经网络内部混乱、不可理解的典型证据。2025年10月,当年让这个神经元出名的研究者之一发表长文,承认自己可能误读了它。我们决定亲自复现实验,看看真相到底如何。
一个神经元为何让人不安
2017年,Google的研究者Chris Olah、Alexander Mordvintsev和Ludwig Schubert展示了一种方法:从随机噪声出发,反复微调像素,让某个神经元的激活值不断升高。最终生成的图像里,出现了猫脸、狐狸脸,还有汽车前脸。
这个神经元后来被写进OpenAI 2020年的网络映射指南,被描述为对「猫脸、汽车前脸和猫腿」有反应。2021年的一篇后续论文甚至用四个词概括它:「genuinely, or cat, car」。
这种「一个部件同时承载两个不相关概念」的现象,被用「叠加」(superposition)来解释:网络容量有限,而世界上的事物太多,不相关的东西如果很少同时出现,就可以共享同一个神经元,偶尔混淆的代价可以接受。2022年,Anthropic用小规模网络验证了叠加确实存在,但对于大型真实网络,论文措辞谨慎——证据只是「与叠加一致」。
问题在于,如果单个神经元已经是一团乱麻,理解整个模型似乎毫无希望。Anthropic CEO Dario Amodei在2025年写道,人们常常对「我们并不理解自己创造的AI如何工作」感到震惊。
特征可视化(feature visualization) 是神经网络可解释性研究中的一类技术,核心思路是固定网络参数,把输入图像当作可优化变量,通过梯度上升调整像素,使目标神经元的激活值最大化。2017年Olah等人系统化的方法通常还会加入正则项(如频率惩罚、变换鲁棒性),以避免生成对抗样本式的噪声。这类方法生成的图像并非神经元「存储」的模板,而是「最容易激活它的输入」的一种示意;优化路径、正则化选择和初始噪声都会影响结果。因此,把生成图直接等同于神经元语义,是该方法最常见的误读风险之一。
Inception V1(GoogLeNet) 是2014年ImageNet竞赛的冠军网络,也是可解释性研究中最常被剖析的公开模型之一。它引入了Inception模块(并行多尺度卷积)和1×1卷积降维,深度约22层。本文所说的「该层832个神经元」,通常指网络中某个特定卷积层的通道数;在卷积网络里,每个通道可被粗略视为一个「特征检测器」,这也是「单个神经元」讨论的物理基础。选择它做复现,正是因为权重公开、结构相对简单、历史研究积累多。
叠加(superposition) 是解释「一个神经元响应多个概念」的主流假说:当需要表示的特征数量超过可用神经元维度时,网络可以把多个近似正交(很少同时出现)的特征方向压缩进同一组神经元,代价是偶尔的干扰。Anthropic 2022年的玩具模型实验表明,在特征稀疏的条件下,模型确实会自发形成这种压缩表示。但需要注意,叠加描述的是表示几何层面的现象,并不直接规定单个神经元的语义一定是「混乱」的;一个神经元也可能是在编码某个更抽象、更底层的区分维度(如本文的「尖对圆」),从而在表面上同时响应猫脸和车头。区分「叠加导致的混合」与「抽象特征的自然泛化」,是这场争论的关键。
重新解读:不是猫和车,而是「尖」与「圆」
2025年10月,Nick Cammarata——当年OpenAI那篇论文的共同作者——通过可解释性公司Goodfire发表了一篇长文,称之为「工作假说」。文章未经同行评审,其中很大一部分是在拆解自己早期的论文。
他的核心论点从图像生成方法本身开始。这个方法只有一条指令:用最容易的路径把激活值推高。在图像网络深处,Cammarata认为,最容易的路径经过动物脸部。按照这个解读,胡须不是神经元「想要猫」的证据,而是猫是「容易得高分」的路径。
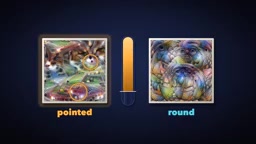
第二个关键动作是观察什么会压低神经元,而不仅仅是推高它。他们生成了一张用于压低该神经元激活的图像,结果是圆润、扁平的脸。这样看来,这个神经元既不是猫神经元,也不是车神经元;它只做一个区分:尖对圆。长而尖的口鼻和逐渐收窄的车头,落在同一边。
Cammarata进一步认为,这类神经元是从一个核心概念向外生长出来的,而不是被塞进不相关的概念。他承认网络需要表示的东西多于神经元数量,但质疑「打包」的具体形式。
我们动手验证:尖 vs 圆,成立吗?
因为Inception V1是公开模型,这个假设可以检验。我们喂给网络一些图像生成过程从未接触过的输入。
先看平面形状:V形箭头和三角形,对比圆环和圆盘,覆盖多种尺寸、角度和颜色。在每一个尺寸、每一个角度、每一种颜色下,尖的形状平均得分都更高。随机各取一个,尖的形状胜出约84次/100。有些黑色圆环甚至把激活值压到零以下。
再看Wikimedia Commons上的照片——每组约十几张,既不是猫也不是车。尖的物体(高铁车头、箭头、纸飞机)胜过圆的物体(时钟、橙子、肥皂泡)。最接近的对比在同一动物内部:九张长口鼻的狗(如博美和杜宾)对四张扁脸斗牛犬,随机各取一张,长口鼻的狗胜出近九成。
所以,在没有人优化过的输入上,重新解读站得住脚。但并非处处成立。
它并不专门对应V形——菱形和平面十字也能强烈激活该神经元。在简单形状上,「角对平滑曲线」比「V形」拟合得更好。这也不罕见:我们在该层全部832个神经元上跑同样的尖对圆对比,约有100个神经元比它更偏好尖的东西。
汽车类则不符合。楔形的兰博基尼Countach应该胜过形似面包的菲亚特500,但在九辆楔形车和八辆圆润车的对比中,楔形车只赢了一半。圆润车的平均激活甚至更高,测试中最强的车是菲亚特500。
连线与消融:部分细节吻合,但整体影响有限
文章有一部分与实验吻合:连线。在馈入该神经元的528个通道中,权重最大的那个通道,其生成图像正是狐狸和猫的鼻吻部。
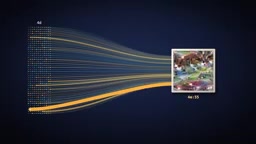
然后我们把这个神经元关掉。在猫脸和狐狸脸上,下一层中「火焰和狐狸脸」神经元的响应下降了约15%,超过该层任何其他神经元对它的影响。但在我们测试的75张照片中,网络的最终答案没有一张发生改变。
真正的分歧:语言模型上两派各执一词
这一切并不能解决更大的问题。人们真正担心的是语言模型,而不是2014年的照片分类器。而反方有严肃论据。
先看小激活值。神经元最强响应中的模式,不能说明它较弱活动意味着什么。2025年,Anthropic发现,在其模型中,神经元最大的读数通常可读,小的读数则不可读;丢弃小读数对模型的损害,比换入Anthropic自己的翻译网络还要明显。Goodfire则在其模型上报告了相反结果:在图像网络中丢弃最小的四分之三读数,准确率只从72%降到71%。不同模型、不同测量方法,而且我们没有找到在同一模型上的公开对比。
翻译网络还揭示了另一层复杂性。2024年,Anthropic用稀疏自编码器从其Claude 3 Sonnet模型中提取了数百万个独立「特征」,其中约五分之四经检查并未被任何单个神经元紧密追踪。Goodfire的招牌数字也尚在早期:在对开源聊天机器人Qwen3-32B的未发表审计中,它报告约90%的神经元方向(升或降)各司其职,但这个比例会随划线位置变化。
利益关系也需考虑:Goodfire销售可解释性工具,Anthropic在2025年投资了Goodfire,三名Anthropic研究者对文章提供了反馈——但这不等于认同。
稀疏自编码器(Sparse Autoencoder, SAE) 是近年兴起的特征提取工具:它把模型内部的高维激活向量,通过一个过完备的瓶颈层重建,并施加稀疏惩罚,迫使每个隐单元只在少数输入上激活,从而得到比单个神经元更「单义」的特征方向。Anthropic 2024年在Claude 3 Sonnet上提取了数百万个这样的特征,发现多数特征并不与任何单个神经元一一对应,这支持了「神经元不是可靠语义单元」的观点。但SAE本身也有局限:特征是否单义依赖稀疏系数和字典大小的选择,重建误差可能丢失信息,不同团队训练的SAE可比性也有限。因此,SAE的结论与「直接读单个神经元」的结论并非在同一层面上竞争,而是代表了两种不同的分解粒度。
关闭「负面」神经元:一个耐人寻味的测试
Goodfire给Qwen3-32B出了一个谜题:饼干被吃了,牛奶没了,烟囱下有煤灰,有人听到雪橇铃响。谁干的?模型给出圣诞老人99.7%的概率。关掉20个自动标签为「圣诞」或「圣诞老人」的神经元——那些显而易见的——概率只降到76%。
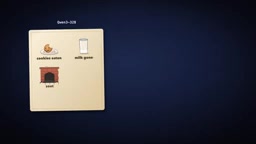
另一项测试中,他们关掉八个「负面」响应圣诞老人的神经元。如果下降方向承载了部分信息, silencing它们应该造成伤害。确实如此:圣诞老人的概率跌到约6%,模型开始怪罪家里的宠物。换成关掉八个随机神经元,概率仍高于99%。这只是一次未发表审计中的一个提示,但如果成立,显而易见的标签错过了最强的控制杆,而看「负面」方向找到了它。
回到那张图:显微镜需要先校准
以「尖对圆」而非「猫和车」来读那张图,大部分内容说得通。但它仍然解释不了菲亚特500。而且,2014年网络中的一个神经元,并不能为人们真正担心的模型下结论。
一个有用的下一步测试很容易描述:在同一个模型上,用同一种测量方法,同时运行Anthropic和Goodfire的对比,并公开结果。如果Cammarata是对的,逐神经元直接阅读模型的理由会强得多;如果不对,那些小读数值得更多关注。
无论结果如何,这个神经元已经证明了一点:在判定一台机器是乱麻之前,先检查你的显微镜。
相关推荐

房产经纪人用AI提效的5个实操方法(2026版)
房产经纪人如何用AI提效?结合YouTube实操演示,拆解ChatGPT写房源描述、Canva做营销物料、表单管理开放日线索、Zapier自动跟进、卖家面谈准备5个方法,并提示公平住房法规、照片真实性与定价核实等风险边界。

Grok Bot vs ChatGPT Agent:两大AI代理谁更强?
Grok Bot 与 ChatGPT Agent 有何区别?本文对比两者的工作方式:Grok Bot 拥有云端计算机、可常驻工具内自动执行多步任务;ChatGPT Agent 在浏览器中操作网页,通用任务更成熟。附选型建议。

Walmart Agent Gateway:AI帮你自动购物,亚马逊为何反其道而行?
沃尔玛推出Agent Gateway,允许ChatGPT、Gemini等AI助手直接接入商品库替用户搜索比价加购,并设消费限额与逐笔审批三道安全阀。亚马逊则封堵外部AI代理,两大零售巨头走向相反路线。功能目前仅限美国,印度市场或随后跟进。