单卡7900XTX跑125B大模型:Avalon与Strata实测对决
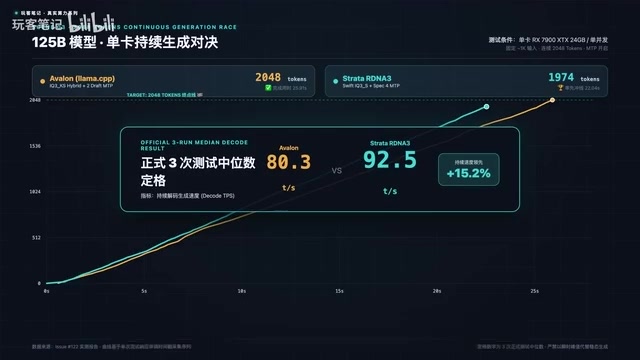
单张24GB RX 7900XTX实测跑125B模型,Strata与Avalon两套AMD优化引擎正面对决。
文章记录了一场在消费级硬件上的真机实测:锐龙3700X加96GB DDR4内存、单张24GB RX 7900XTX,运行125B千亿参数模型,对比Avalon与Strata RDNA3两套针对AMD优化的推理引擎。持续生成环节Strata以92.5 token/s领先Avalon的80.3 token/s约15.2%;在约25万Token超长上下文下,Strata预填充吞吐达3190 token/s,是Avalon的1.92倍,首字等待从156秒降至81秒。但真实业务场景出现反转:长文档抽取与64K大海捞针任务Strata更快,编程任务Avalon却以20.79秒反超。差异根源在于显存调度路线不同——Avalon走专家缓存按需调度,Strata用HostDMA置换KVCache并重构AMD矩阵算子。
一张消费级显卡,能否扛住千亿参数模型?
过去很多人认为,单张24GB显存的消费级显卡跑125B级别的千亿参数模型,不是显存直接被爆掉,就是慢得像幻灯片。但最近一场真机实测打破了这种刻板印象:在完全相同的硬件平台上,两套专门针对AMD优化的推理引擎——Avalon(阿布朗)和Strata——展开了一场硬碰硬的性能对决。生成速度不仅冲到了每秒92.5个token,在处理超长文本时,两者的首字等待时间和预填充吞吐差距甚至逼近整整一倍。
这不是同等量化条件下的空谈,而是两套完整工程优化路线的正面碰撞。对于想在本地榨干AMD显卡潜能的用户来说,这场测试提供了相当有参考价值的实战数据。
测试平台与参赛选手
平民测试台配置
测试平台相当接地气:老款锐龙3700X CPU(连AVX512都不支持),搭配大约96GB的DDR4内存,主力计算只靠一张24GB显存的RX 7900XTX。系统为Windows,驱动锁定在官方ROCm版本。这套配置没有任何服务器级别的加持,就是普通玩家能凑出来的组合。
两套优化引擎的核心差异
左边参赛选手是Avalon,采用专用优化的IQ3KS混合量化模型,配合两步MTP推测解码。右边则是Strata RDNA3,搭载Swift IQ3S量化,搭配四步推测解码,以及针对AMD架构深度重构的矩阵算子。
要特别强调,两套引擎跑的都是各自官方验证过的最高性能配置,全程单卡运行、单并发、默认拉满MTP。这意味着对比的不是某个孤立参数,而是两种完整工程思路的极限表现。
IQ3KS / IQ3S 量化:这类命名属于 GGUF 生态中的 k-quant 系列,数字 3 表示权重平均约 3 bit,后缀 i 通常代表「important」(对部分重要张量保留更高精度),S/K 表示不同规模的混合方案。125B 参数按 3 bit 存储约需 45–48GB,远超 24GB 显存,因此必须配合专家卸载或 KVCache 置换才能运行。
MTP 推测解码:Multi-Token Prediction 是多步推测解码的统称,由一个小型草稿头或额外预测层一次提出多个候选 token,再由主模型并行校验,命中即一次性接受。两步、四步指每轮提议的候选数,步数越多理论加速越高,但校验失败的回退开销也越大。
第一轮:持续生成速度较量
测试给两套引擎投入完全一致的提示词,要求一口气连续生成2048个Token,每套方案正式联测三轮全部取中位数,以排除偶然性。
测试一开始两边就咬得非常紧。Avalon跑出了每秒80.3个Token的好成绩——在一张单卡上跑125B模型,这个速度日常使用已经相当丝滑。但Strata的表现更让人眼前一亮,持续生成速度直接达到每秒92.5个Token,领先了整整15.2%。
这里要注意,这不是瞬间冲顶的假峰值,而是2048个Token连续输出的稳定成绩。日常闲聊可能觉得差别不大,但当你需要本地模型写长篇代码、或者生成大型技术文档时,这15%的持续提速省下的就是实打实的生产力时间。
第二轮:超长上下文压力测试
难度直接飙升。测试将输入长度从32K、64K、128K一路推到接近256K的极限,也就是约25万Token。
生成速度:差距开始拉大
在超长上下文下,Avalon的解码速度从每秒71个Token逐步下滑到59.5个Token,而Strata凭借更强的显存调度,在约25万Token的超大负载下依然稳稳维持在每秒83.1个Token。
预填充吞吐:真正的代差所在
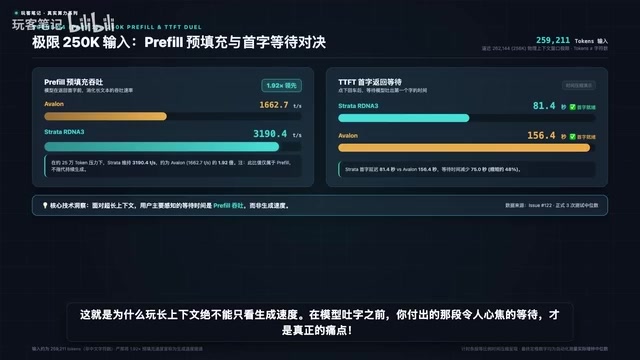
但真正把两款引擎拉开代差的,还不是生成速度,而是Pre-Fill——模型在吐出第一个字之前消化庞大输入的速度。在约25万Token的高压下,Avalon每秒处理1663个Token,而Strata狂飙到了3190个,差距达到惊人的1.92倍。
数字不直观,直接看首字等待时间:面对同样约25万Token的超长文本,Avalon需要干等两分半钟(整整156秒),首字才会跳出来;而Strata只要81秒,等待时间直接缩短了一大半。这就是为什么玩长上下文绝不能只看生成速度——在模型吐字之前那段令人心焦的等待,才是真正的痛点。
前两场比下来,Strata似乎已经稳操胜券。但跑分高不等于好用,真实干活能不能搞定才是王道。
Pre-Fill 与首字等待(TTFT):自回归推理分两阶段——预填充阶段把整段输入一次性做前向计算、建立 KVCache,此阶段是计算密集型、高度并行;解码阶段逐 token 生成,是显存带宽密集型。首字等待时间几乎完全由预填充耗时决定,其吞吐常以 token/s 计。上下文越长,预填充计算量按长度近似平方增长(注意力部分),因此 25 万 Token 下预填充能力比解码速度更能决定可用性。
第三轮:真实业务场景考核
测试拉出三套真实业务场景进行考核,结果出现了耐人寻味的反转。
长文档关键事实抽取:两套引擎全都一字不差地精准提取出内部代号和预算。Strata用时7.37秒,Avalon耗时10.94秒,Strata略胜一筹。
64K大海捞针:在长文本开头、正中和末尾埋设的三处绝密信息,两边全都100%精准命中。Strata耗时25.86秒,Avalon耗时38.11秒,依然是Strata更快。
实际编程任务:反转出现。两款引擎编写的线程安全缓存代码在严苛受控环境中,三项自动化单元测试全部一次性通过。但这一次Avalon只用了20.79秒就交卷,而Strata却用了25.04秒。
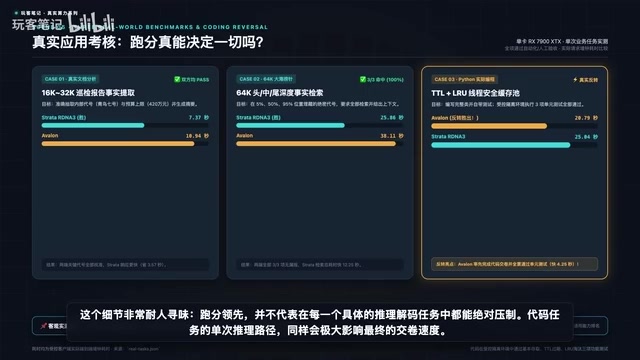
这个细节非常耐人寻味:跑分领先并不代表在每一个具体的推理解码任务中都能绝对压制——代码任务的单次推理路径,同样会极大影响最终的完成速度。
为什么同一张卡表现差这么多?
核心在于125B模型的庞大体积,单张24G显卡无论如何也塞不下。两套引擎选择了不同的化解路径。
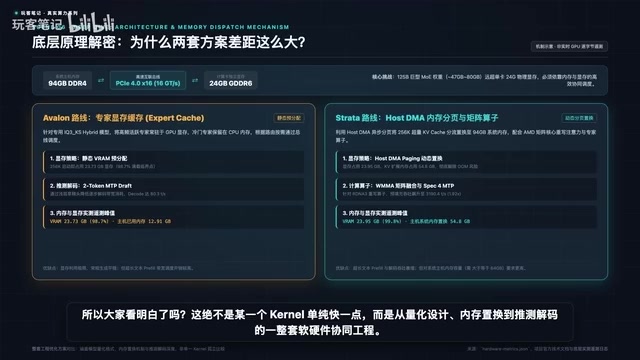
Avalon走的是专家缓存路线:把最常用的部分专家常驻在GPU显存里,其余大量冷门专家留在96G内存中按需调度,再靠两步推测解码来填补显存带宽。
Strata RDNA3则走得更深更激进:利用HostDMA技术将超量KVCache置换进系统内存,彻底解除了256K上下文的显存魔咒;同时针对AMD矩阵核心重构了融合算子,配合四步推测解码,在预填充阶段把硬件算力压榨到了极致。
所以这不是某一个Kernel单纯快一点,而是从量化设计、内存置换到推测解码的一整套软硬件协同工程。两种路线各有取舍,也解释了为什么在某些任务上两者会互有胜负。
MoE 专家缓存 vs. KVCache 置换:125B 级模型多为混合专家(MoE)结构,每次前向只激活部分专家,这给「热专家常驻显存、冷专家留在内存按需换入」提供了空间,代价是换入换出带来的延迟抖动。KVCache 置换则是另一条路径:长上下文下 KVCache 本身可达数十 GB,通过 HostDMA(GPU 直接读写系统内存的零拷贝通道)把它溢出到 DDR4,可突破显存容量上限,但受 PCIe 带宽制约。两条路线分别受制于专家调度命中率与主机内存带宽,这正是不同任务上互有胜负的根源。
结论与选型建议
在这场单张RX 7900XTX跑125B模型、双方各自最佳优化的决战中,Strata RDNA3凭借长文本预填充接近两倍的恐怖优势,以及持续生成15%的领先,拿下综合性能冠军。Avalon表现同样过硬,在编程任务中甚至打出了漂亮的反击。
如果你手里也有一张7900XTX,日常有超长文档分析、本地大模型和长文档处理需求,Strata这套方案无疑是目前的性能首选;而如果工作负载更偏向代码生成这类单次推理路径敏感的任务,Avalon的专家缓存路线依然有自己的用武之地。
这场对决的真正价值在于:它证明了消费级单卡跑千亿参数模型已经从「能不能跑」进入到「怎么跑得更好」的阶段。软硬件协同的工程优化,正在把曾经属于服务器集群的能力,一点点搬到普通玩家的桌面上。
相关推荐
全球电网神秘同步扰动,德国团队找到元凶
全球多国电网出现神秘的同步功率跌落,德国研究团队找到背后元凶。本文解读这一协调性扰动的现象特征、研究突破及其对电网监测与运维的启示。
英伟达董事会调查间谍案:CEO承认婚外情引发内部风波
英伟达董事会调查间谍案:CEO承认婚外情引发内部风波
英伟达董事会启动间谍案调查,起因是CEO承认婚外情。本文分析事件背景、公司治理逻辑及对英伟达的潜在影响,并指出当前信息有限,需理性看待。
从零手写K-Means:一位开发者的机器学习进阶之路
一位开发者分享从零手写K-Means聚类算法的第59天进展:已完成监督学习全部算法,进入无监督学习阶段。本文解析手写K-Means的初始化策略、向量化距离计算、收敛判定与空簇处理等工程要点,并探讨从零实现算法对深入理解机器学习的价值。