单卡7900XTX跑84GB大模型:解码破百token实测与调优解析
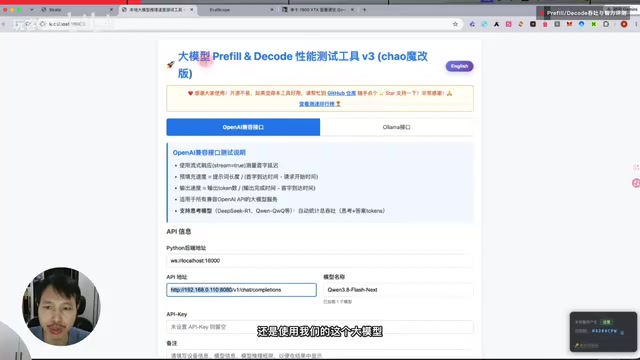
AMD 7900XTX加64GB内存,借助SGLang+MTP调优,本地跑84GB大模型实现90+ token/s输出。
本文基于实测视频,记录了在AMD 7900XTX(24GB显存)搭配64GB内存的消费级硬件上,通过SGLang引擎+MTP草稿机制部署千问3.8 Flash Next Q3量化版本(约84GB权重)的完整方案与性能数据。预填充吞吐平均900 token/s,解码速度稳定在90 token/s上下,实际代码生成任务达到72 token/s。智力测试表明该Q3量化版本接近DeepSeek Flash,明显优于千问3.8 27B Q4。方案核心在于显卡+内存的混合加载策略,以及解码窗口升级、128K长上下文优化等精细调参,默认配置与深度调优之间存在成倍速度差距。需要注意的是,视频标题宣称「单卡」但实测为双卡PCIe x8环境,Q3量化也意味着一定精度妥协,复现时需以完整文档为准并结合自身硬件验证。
AMD 7900XTX搭配64GB内存,能把一个约84GB权重的大模型跑出每秒上百token的输出速度——这个结果颠覆了很多人对消费级显卡部署大模型的认知。本文基于B站UP主的实测视频,拆解这套方案的真实性能、模型选型取舍以及背后的调优逻辑。
实测速度:预填充破千,解码稳定90+
测试使用的是千问3.8 Flash Next(Q3量化版本),权重约84GB,运行在AMD 7900XTX 24GB显卡上。从profile+decode性能测试工具的数据看,这套方案的表现相当亮眼。
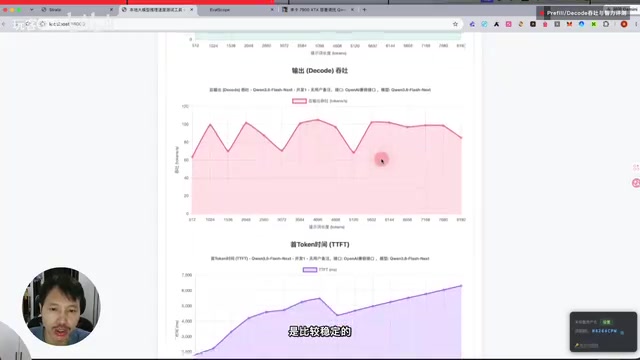
预填充(prefill)吞吐随着提示词长度增加而提升:短提示词时约290 token/s,随着上下文拉长逐步攀升至1300 token/s左右,平均预填充吞吐稳定在900 token/s。这意味着无论输入多长的提示词,处理速度不仅不会下降,反而会更快——这对实际工作场景非常友好。
输出(decode)速度则相对稳定,基本维持在90 token/s上下,总输出吞吐范围在63到1100之间,平均约90 token/s。需要说明的是,测试截止在8192的提示词长度,若继续增加上下文,预填充速度理论上还会进一步提高。
在实际生成任务中,UP主让模型编写一个可在网页运行的探测车游戏,点击发送后仅停留几秒就开始密集输出token,最终一次性生成了约2800 token的完整代码,平均输出速度达到72 token/s,复制后可直接正常运行。这个速度比此前部署千问3.8 27B模型还要更快。
智力对比:接近DeepSeek Flash,碾压27B Q4
速度快不等于能用,模型的实际智力水平同样关键。测试选取了三款模型做横向对比:基准为当前使用的DeepSeek广告 Flash,以及千问3.8 27B Q4、千问3.8 Flash Next Q3KL。
结果显示,这款Q3量化的千问3.8 Flash Next智力相比Q3KL版本有轻微下降,但对比DeepSeek Flash几乎持平,差距不大。而相较千问3.8 27B Q4,智力等级则有明显优势——用UP主的话说,27B Q4在智力方面对比Flash版本「还是差一个档次」。
这个对比给出了一个明确的选型建议:如果硬件条件允许跑起Flash版本,就尽量选它,而不是退而求其次用参数量更小的27B Q4。更大的基座模型即便经过较激进的量化,整体能力仍优于小模型的轻度量化。
Q3量化(3-bit量化)是指将模型权重从原始的16位或32位浮点数压缩为每个参数仅用约3个比特表示,储存体积可缩减至原来的约五分之一。量化精度越低,权重能精确表达的数值范围越粗糙,理论上会带来一定的模型能力损失,但实际影响幅度因模型架构和量化算法而异。Q3KL是一种基于KL散度(Kullback-Leibler divergence)最小化原则的量化变体,在压缩时尽量保留原始权重分布的形状,通常比朴素Q3在智力基准上表现更稳定但略慢。文章提到Q3量化版本对比Q3KL有轻微智力下滑,但换来的权重体积进一步缩小使得整套方案在有限显存+内存的环境下可以运行起来,是一种在部署可行性与模型能力之间的主动权衡。
84GB权重如何塞进24GB显卡
这是整套方案最反直觉的部分。84GB的模型权重,显存只有24GB,靠的是显卡+64GB内存的混合加载策略。
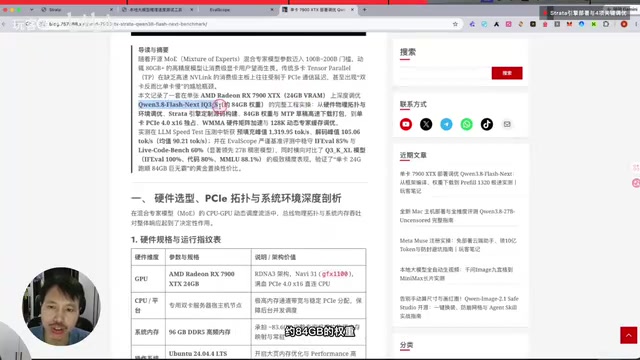
框架方面使用的是SGLang引擎(视频中口述为「Straight引擎」),配合MTP(Multi-Token Prediction)草稿机制来加速解码。部署流程相当完整:从推理框架的定制与编译、安装基础依赖、克隆源码、针对性配置编译,到初始化Python虚拟环境、模型权重下载与MTP草稿制作,再到引擎的深度改造。
这里有个值得澄清的细节:视频标题说「单卡」,但UP主坦言实测环境其实是双卡,运行在PCIe x8的带宽下。他推测如果撤掉另一张卡改用单卡满速,速度可能还会进一步提升。这一点对打算复现的读者很重要——实际单卡表现需要自行验证。
显卡+内存的混合加载策略在技术上称为「CPU offloading」或「统一内存推理」。推理框架会将模型权重按层分配:计算密集的层尽量留在显存中以利用GPU并行算力,其余层存放在系统内存(RAM)中,每次前向传播时按需将对应层的权重搬运到显存完成计算再换出。这种方式的瓶颈在于PCIe总线带宽——权重在RAM与显存之间搬运的速度直接影响解码吞吐。视频中运行在PCIe x8而非满速x16,理论带宽约16 GB/s,这也是UP主推测改为单卡x16后速度可能再次提升的原因。64GB大容量内存在此方案中不仅是「放得下」的容量保障,也影响着内存子系统的总带宽表现,因此内存频率和通道数对整体性能同样有实际影响。
调优才是性能的关键
UP主特别强调,最初的速度并没有这么快,是经过一系列调优后才达到破百的效果。
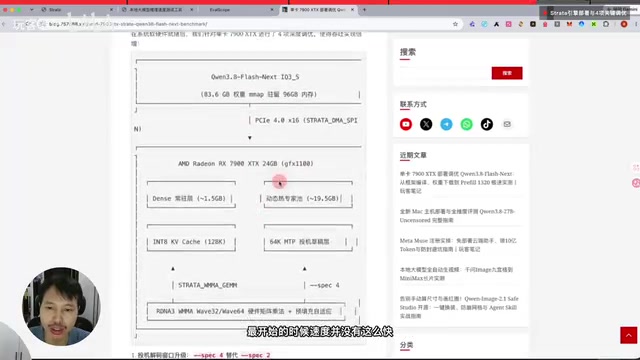
核心调优动作包括几项:解码窗口从2升级到4替代;消除推测采样本身的断点追加;以及对MTP长上下文的处理——原本256的设置优化到128K。UP主认为,128K的上下文对普通任务已经完全够用,即便遇到超长输入,做一次上下文压缩即可,而换来的速度提升非常可观。
从这些细节能看出,消费级硬件跑大模型的性能上限,很大程度上取决于框架层面的精细调参,而非单纯堆硬件。相同的卡和内存,默认配置和深度调优之间可能有成倍的速度差距。
MTP(Multi-Token Prediction)草稿机制属于推测解码(Speculative Decoding)的一种变体。标准推测解码的思路是:用一个小型「草稿模型」一次性预测多个候选token,再由主模型并行验证,接受正确预测的部分并丢弃错误预测,从而在单次前向传播中实际推进多个token,等效提升解码速度。MTP则将草稿预测能力内建于主模型的额外输出头中,省去维护独立草稿模型的开销。解码窗口从2升级到4,意味着每轮草稿一次预测4个候选token,验证通过率越高,速度收益越明显。这类优化本质上是在「模型智力基本不变」的前提下,通过批量推测+并行验证来突破自回归解码逐token生成的速度上限。
对本地部署的参考意义
这次实测提供了一个有价值的参考样本:用一张(或两张)消费级AMD显卡加64GB内存,就能在本地跑起一个智力接近DeepSeek Flash、输出速度破百的大模型,并且能稳定完成代码生成这类实际任务。
对于关注数据隐私、希望本地化部署、又不愿投入服务器级硬件的个人开发者和小团队来说,这套SGLang+MTP+量化的组合给出了一条可行路径。UP主也提供了从硬件选型、PCIe拓扑、系统环境到启动脚本的完整教程文档,并提到可以直接把文档丢给agent工具实现一键部署。
需要提醒的是,视频中的「单卡」表述与实测双卡环境存在出入,Q3量化也意味着一定的精度妥协。想复现这套方案的读者,建议以UP主的详细文档为准,并结合自身硬件做实际测速验证。
相关推荐

用Claude Code一天半做出AI测验:Vibe Coding的真实样本
一位开发者用Claude Code结合Opus 5.5与Fable 5.1,在一天半内做出一款PS1复古风格的AI主题测验游戏。本文解析这个业余项目背后的AI辅助编程实践与行业启示。

用Claude+Muse打造自动化膳食规划:AI如何替代HelloFresh
一位不懂编程的Reddit用户用Claude和Muse搭建了自动化膳食规划系统,涵盖菜单规划、沃尔玛自动下单、厨房平板界面,号称HelloFresh杀手。本文解析其工作流与AI生活自动化的启示。

构建语义代码搜索的RAG管道:原理与实践
本文解析如何为语义代码搜索构建RAG管道,涵盖代码分块、向量化、检索重排与生成四大环节,并探讨分块策略、embedding模型选择和索引维护等落地挑战。