单一算法统一大模型训练全流程

新研究将RL目标写成最大似然,用单一算法统一预训练、SFT与RL四阶段训练。
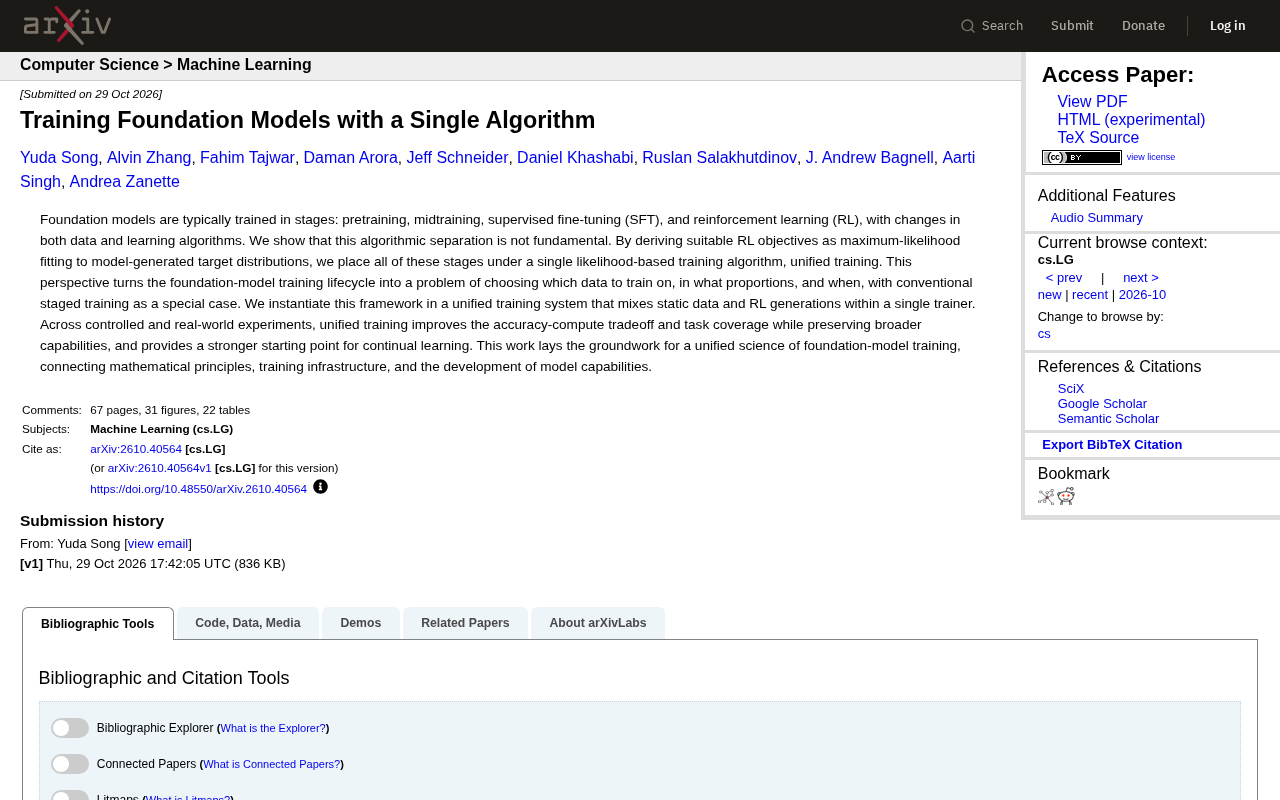
文章介绍了一项挑战大模型分阶段训练范式的研究。当前预训练、中训练、SFT 和 RL 四阶段各自使用不同算法,这种分离更多是历史与工程妥协的产物。该研究将 RL 目标推导为对模型生成目标分布的最大似然拟合,从而把四个阶段归入同一族似然目标,提出统一训练框架:训练问题从"换算法"转变为"在什么数据上、以什么比例、在什么时机训练",分阶段训练退化为数据配比策略的特例。作者还构建了能在单个训练器中混合静态数据与 RL 生成数据的系统,实验声称改善了精度-计算量权衡、扩大任务覆盖并增强持续学习起点。文章也指出最优配比确定、工程经验映射等开放问题仍待回答。
大模型训练通常被拆分为预训练、中训练、监督微调(SFT)和强化学习(RL)四个阶段,每个阶段不仅数据分布不同,学习算法也各异。这种分阶段范式几乎成了行业默认的工程常识。但一篇新研究提出了一个根本性的反问:算法层面的分离是必要的吗?
分阶段训练的惯性从何而来
当前的基础模型训练流水线之所以分阶段,很大程度上是历史与工程妥协的产物。预训练阶段使用海量静态语料,以最大似然为目标做下一 token 预测;SFT 阶段换成人工标注的指令数据,目标形式看似相同但数据性质变了;RL 阶段则引入奖励模型和策略梯度,算法框架整体切换。
每一段都有各自调参、各自监控指标、各自的基础设施需求。分阶段的好处是每一段都可以独立优化,坏处是阶段之间的衔接往往靠经验规则,数据配比和切换时机缺乏统一的原则性指导。研究者指出,这种算法上的分离并非根本性的,而更像是被沿袭下来的习惯。
据该研究描述,把不同阶段视为不同算法的组合,会让整个训练生命周期难以用一个连贯的理论框架来分析。数据该在什么阶段、以什么比例进入训练,变成了一堆需要实验试错的超参数。
统一训练:把 RL 目标写成最大似然
这项工作的核心思路是把 RL 目标推导为对模型生成目标分布的最大似然拟合。一旦 RL 阶段的目标也能写成似然形式,它就和预训练、SFT 在数学上归入同一族目标函数。作者据此提出统一训练(unified training)框架,将上述所有阶段纳入单一基于似然的训练算法。
这个视角带来的直接推论是:整个训练生命周期不再是"换算法"的问题,而是"选择在什么数据上训练、以什么比例、在什么时机训练"的问题。传统的分阶段训练,在统一框架下退化成一个特例——只是数据选择和配比策略的一种特定安排。
换句话说,预训练、中训练、SFT 和 RL 之间的界限,从算法层面的硬切换,变成了数据调度层面的连续决策。这为训练策略的设计提供了更统一的语言。
最大似然估计(MLE) 是统计学中最基础的参数估计方法之一:给定一组观测数据,选择使这些数据出现概率最大的模型参数。在语言模型预训练中,它具体化为最小化交叉熵损失,即最大化模型对真实下一个 token 的预测概率。SFT 阶段形式相似,只是数据换成了指令-响应对。
把 RL 目标写成最大似然形式在数学上并非显然。标准 RL(如 PPO)优化的是期望奖励,梯度估计依赖策略梯度定理,通常需要重要性采样和基线减法等技巧,与监督学习的梯度形式差异很大。近年来的研究(如直接偏好优化 DPO)表明,在特定奖励结构下,RL 目标可以等价地转化为对某种目标分布的似然最大化,从而绕开显式的奖励模型和策略梯度。本文的思路正是将这一归约推广到整个训练生命周期,使 RL 与预训练、SFT 共享同一套优化语言。
系统实现:静态数据与 RL 生成混在同一个训练器里
光有数学框架不够,作者进一步构建了一个统一训练系统,能在单个训练器内混合静态数据和 RL 生成数据。这一点在工程上相当关键:以往 RL 阶段需要独立的采样和训练循环,与预训练的数据管道是两套设施;统一训练系统把它们合并到同一套流程中。
论文声称,在受控实验和真实场景实验中,统一训练改善了精度与计算量的权衡(accuracy-compute tradeoff),扩大了任务覆盖范围,同时保留了模型的广泛能力,并且为持续学习提供了更强的起点。这些结论来自作者自身的实验评估,具体量化指标需参考原文。
说个细节实验设计中的"受控实验"与"真实场景实验"两条线:前者用于验证框架在理想条件下的行为,后者检验它在实际训练规模下的可用性,两者互为补充。
持续学习(continual learning) 指模型在完成初始训练后,继续学习新任务或新数据而不遗忘旧知识的能力,其核心挑战是灾难性遗忘:参数更新会覆盖先前学到的表示。在多阶段训练范式中,SFT 和 RL 阶段往往会削弱预训练阶段获得的通用能力,而后续再学习新任务时又可能进一步退化。统一训练框架之所以被认为能提供更强的持续学习起点,是因为所有阶段共享同一目标函数,模型参数始终处于同一个优化景观中,增量更新时不需要跨越不同算法造成的目标断层。不过这仍是假设层面的优势,需要实验证据支撑。
对训练实践意味着什么
如果统一训练的结论在更大规模上成立,它对训练实践的影响可能体现在几个层面。
基础设施层面,训练系统需要支持静态语料和在线生成数据在同一循环中按比例混合,数据管道的设计重心会从"分阶段切换"转向"动态配比调度"。
研究层面,论文将自己定位为通往"统一的基础模型训练科学"的基础工作,试图把数学原理、训练基础设施和能力发展三者连接起来。
持续学习层面,作者特别提到统一训练为持续学习提供了更强的起点。这与分阶段范式下的困境相呼应:多阶段训练后的模型在继续学习新任务时容易出现能力退化,而一个统一目标下训练出的模型或许在结构上更适合增量更新。
需要说明的是,这些影响目前仍处于框架提出与初步验证阶段,距离大规模工业验证还有距离。
仍需回答的问题
统一训练提出了一个优雅的数学归约,但从归约到实践仍有若干开放问题。混合静态数据与 RL 生成数据的最优配比如何确定?论文将其转化为数据选择问题,但选择策略本身仍需要方法论支撑。分阶段训练积累的工程经验——比如分阶段学习率调度——在统一框架下如何映射,也需要重新审视。
另外,摘要中提到的"保留更广泛能力"和"更强持续学习起点"属于定性表述,实际增益幅度、在不同模型规模下是否稳定,都需要后续工作给出更细致的证据。
这项工作的价值在于换了一个提问方式:不是问每个阶段该用什么算法,而是问所有阶段能否共用一个算法。回答是肯定的,剩下的问题就变成了数据调度这门新学问。
相关推荐

触屏MacBook与混乱的苹果:一场刻意为之的冒险
The Vergecast 深入讨论触屏 MacBook Pro 的发布逻辑、ProLed 命名争议、iPad 被 iPhone 与 Mac 两头挤压的困境,以及苹果在 AI 时代如何靠高端硬件维持竞争力。
研究权力50年:Robert Caro的写作与权力洞察
Robert Caro研究权力50年,在访谈中谈Lyndon Johnson的说服力与杠杆、Robert Moses从理想主义到冷酷的变迁、大规模建设的困境,以及传记写作中压缩主题与孤独专注的方法。
2万美元的机器人能替你干家务吗?实测结果令人意外
一段YouTube实测视频展示2万美元机器人如何响应洗碗、关灯、倒垃圾、喂狗等指令。本文分析其真实能力边界、语音交互技术现状,以及家务机器人距离普及还有多远。