单张AMD R9700跑Qwen3 27B性能翻倍:解码153 tok/s实测解析
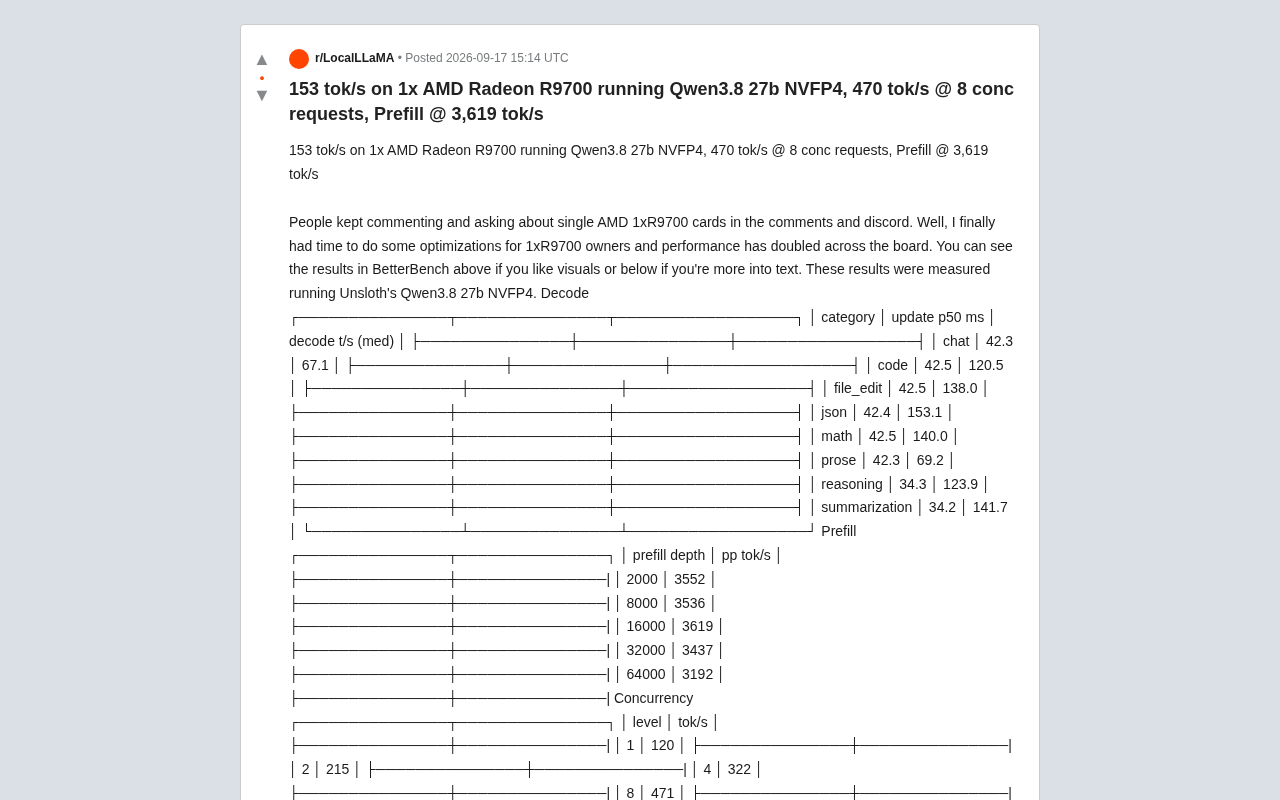
单张AMD R9700经vLLM框架针对NVFP4量化优化后,运行Qwen3 27B推理性能全面翻倍,解码峰值达153 tok/s。
一位开发者针对单张AMD Radeon R9700的本地推理场景,在vLLM框架上对NVFP4/MXFP4量化路径进行了专项优化,使该配置运行Qwen3 27B模型的各项性能指标实现翻倍。解码阶段峰值速度在JSON结构化任务中达到153 tok/s,自然语言任务约67-69 tok/s,差异源于不同任务的token分布特征。预填充速度稳定在3400-3600 tok/s区间,即便在64K长上下文下衰减也控制在12%以内;8并发请求下总吞吐可达471 tok/s,满足个人或小团队自建推理服务需求。相关代码已开源至Codeberg和GitHub。此次实测说明,在合适的量化格式与框架优化配合下,AMD硬件的推理潜力正被逐步释放,但数据来自单一开发者,仍需结合自身环境验证。
单卡AMD显卡本地推理的新进展
在本地大模型推理领域,AMD显卡长期被视为CUDA生态之外的“次优选择”。不过一位开发者近日在Reddit分享的实测数据,为单张AMD Radeon R9700的用户带来了实质性的性能突破。经过针对性优化后,这套配置在运行Qwen3 27B NVFP4量化模型时,性能实现了全面翻倍。
据原作者介绍,此前社区评论区和Discord中有大量用户询问单张R9700(1xR9700)的表现,于是他抽时间专门为这类配置做了优化。最终结果是“性能在各项指标上都翻了一倍”。测试统一基于Unsloth发布的Qwen3 27B NVFP4量化版本进行。
解码性能:不同任务差异显著
从解码(Decode)阶段的实测数据看,不同任务类型的token生成速度差异相当明显。在最能体现结构化输出优势的JSON任务上,中位解码速度达到了153.1 tok/s,这也是标题中引用的峰值数字。math(数学)任务为140.0 tok/s,summarization(摘要)为141.7 tok/s,file_edit(文件编辑)为138.0 tok/s,均处于高位区间。
相对而言,偏自然语言生成的任务速度较低:chat(对话)为67.1 tok/s,prose(散文写作)为69.2 tok/s。code(代码)和reasoning(推理)则分别为120.5和123.9 tok/s,居中。这种分化说明,token生成速度并非固定值,而与输出内容的结构化程度、token分布特征密切相关——结构化、可预测性强的输出往往能跑出更高的吞吐。
值得关注的是各任务的更新延迟(update p50 ms)大多稳定在42ms左右,reasoning和summarization则更低,约34ms,说明响应的一致性良好。
预填充与并发:吞吐潜力的真正体现
对于本地推理体验而言,预填充(Prefill)速度往往比单纯的解码速度更能决定长上下文场景下的实际感受。测试数据显示,R9700的预填充吞吐相当稳健:
- 2000 token深度:3552 tok/s
- 8000 token深度:3536 tok/s
- 16000 token深度:3619 tok/s(峰值)
- 32000 token深度:3437 tok/s
- 64000 token深度:3192 tok/s
即便上下文深度提升到64K,预填充速度也只从峰值3619 tok/s回落到3192 tok/s,衰减幅度控制在12%左右。这意味着在处理长文档、长对话历史时,这套配置不会出现严重的性能塌陷。
并发(Concurrency)测试则展现了它作为轻量服务端的潜力。单请求为120 tok/s,2并发时提升至215 tok/s,4并发达到322 tok/s,8并发时总吞吐冲到471 tok/s。虽然并发扩展并非线性(8并发并未达到单请求的8倍),但总吞吐随并发数稳步增长,对于个人或小团队自建推理服务已经相当够用。
预填充(Prefill)与解码(Decode)是大模型推理的两个不同阶段,二者在计算特征上有本质区别。预填充阶段负责一次性处理用户输入的所有token,属于计算密集型(Compute-bound)操作,可以充分利用GPU的并行矩阵乘法能力,因此吞吐数字通常远高于解码阶段。解码阶段则逐token自回归生成输出,每步只需处理一个新token,属于内存带宽密集型(Memory-bound)操作——GPU的算力大量闲置,瓶颈在于显存带宽能以多快速度将模型权重"喂"给计算单元。这也是为什么本文中预填充速度高达3600 tok/s,而解码速度仅为150 tok/s左右。并发请求能提升总解码吞吐,正是因为多个请求可以批量处理,让原本闲置的算力得到利用,从而摊薄内存带宽的瓶颈代价。
NVFP4量化格式的角色
本次测试选用的是NVFP4量化格式的Qwen3 27B模型。NVFP4作为一种4位浮点量化方案,能在大幅压缩显存占用的同时尽量保留模型精度,这也是让27B级别模型能在单张消费级/工作站级AMD显卡上流畅运行的关键前提。
作者同时更新了两个代码仓库,方便不同平台的用户使用——一个托管在Codeberg(radiance-vllm-mxfp4),另一个应部分用户要求同步到了GitHub(vllm-mxfp4)。从仓库命名可以看出,这套优化围绕vLLM推理框架与MXFP4/NVFP4量化路径展开。
NVFP4(NVIDIA Float Point 4-bit)是一种4位浮点数格式,与传统的INT4整数量化不同,它保留了浮点数的指数位设计,因此在表示动态范围较大的权重分布时精度损失更小。MXFP4则是微软与英特尔等机构联合推动的MX(Microscaling)系列标准之一,属于分组浮点量化规范:每组权重共享一个缩放因子(scale factor),在压缩率与精度之间取得较好的平衡。两者在命名和实现细节上有所区别,但均属于"4位浮点量化"大类,核心思路都是将原本以FP16或BF16存储的模型权重压缩至4位,使显存占用降低约4倍,从而让参数量达到27B的大模型能够装入单张16-24GB显存的消费级或工作站级显卡。代价是推理前需要额外的反量化计算步骤,因此优化这一路径的计算内核(kernel)正是本次vLLM框架改动的核心工作所在。
对AMD本地推理生态的意义
这类来自社区的实测与优化,正在逐步补齐AMD显卡在大模型本地部署上的短板。长期以来,NVIDIA凭借CUDA和成熟的推理框架生态占据主导,AMD用户常常面临“能跑但跑不快”的窘境。而单张R9700跑出153 tok/s的解码峰值、3600+ tok/s的预填充速度,说明在合适的量化格式和框架优化配合下,AMD硬件的推理潜力正被逐步释放。
需要提醒的是,这些数据来自单一开发者的分享,尚未有大规模第三方复现验证,具体表现可能因驱动版本、系统配置和模型细节而有所差异。对于计划入手AMD显卡做本地推理的用户,这份数据可以作为有价值的参考,但仍建议在自身环境中实测确认。
对已经持有单张R9700的用户而言,这次优化带来的“性能翻倍”无疑是一份实惠的礼物——原本的硬件不动,仅通过软件层面的优化就能获得成倍的吞吐提升。
AMD显卡在大模型推理领域面临的核心挑战并非硬件性能本身,而是软件生态的成熟度差距。NVIDIA的CUDA平台经过十余年积累,拥有高度优化的推理内核库(如cuBLAS、cuDNN、TensorRT),以及vLLM、llama.cpp等主流框架的原生支持。AMD方面虽然推出了ROCm作为对标方案,但内核优化覆盖范围、社区贡献者规模和框架兼容性均存在差距,导致相同硬件规格下实际推理效率偏低。本次优化正是在ROCm+vLLM路径上针对MXFP4量化格式编写或调整了专用计算内核,属于典型的"软件追硬件"补足过程。类似的社区驱动优化近年来已多次出现,逐步缩小AMD与NVIDIA在实际可用性上的差距,也说明开放生态对于非主流硬件平台的重要价值。
相关推荐
Waymo重启圣安东尼奥测试:洪水5个月后卷土重来
Waymo在圣安东尼奥的Robotaxi被洪水冲走并暂停服务约5个月后重新恢复运营。本文回顾事件始末,并分析自动驾驶车辆在极端天气下面临的安全挑战与行业启示。
AIOps是什么?AI如何重塑IT运维
AIOps(面向IT运维的人工智能)通过AI和机器学习实现异常检测、告警降噪与根因分析,帮助企业从被动响应转向主动预测。本文解析AIOps的核心能力与应用价值。
CCC发出邀请:40C3黑客大会以"模范公民"为主题
CCC混沌通信大会宣布第40届(40C3)以"模范公民"为主题,向全球技术爱好者发出邀请。本文解读这一欧洲最大黑客盛会的背景、主题含义及社区反响。