当AI学会说"不确定":一个过敏原检测器的反直觉设计

Contains 用“含/不含/需要核实”三层判定,让过敏原模型学会诚实地说不确定。
开源工具 Contains 针对配方与配料表做美国九大过敏原判定,把结果设计为“含、不含、需要核实”三种状态,其中“需要核实”是产品的核心。作者先用零样本模型在普通标签上得到 0.98 召回,证明读懂标签并非难点;随后构造 62 个隐藏过敏原的复合配方测试集,揭示了真正的任务是“知道标签没说什么”。LoRA 微调在隐藏过敏原上反而不如基座模型(66% 对 78%),却首次教会模型拒答。最终交付的微调加规则双层系统达到 86% 召回、零误报,远超任何单一组件。作者刻意保留两处已知缺陷,以维护冻结测试集的证据完整性。
当AI学会说"不确定":一个过敏原检测器的反直觉设计
一个蛋糕配方:中筋面粉、黄油、鸡蛋、牛奶、黑巧克力、食用油。对大豆过敏的人能吃吗?
配方里没有"大豆"两个字。但黑巧克力通常含大豆卵磷脂,有时也不含;食用油在部分地区往往是豆油,有时也不是。诚实的答案既不是"能"也不是"不能",而是——去看包装袋。
开发者 Abeera 从这个看似简单的场景出发,做出了一个名为 Contains 的开源工具。它的核心主张只有一个:在信息不足时,模型应该说"需要核实",而不是给出自信的猜测。
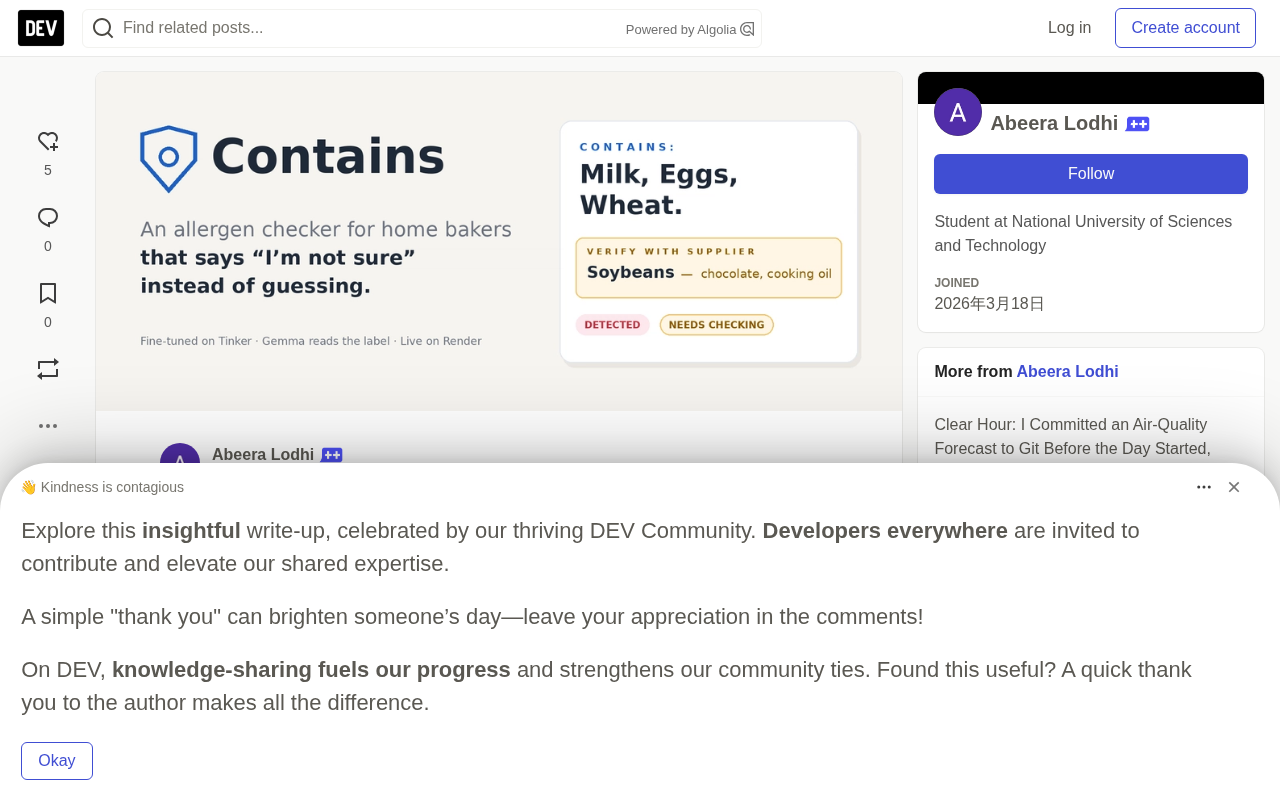
用三层判定替代是非题
Contains 读取配方或配料表,按照美国九大过敏原(牛奶、鸡蛋、鱼、甲壳类、坚果、花生、小麦、大豆、芝麻)输出一行 Contains: 声明。
关键设计在于判定结果有三种状态,而非两种:
| 判定 | 含义 |
|---|---|
| 含 | 由配料本身的定义保证 |
| 不含 | 列表中没有暗示它的成分 |
| 需要核实 | 某个具名配料可能隐藏该过敏原,取决于品牌 |
第三种状态才是产品本身。一个卖蛋糕的家庭烘焙者不需要工具替她猜,她需要知道哪三样配料得去查包装,哪十二样可以放心。每个判定都会展示触发它的具体词语和生效的判定层,不是黑箱。
据作者在原始文章中的说法,她起步用的现成模型面对 85 个隐藏过敏原,从未说过一次"不确定"——这正是她要修正的问题。
基线的意外结论:普通标签没有难点
在动手做模型之前,Abeera 先构建了基线。零样本的 Qwen3.5-4B 在普通留出配料表上拿到 0.98 的召回率。如果标签直接写着"牛奶、小麦粉、大豆卵磷脂",4B 模型本来就能读懂,这个方向没有值得解决的问题。
于是她构造了第二个测试集:62 个配方,过敏原藏在复合配料里且从不被点名。Dukkah(埃及香料混合物)、日式面包糠、XO 酱、仿蟹肉、白酱——每一行都手工编写和核对,文件冻结并记录哈希,直到最后才再次打开。
结果重新定义了整个项目:这件事从来不是"读懂标签",而是"知道标签没说什么"。
微调输了,但学到了另一种能力
作者使用 Tinker 提供的 LoRA 训练 API,基于 Qwen3.5-4B 在 5,755 条来自 Open Food Facts 的数据上微调。训练集约三部分:5,000 条普通产品、550 条拒答样本(插入未命名来源的配料,只有它可能隐藏的过敏原变成"不确定")、205 条对照样本(同一配料但标明来源,如"葵花卵磷脂""牛奶巧克力",应给出确定答案)。
对照样本的作用是让模型学会"未命名→不确定,已命名→判定",而不是对整个食物类别一律含糊。
结果是:微调模型输给了它的基座模型。 在留出的复合配方测试集上,微调版抓到 66%,基座模型抓到 78%。
原因并不复杂:训练标签来自配料文本本身,每个样本本质上是"这里有个含 milk 的列表,答案是 milk"。而作者真正想教的知识——dukkah 意味着芝麻、面包糠意味着小麦——在标签里根本不存在。就像用每张都带姓名牌的照片教人认脸,学到的只是读姓名牌。
但有一件事微调确实做到了:基座模型在 85 次机会里一次都没说过"不确定",微调版会。 拒答能力被成功学会了。
LoRA(Low-Rank Adaptation) 是一种参数高效微调技术:它冻结预训练模型的大部分权重,只在部分层旁注入低秩的适配矩阵,训练时仅更新这些新增参数。相比全量微调,LoRA 显存占用小、训练快、可为不同任务保存独立的适配器而不复制整个模型,因此很适合在 Tinker 这类托管 API 上快速迭代。
拒答(abstention) 指模型在信息不足时明确输出“无法判定/需要核实”,而非强行给出答案。它在安全攸关场景中是独立的评估维度:一个模型可以召回率很高,却从不拒答,因此把有风险的歧义包装成确定结论。正因如此,本文的比较表把“说不确定”单列一栏,与召回率、自信错误并列。
系统比模型更重要
最终交付的是两层结构:微调模型加一层配料规则。合并逻辑以安全优先、刻意朴素:
- 规则命中或模型判定为"含",则输出"含";
- 模型说"不确定"且文本中存在它可指认的未命名来源词,输出"需要核实";
- 其余情况输出"不含";
- 规则层的命中永远压过模型的"不含"。
在冻结测试集上的完整对比:
| 系统 | 抓到 | 自信错误 | 说不确定 | 误报 |
|---|---|---|---|---|
| 关键词基线 | 48 (0.56) | 37 | 0 | 4 |
| 仅 LoRA 微调 | 56 (0.66) | 16 | 13 | 0 |
| Qwen3.5-4B 零样本 | 66 (0.78) | 19 | 0 | 4 |
| 交付系统:LoRA + 规则 | 73 (0.86) | 11 | 1 | 0 |
单独看,关键词层只抓到一半多,微调模型不如基座模型。合在一起,它们超过了所有组件,并且是唯一零误报的配置。作者的原话是:结果不是模型,是系统。
召回率(recall) 指所有真正含某过敏原的案例中被系统成功识别出的比例,衡量“漏检”的程度;与之配套的误报(false positive) 指本不含却被判为含的比例。对过敏原场景而言,漏检直接关系人身安全,误报则制造噪音、让人忽略提示,因此二者必须同时报告。所谓“自信错误”指系统给出确定结论却判错的情况,它是比单纯错误更危险的失败模式。
失败案例与一个被主动保留的缺陷
11 个自信错误中,小麦占 6 个、牛奶 2 个、鸡蛋 2 个、鱼 1 个。具体包括:裸写的"面粉"(规则层刻意排除,因为杏仁粉和鹰嘴豆粉不是小麦)、仿蟹肉中的小麦粘合剂、以及白酱。
白酱对应的是整个项目里作者最喜欢的一个 bug:规则匹配 bechamel,而测试行写的是 béchamel,一个重音符号击败了检查器。这个问题在测试集冻结之后才发现,因此作为发现记录在案,不予修补——修补等于根据测试分数修改系统,分数就失去意义。
还有一处被作者称为"现在会反向修改"的设计:那条把"不确定"降级为"不含"的四行规则。计分后核查发现,11 个自信错误里有 5 个原本被微调模型正确判为"不确定",却被这条规则覆盖成了确定的"不"。等于用警告噪音换来了项目本来要预防的那类错误。她没有改,理由同样是不能在测试集上调参。
本地读图:Gemma 3 4B 的辅助角色
手动输入配料表是这类工具最烦人的环节。本地版本改为拍照:Gemma 3 4B 通过 Ollama 在用户自己机器上运行,读取标签,提取文本送入同一套流水线。在一包真实乳制品上,它逐字读出配料并返回 Contains: Milk,规则层与模型层独立得出相同结论,证据标签指出匹配到的具体词。
CPU 上连同模型加载约 52 秒,慢,但对于每个产品只做一次的操作完全可以接受。OCR 文本可编辑后再重跑,因为 OCR 会出错,而拿着包装袋的是用户。
Ollama 是一个本地大模型运行时,负责模型下载、量化加载与推理服务封装,让模型在用户自己的机器上离线运行。本地部署的意义在于配料照片与识别结果不离开设备,隐私不外流;代价是受 CPU 算力限制,冷启动与单次推理更慢。Gemma 3 4B 在此充当视觉语言模型(VLM),把标签图片转成文本,再交给与在线版相同的判定流水线,使两种入口共享同一套逻辑。
工程细节:冷启动与降级
在线演示部署在 Render 免费层,实例会休眠。作者用自己的线上站点做测试时撞上了最糟糕的情况:超时设置 25 秒,预热需要 34 秒,任何静默期后的第一个请求都会静默回退到纯规则模式——而那个请求最可能是评审或客户发出的。
修复方向不是缩短超时,而是相反:冷启动时应用现在会等待,告知用户正在唤醒模型,然后返回真实答案。"安静地降级比大声地慢更糟。"修复过程中还发现第二个 bug:等待期间标签接口阻塞了事件循环,在并发下会冻结健康检查。
第一位用户的反馈
作者把工具交给一位卖蛋糕的家庭烘焙者,用她的三个配方测试。预期的收获是工具准不准,实际学到的是自己在和什么竞争。
她目前的过敏原检查方式是谷歌一下,或者问 ChatGPT——一个回答自信、从不说"不确定"、也无法指出配方中哪个词触发判断的聊天机器人。这个基准比任何评测数字都更让作者清醒。
她用三个配方测试的结论是:已确认的过敏原列表没有错误;巧克力与大豆的关联、以及开心果酱和 banaspati(南亚起酥油)的成分对她来说是新的;不确定提示有用,但只在精准时有用——如果每次巧克力都报警,就会变成被忽略的噪音。她指出的最弱结果是未指明食用油上的花生标记,作者承认这是系统最牵强的推断。
被问到是否愿意付费:会使用,但还不是时候——每月两三美元,前提是可靠到能用于为客户准备产品的场景,并且能记住她常用的品牌。作者认为这是整周最有价值的一句话:不是"很棒",而是"现在还不值这个钱,而让它值钱的具体缺口在这里"。
开源在这里意味着什么
作者给出了三个理由,都来自这一周的实际经历。
第一,需要检查的东西正是需要修复的东西。微调失败后,唯一能弄清原因的方式是能读到自己的训练数据、标签和合并规则。如果模型是不透明的 API,"它没work"就会是调查的终点而不是中点。
第二,数据是开放的,缺陷也是开放的。Open Food Facts 是众包数据库,里面有 HTML 标记、不一致的过敏原标签、以及配料表中出现自我矛盾声明的产品。这些问题都能看见。一个同样有这些问题但闭源的数据集,会给出同样虚高的数字,而且无从察觉。
第三,受益者付不起企业价格。一位在巴基斯坦家中经营蛋糕生意的用户,明确表示每月愿付两到三美元。一个 2.5 美元微调出来的 4B 开源模型加免费层托管,正好能服务她;纯本地版本则完全免费。
边界声明
作者把局限列得很直白:数据以美国和欧洲为主,对巴基斯坦的烘焙者是真实错配——banaspati 出现在规则里是因为她手动加进去,而不是数据教会了模型;鱼和甲壳类样本总共只有 799 个正例;金标准集只有 100 行,由她一人手工核对。
最重要的那条:拒答行为对措辞脆弱。 同一输入采样 8 次得到 8 个相同输出,但把同样的配料重新排序,大豆和花生就从"不确定"翻成了自信的"不"。所以她说,不能声称这个能力可靠,那就不声称。
工具上的每一屏都写着:这不是厂商标签的替代品。
这个项目真正的价值
一个微调失败了、准确率 86%、还在几个案例上自信地漏掉过敏原的项目,为什么值得读?
因为它的价值不在分数,在于演示了一种做 AI 产品的方法:先构造能把想法杀死的测试集,再决定要不要做;把失败和 bug 按名字写进报告;冻结测试集,之后发现的缺陷宁可留着也不修补,因为修补会污染证据。
作者在文末写道:她最初想做的,是一个知道你的巧克力里藏着什么的模型。最后交付的,是一个知道什么时候该让你自己去看的模型。
对于一个要为顾客的过敏反应负责的人来说,后者的诚实可能比前者的自信更有用。
背景补充
零样本(zero-shot) 指不提供任何任务示例、仅凭指令让模型直接完成推理;与之相对的少样本(few-shot)会在提示中附带若干输入输出范例。零样本基线的作用在于划定“模型本身已经能做什么”的下界,从而判断某个方向是否真有值得解决的问题。
留出集(held-out set) 是不参与任何训练或调参、只用于最终评估的数据。本文更进一步,把测试集在构造完成后冻结并记录哈希,确保评测期间无人改动,避免结果被事后调整所污染。
相关推荐

Workbuddy零基础入门:桌面AI智能体如何落地工作流
Workbuddy桌面AI智能体零基础教程解读:从安装、积分领取到文件管理与自动化工作流搭建,对比CodeX的适用场景与成本差异,帮助职场人完成从AI提问者到AI管理者的思维转变。

OpenAI智能体新栈:计算机操作、决策API与超速工作流
OpenAI Dev Day发布智能体新栈:Computer Use操作速度超越普通人,Decisions API基于Luna实现极低延迟分类,Agents API开放同源计算机操作能力,GPT-6.1 Sol成本仅为Astra七分之一。本文梳理核心更新、实测数据与开发者落地要点。

梁文峰开源推理框架DeepInfo,硬刚美国禁令
DeepSeek在开源模型后再开源推理框架DeepInfo,包含GPU/CPU交叉流水线、小模型预判大模型复核、华为昇腾与英伟达芯片全面适配等技术,直面美国联邦禁令。本文解析其对AI产业落地的意义与开源策略。