当AI智能体自我繁殖:多智能体系统的权责难题

多智能体系统中,智能体的身份、委托与溯源机制比能力堆叠更迫切,需在编排层而非prompt层解决。
随着多智能体工作流的普及,一个被低估的工程问题正在浮现:当智能体自主派生子智能体、调用工具并修改真实代码库时,传统的 Git 提交记录和 GitHub 协作工具——这些为人类协作者设计的系统——完全无法追溯"某个动作由哪个智能体在谁的授权下发起"。"是智能体干的"等同于没有审计记录。文章提出,智能体的身份(identity)、委托(delegation)和溯源(provenance)可能与其实际能力同等重要,且相关机制必须在编排/控制层架构中落地,而非依赖 prompt 的临时补丁。核心待解的设计抉择包括:权限继承规则、子智能体的独立身份管理、委托链的完整记录,以及自主性与授权边界的划定。作者同时保持清醒,质疑这在当前规模下是否已是迫切问题,但从软件工程史来看,身份与审计基础设施往往在规模化后才被迫补课,提前布局或许是多智能体系统走向生产级可靠性的必经之路。
问题的起点:"是智能体干的"算不上审计记录
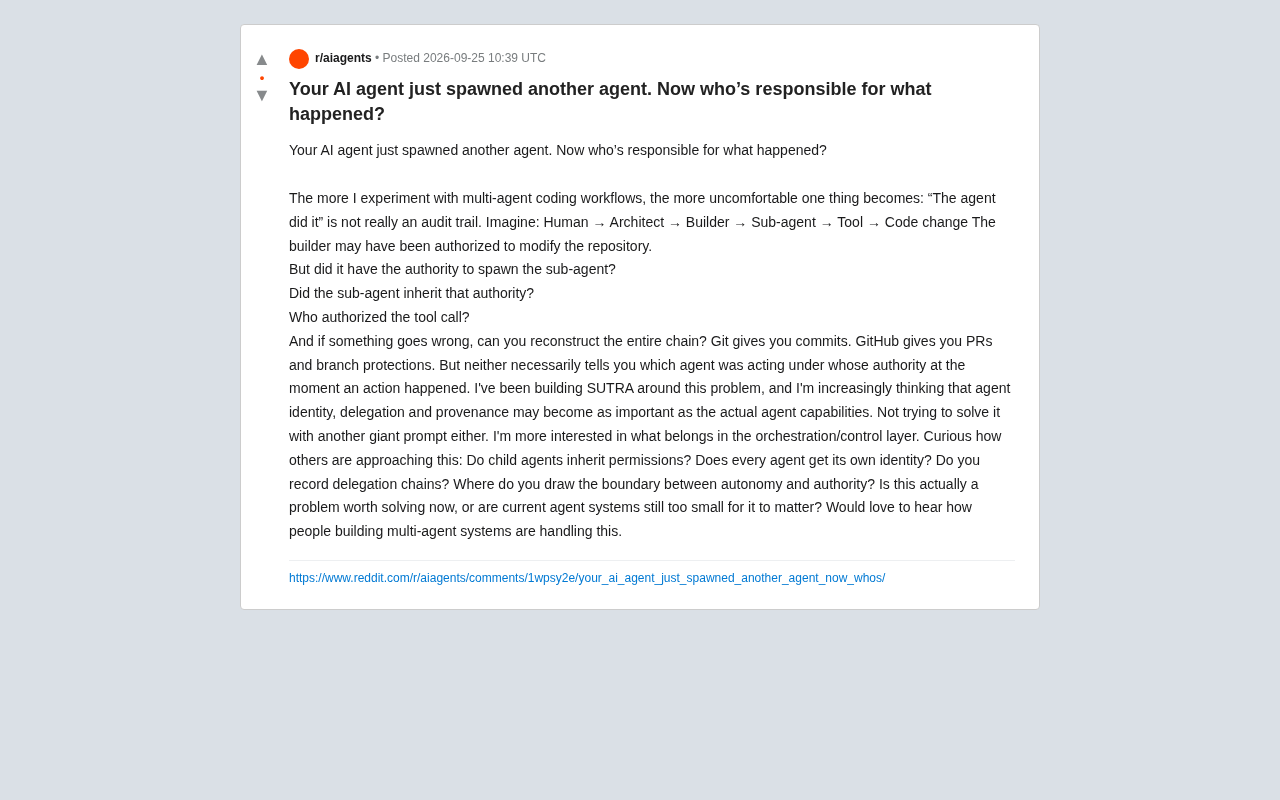
随着多智能体(multi-agent)编程工作流越来越普及,一个令人不安的问题浮出水面:当出了问题,你能否说清楚到底是谁授权了什么?
一位正在开发 SUTRA 项目的开发者在 Reddit 上抛出了这个尖锐的思考。他描述了一条典型的授权链条:
Human → Architect → Builder → Sub-agent → Tool → Code change
在这条链条里,Builder(构建智能体)也许被授权修改代码仓库。但问题接踵而至:它有权限去派生出一个子智能体吗?这个子智能体又继承了哪些权限?那次工具调用(tool call)究竟是谁批准的?一旦发生事故,你能否完整地重构出整条责任链?
这不是一个抽象的哲学问题,而是随着智能体自主性提升,正在变得越来越现实的工程挑战。
现有工具为何不够用
作者一针见血地指出了当前技术栈的盲区:
- Git 给你的是 commit(提交记录)——它告诉你代码变了什么,但不告诉你是哪个智能体在谁的授权下改的。
- GitHub 给你的是 PR 和分支保护规则——它约束了合并流程,却无法追溯某个动作发生时,究竟是哪个智能体在代表谁行事。
换句话说,我们现有的版本控制和协作工具,是为人类协作者设计的。它们默认每个操作背后是一个有身份、有责任的自然人。而在多智能体系统里,一个动作背后可能是一连串自动派生、自动授权的机器实体,传统审计手段完全断裂。
"The agent did it(是智能体干的)"这句话,本质上等于没有审计记录。你无法追责,也无法复盘。
核心命题:智能体的身份、委托与溯源
作者提出了一个值得深思的判断:智能体的身份(identity)、委托(delegation)和溯源(provenance),可能会变得和智能体的实际能力一样重要。
这实际上是把安全领域成熟的**身份与访问管理(IAM)**理念,迁移到智能体世界。在人类和服务的世界里,我们早已习惯了:每个主体有独立身份、权限有明确边界、操作有完整日志。但在快速迭代的智能体生态中,这些基础设施还严重缺位。
值得强调的是,作者明确表示不打算用另一个巨型 prompt 来解决这个问题。他的关注点在于编排层/控制层(orchestration/control layer)——也就是说,权责管理应该是系统架构层面的机制,而非塞进模型提示词里的临时补丁。这个方向判断相当务实:把治理逻辑硬编码进 prompt,既不可靠也不可审计。
身份与访问管理(IAM) 是企业 IT 安全领域数十年积累的成熟体系,其核心原则包括:最小权限(least privilege,每个主体只获得完成任务所需的最低权限)、职责分离(separation of duties)、以及完整的操作审计日志。典型实现包括 AWS IAM、OAuth 2.0 的委托授权流程等。在人类与服务交互的场景下,IAM 已能精确回答"谁、在何时、以何种权限、做了什么"。
将 IAM 迁移到智能体世界面临的核心挑战在于:传统 IAM 假设"主体"是相对静态的——一个用户账号、一个服务账号。而多智能体系统中,智能体可以在运行时动态生成子智能体,每个子智能体的生命周期极短、数量可能爆炸式增长,这使得静态的身份注册与权限绑定机制难以直接套用,需要在架构上重新设计适合动态委托场景的身份模型。
悬而未决的设计抉择
作者列出了一系列尚无定论的关键问题,这些恰恰是构建多智能体系统时绕不开的设计抉择:
权限继承
子智能体是否应该继承父智能体的权限?全盘继承会带来权限膨胀的风险——一个本应只读的子任务,可能因为继承而获得了写权限。而完全不继承又会让委托链条难以运作。
权限继承问题在计算机安全领域有一个对应的经典概念——权限提升(privilege escalation):攻击者利用系统漏洞,从低权限账户获得更高权限。在多智能体场景中,这种风险无需外部攻击者,系统自身的委托机制就可能在无意间造成权限扩散。一种参考方案是借鉴 OAuth 2.0 的 scope 缩减原则:下游主体获得的权限只能是上游显式授予的权限的子集,永远不能超出,且每次委托都必须明确声明所委托的 scope,而非隐式继承全部权限。这一机制若能移植到智能体编排层,可在架构上杜绝因继承导致的权限膨胀。
独立身份
是否每个智能体都应该拥有自己的身份标识?独立身份是精细化审计的前提,但也意味着更重的身份管理开销。
委托链记录
是否需要完整记录委托链(delegation chain)?这是实现"可重构责任链"的核心。没有委托链记录,事后追溯几乎不可能。
委托链(delegation chain) 的可追溯性在密码学与安全协议领域有成熟的技术参照:X.509 证书链证明了一条从根证书到叶证书的信任传递路径;SPIFFE/SPIRE 等现代工作负载身份框架则为微服务场景下的服务间委托提供了可验证的身份凭证。对于多智能体系统,理想的委托链记录应当做到:不可篡改(防止事后抵赖)、包含时间戳与调用上下文、并能以结构化方式被自动化工具查询。目前已有研究者探索将类似 W3C PROV 溯源数据模型(provenance data model)应用于 AI 系统的动作追踪,但距离工程化落地仍有较大距离。
自主与授权的边界
在哪里划定自主性(autonomy)与授权(authority)之间的界线? 这是整个讨论的哲学核心。我们希望智能体足够自主以提高效率,又必须约束它的授权范围以控制风险。这条边界画在哪,直接决定了系统的安全性与可用性平衡。
这是当下就该解决的问题吗?
作者也保持了难得的清醒,反问了一句:这究竟是一个现在就值得解决的问题,还是当前的智能体系统仍然太小、还不足以让它成为问题?
这个自我质疑很有价值。在技术早期阶段,过度工程化治理机制可能是浪费。但从趋势看,随着智能体开始自主派生子智能体、调用外部工具、修改真实代码库,权责模糊的风险会呈指数级放大。等到系统足够大、事故足够严重时再补建审计基础设施,往往为时已晚。
从软件工程史来看,身份、审计、溯源这类"基础设施"往往是在早期被忽视、在规模化后被迫补课的。提前思考编排层的权责设计,或许正是多智能体系统走向生产级可靠性的必经之路。
结语
这篇来自一线开发者的思考,触及了多智能体系统一个被普遍低估的软肋:能力可以快速堆叠,但治理必须同步跟上。当你的 AI 智能体开始派生另一个智能体时,"谁为发生的事负责"就不再是修辞,而是必须在架构层面回答的工程问题。
对于正在构建多智能体工作流的团队而言,现在或许就是审视自己系统中身份、委托与溯源机制的好时机——哪怕答案暂时是"我们还没有"。
相关推荐

Grok 4.7或将发布:剑指GPT-6与Claude顶级模型
传闻Grok 4.7或将很快发布,参数规模据称达2.1万亿,剑指GPT-6 Astra与Anthropic顶级模型。本文梳理Grok 4.7、Fable 5.2、Gemini 4 Pro延期及开源小模型MiniCPM-5的最新爆料与行业格局。

GPT-6实用指南发布,ChatGPT财务功能向免费用户开放
10月3日AI早报:OpenAI发布GPT-6系列使用指南,ChatGPT财务功能向美国免费及Go用户开放,Claude Code新增信息提醒插件。另有Meta Muse增长、谷歌Gemini动态、AI科研突破及算力融资等重要进展。

Gemini 4(代号Argon)发布:百万Token自主输出引爆AI圈
谷歌无发布会直接推出代号Argon的Gemini 4,据称实现百万Token单次自主输出、沙盒自我纠错交付工业级代码,并在软件工程评测和网络攻防渗透测试中表现强势。本文梳理核心技术要点并保持审慎分析。