DataBlur:实时模糊屏幕敏感数据的本地化隐私保护工具

屏幕共享时代的隐私痛点
在远程办公、直播演示和录制视频成为日常的今天,屏幕上无意间暴露的敏感信息已经成为一个被严重低估的安全隐患。一封显示在邮箱客户端的邮件、一张未来得及关闭的信用卡账单、一段代码中硬编码的 API 密钥——这些内容一旦出现在直播画面或录屏文件里,就可能造成难以挽回的信息泄露。
传统计算安全模型建立在「屏幕内容仅对物理在场者可见」的假设之上,操作系统的权限控制、窗口管理器的层级隔离都围绕这一前提设计。屏幕共享技术从根本上颠覆了这一假设——它将帧缓冲区(framebuffer)的内容通过网络协议实时传输给远端观看者,等同于将本地显示器的全部视觉信息广播出去。更严重的是,直播平台和会议录制功能意味着这些信息可能被永久存储和无限次回放,使得瞬间的疏忽变成持久的风险敞口。
这绝非杞人忧天。根据多项安全研究,屏幕共享导致的数据泄露事件近年来呈上升趋势。2023年 GitHub 的一项统计显示,每年有数百万个 API 密钥通过公开渠道(包括直播录屏)意外泄露,其中相当部分在被发现前就已被恶意利用。Twitch 主播、YouTube 教程创作者误暴露 AWS 密钥后在数分钟内遭遇数千美元云计算账单的案例屡见不鲜。这类问题的根源在于:屏幕共享打破了传统的信息边界——原本只存在于用户本地的信息,瞬间变成了公开广播内容。
DataBlur 正是针对这一痛点而生。这款登上 Product Hunt 榜单第 11 位(获得 88 票、8 条评论)的工具,主打「在任何人看到之前,实时模糊屏幕上的敏感数据」。它的定位非常清晰:为直播、演示和录制场景提供一道即时的隐私防护屏障。
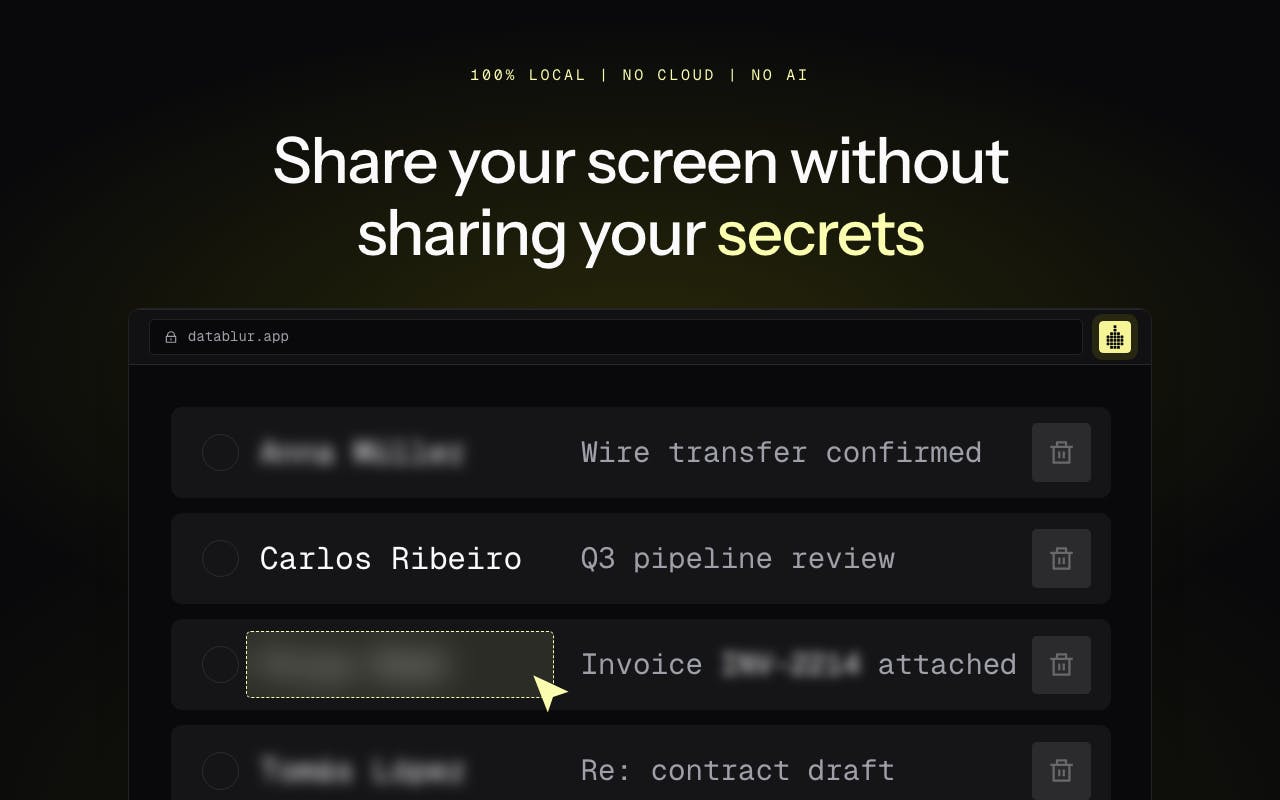
DataBlur 核心功能:实时检测与自动模糊
三类敏感信息的自动识别
DataBlur 的核心能力在于实时自动检测。根据官方介绍,它能够识别屏幕上出现的三类高风险信息:
- 电子邮件地址(emails)
- 银行卡号(cards)
- API 密钥(API keys)
这三类信息恰恰是技术演示和商务直播中最容易暴露、也最具敏感性的数据。开发者在演示后台系统时经常会露出 API 密钥,销售人员在展示 CRM 时可能暴露客户邮箱,而个人用户在处理账单时则面临信用卡信息泄露的风险。DataBlur 在这些内容进入观众视野之前就完成了模糊处理,从根本上避免了「事后补救」的尴尬。
从技术实现角度来看,这三类信息都具有明确的结构化特征,非常适合基于模式匹配的检测方式。邮箱地址包含固定的 @ 符号和域名结构;银行卡号遵循 Luhn 算法校验的 16 位数字序列,且各发卡组织(Visa 以 4 开头、Mastercard 以 51-55 开头)有固定前缀;API 密钥通常具有特定前缀(如 OpenAI 的 sk-、AWS 的 AKIA)和固定长度的字母数字组合。这种结构化特征使得确定性算法能够以极高的准确率完成识别。
值得深入了解的是,Luhn 算法(又称模10算法)是由 IBM 科学家 Hans Peter Luhn 于1954年提出的校验和公式,现已成为 ISO/IEC 7812 国际标准的一部分。几乎所有信用卡号、借记卡号的最后一位都是 Luhn 校验位。算法通过对卡号数字从右向左交替乘以1和2(乘积大于9则减去9),最终求和并验证是否能被10整除来判断卡号的有效性。这一特性使得检测工具能在不访问任何银行数据库的情况下,仅通过数学运算就能以极高置信度判断一串数字是否为有效卡号,同时过滤掉绝大多数恰好为16位的普通数字序列。
「宁多勿少」的安全哲学
DataBlur 有一个值得称道的设计理念:当检测失败时,它会选择模糊更多,而不是更少("When detection fails, it blurs more, not less")。
这一原则体现了工具在安全设计上的保守取向。在信息安全领域,检测系统面临两类核心错误:假阴性(False Negative,即漏报——敏感信息未被识别)和假阳性(False Positive,即误报——非敏感信息被错误标记)。DataBlur 明确选择偏向假阳性的策略,在安全工程中这被称为「fail-safe」或「fail-closed」设计原则,其逻辑与防火墙默认拒绝所有未明确允许流量的策略完全一致。
这两种设计范式源自工业安全工程领域。Fail-safe(故障安全)原则要求系统在组件失效时自动进入最安全的状态——例如铁路信号灯在故障时显示红灯而非绿灯,电梯制动器在断电时自动锁定。在信息安全中,这一原则被形式化为 Saltzer 和 Schroeder 于1975年提出的「默认拒绝」(deny by default)原则:除非明确授权,否则拒绝所有访问。反之,Fail-open 设计(如某些网络交换机在过载时放行所有流量)则优先保证系统可用性。两种范式的选择取决于安全事故与可用性损失之间的代价比较。
与之相对的是「fail-open」设计(宁可放行也不误拦),后者更适用于可用性优先的场景。对于隐私保护工具而言,一次漏报可能导致不可逆的信息泄露(一旦敏感信息出现在直播画面中,即使事后删除录像,观看者已经获取了信息),而一次误报最多只是暂时遮挡了无害内容,代价远小于前者。虽然这可能带来一定程度的「误伤」,但对于隐私保护类工具而言,宁可牺牲部分可用性也要守住安全底线,无疑是更负责任的选择。
100% 本地运行:不依赖云端与 AI
DataBlur 最引人注目的技术定位是它的完全本地化运行。官方明确标注了「100% local: no cloud, no AI, no signup」——不上云、不依赖 AI、无需注册。
隐私工具的隐私悖论
这一定位背后有着深刻的逻辑。市面上许多打着「隐私保护」旗号的工具,本身却需要将用户数据上传至云端进行处理,这就形成了一个尴尬的悖论:为了保护数据而先把数据交出去。DataBlur 通过纯本地化处理彻底规避了这一矛盾——你的屏幕内容从未离开你的设备,自然也就不存在被第三方获取的风险。
从技术层面来看,云端 OCR 和数据处理服务(如 Google Cloud Vision、AWS Textract)虽然在识别精度上通常优于本地方案,但存在三重问题:网络延迟(通常 50-200ms 的往返时间,对于实时屏幕处理来说难以接受)、带宽占用(持续上传屏幕帧数据意味着巨大的网络开销)、以及最核心的隐私风险。本地化方案则完全在设备 CPU/GPU 上完成计算,延迟可控制在个位数毫秒内。
关于本地与云端 OCR 的技术对比值得展开说明:光学字符识别(OCR)技术经历了从模板匹配到深度学习的演进。云端 OCR 服务通常基于大规模训练的卷积神经网络(CNN)和 Transformer 架构,能够处理复杂排版、手写体和多语言混合文本,准确率可达99%以上。本地 OCR 方案则以 Tesseract(Google 开源)为代表,虽然精度略低但无需网络连接。然而 DataBlur 的技术路线更为轻量——它可能完全绕过 OCR,直接通过操作系统的辅助功能 API(如 macOS 的 Accessibility API)获取屏幕上的文本信息,或者拦截应用程序的文本渲染调用,从而在渲染层面而非像素层面完成文本检测,这比传统 OCR 快数个数量级。
从合规角度看,GDPR 等数据保护法规对数据跨境传输有严格限制,纯本地处理天然规避了这些合规负担,这对于处理欧盟客户数据的企业用户尤为重要。具体而言,《通用数据保护条例》(GDPR)自2018年在欧盟生效以来,第44-49条规定向欧盟以外的第三国传输数据需要满足充分性认定、标准合同条款(SCC)或约束性企业规则(BCR)等条件。2020年 Schrems II 判决更是推翻了欧美隐私盾协议,使得数据跨大西洋传输的合规成本急剧上升。在此背景下,纯本地化处理不仅消除了数据传输行为本身,还免除了数据处理者(Data Processor)角色下的 DPIA(数据保护影响评估)义务,大幅简化了企业的合规架构。
「No AI」标签的深层含义
你可能没注意到其「no AI」的表述。在当下几乎所有产品都急于给自己贴上 AI 标签的营销环境中,DataBlur 反其道而行之,强调自己不使用 AI。
2024-2025年的 SaaS 市场中,「AI-washing」(AI 洗白)现象泛滥——大量产品仅因使用了简单的条件判断逻辑或基础统计模型就自称 AI 驱动。这种过度营销已引发用户信任疲劳。AI-washing 一词类比于金融领域的「greenwashing」(漂绿),指企业夸大或虚构其产品中人工智能能力的营销行为。2024年美国证券交易委员会(SEC)已对多家公司的 AI 虚假宣传发起执法行动。与此同时,一股「反AI」或「人工制作」的营销逆流正在兴起——从标注「Not by AI」徽章的内容创作者,到明确声明不使用机器学习的软件产品,这些都在回应市场对 AI 透明度和可控性的需求。DataBlur 明确声明「no AI」,实际上是一种差异化定位策略:它向注重隐私的用户传递了一个清晰信号——你的数据不会被送入任何模型进行训练或推理,不存在通过推理攻击从模型中提取训练数据的风险。
这意味着它采用的是基于规则和模式匹配的传统检测方式,最典型的实现就是正则表达式(Regular Expression)。正则表达式源自20世纪50年代数学家 Stephen Kleene 的正则集合理论,后由 Ken Thompson 在 Unix 系统中首次实现为计算工具。在安全领域,正则表达式被广泛用于入侵检测系统(IDS)、Web 应用防火墙(WAF)和数据泄露防护(DLP)系统中。其核心优势在于确定性有限自动机(DFA)的执行效率——一旦正则模式被编译为 DFA,匹配操作的时间复杂度与输入字符串长度呈线性关系 O(n),执行速度通常在微秒级别,远快于需要进行推理计算的机器学习模型。GitHub 的 secret scanning 功能、git-secrets 等工具同样依赖正则表达式来检测代码仓库中的凭证泄露。这对于实时屏幕处理至关重要——任何可感知的延迟都会破坏直播和演示的流畅性。
此外,这也意味着该工具不存在 AI 系统常见的不确定性行为(如同一输入产生不同输出),其检测结果完全确定性和可审计,这在企业合规审查中是一个重要优势。这种方式虽然在语义理解上不如 AI 灵活,但具备速度快、资源占用低、结果可预测、无需联网等特点,非常适合需要实时响应的屏幕模糊场景。
无需注册的低门槛体验
「无需注册」进一步降低了使用门槛。用户无需创建账户、无需提供个人信息即可使用,这既减少了摩擦,也符合工具本身的隐私承诺——一个真正保护隐私的工具,不应该在使用前先收集用户信息。这种设计理念在隐私优先的产品中越来越常见,Tor 浏览器、Signal 早期版本等都遵循类似的最小化信息收集原则。
DataBlur 适用场景与目标用户
DataBlur 在 Product Hunt 上被归类于**生产力(Productivity)、营销(Marketing)和隐私(Privacy)**三个类别,这也大致勾勒出它的目标用户画像:
- 技术演示者:在展示产品后台、API 调用或数据库时,避免暴露密钥和真实数据。尤其是在 DevRel(开发者关系)和技术布道师群体中,现场 coding 演示和 live debugging 环节是密钥泄露的高发场景。
- 在线教育与直播博主:录制教程时保护屏幕上的个人信息。编程教学视频中经常需要展示终端、IDE 和浏览器,这些环境中散布着大量个人配置信息。
- 销售与市场人员:演示 SaaS 产品时保护客户隐私数据。在使用真实数据而非测试数据进行产品演示时,客户信息保护是合规的硬性要求。
- 远程办公人员:视频会议共享屏幕时的即时防护。据统计,超过 70% 的远程工作者每周至少进行一次屏幕共享,而其中大多数人并未对屏幕内容做预检查。
随着屏幕共享成为工作常态,这类「即时隐私护盾」的需求正在快速增长。DataBlur 抓住的正是一个明确且真实的细分市场。
总结:DataBlur 值得关注吗?
DataBlur 是一款定位精准、理念务实的隐私保护工具。它没有追逐 AI 的浪潮,而是选择了本地化、轻量化、规则驱动的技术路线,用「宁多勿少」的模糊策略守护用户的屏幕安全。
当然,这种设计也存在权衡。纯规则检测在识别非标准格式的敏感信息(如自然语言中提及的密码、非常规排版的卡号、图片中嵌入的文字信息)时可能力有不逮,而「宁可多模糊」的策略在实际演示中也可能造成体验上的干扰——想象一下演示过程中关键内容被误判为敏感信息而被遮挡的尴尬。这些都是它未来需要持续优化的方向,可能需要引入用户自定义白名单、区域排除等精细化控制能力。
但无论如何,DataBlur 提醒了我们一个常被忽视的事实:在人人都能共享屏幕的时代,屏幕本身就是最容易泄密的界面。一款能在信息暴露前主动介入的工具,其价值远比它看起来要大。
相关推荐

Workbuddy零基础入门:桌面AI智能体如何落地工作流
Workbuddy桌面AI智能体零基础教程解读:从安装、积分领取到文件管理与自动化工作流搭建,对比CodeX的适用场景与成本差异,帮助职场人完成从AI提问者到AI管理者的思维转变。

OpenAI智能体新栈:计算机操作、决策API与超速工作流
OpenAI Dev Day发布智能体新栈:Computer Use操作速度超越普通人,Decisions API基于Luna实现极低延迟分类,Agents API开放同源计算机操作能力,GPT-6.1 Sol成本仅为Astra七分之一。本文梳理核心更新、实测数据与开发者落地要点。

梁文峰开源推理框架DeepInfo,硬刚美国禁令
DeepSeek在开源模型后再开源推理框架DeepInfo,包含GPU/CPU交叉流水线、小模型预判大模型复核、华为昇腾与英伟达芯片全面适配等技术,直面美国联邦禁令。本文解析其对AI产业落地的意义与开源策略。