Databricks IP 函数正式 GA:用原生 SQL 搞定 IP 与 CIDR 分析

Databricks IP函数正式GA,内置SQL即可高性能处理IPv4/IPv6与CIDR,CIDR join提速3.1倍、成本降6.4倍。
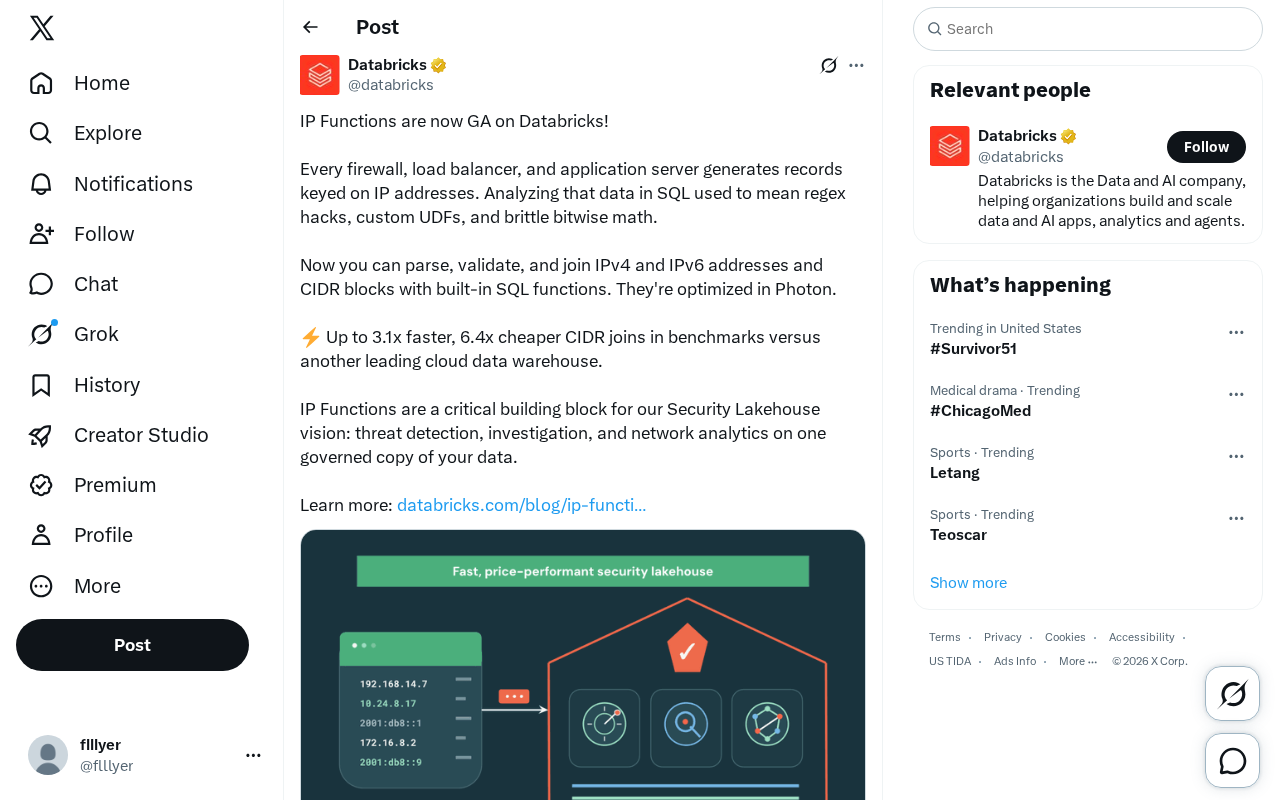
Databricks 宣布 IP Functions 进入 GA 阶段,这组内置 SQL 函数可直接完成 IPv4/IPv6 地址及 CIDR 网段的解析、校验与关联操作,告别过去依赖正则表达式、自定义 UDF 和脆弱位运算的处理方式。函数在 Photon 向量化引擎中获得原生优化,官方基准测试显示 CIDR join 操作相比主流竞品最高提速 3.1 倍、成本降低 6.4 倍,对大规模安全日志分析场景具有实质性的账单意义。Databricks 将其定位为 Security Lakehouse 愿景的关键构建模块,目标是让威胁检测、安全调查和网络分析在同一份受治理的数据上完成,减少跨系统数据搬运和冗余副本,推动安全运营与数据平台的融合。
Databricks 正式宣布 IP Functions(IP 函数)进入 GA(General Availability,正式可用)阶段。这组内置 SQL 函数专门用于解析、校验和关联 IPv4、IPv6 地址以及 CIDR 网段,并针对 Photon 引擎做了性能优化。对于每天处理海量网络日志的安全与运维团队来说,这是一个期待已久的能力补齐。
为什么 IP 分析一直是个麻烦
防火墙、负载均衡器、应用服务器——几乎所有网络基础设施都会持续产生以 IP 地址为键的记录。但在 SQL 中处理这些数据,长期以来并不优雅。
按照官方的描述,过去要在 SQL 里分析 IP 数据,往往意味着三种不太体面的做法:用正则表达式(regex)硬凑、编写自定义 UDF(用户自定义函数),或者依赖脆弱的位运算(bitwise math)。这些方案不仅难以维护,而且在面对 IPv4/IPv6 混合场景、CIDR 网段匹配时极易出错,性能也难以保证。
核心痛点在于:IP 地址本质上是数值化的网络对象,而不是普通字符串。用字符串逻辑去处理 CIDR 子网归属、地址范围判断,既不直观也不高效。这正是内置函数要解决的问题。
CIDR(Classless Inter-Domain Routing,无类别域间路由)是理解这一痛点的关键概念。CIDR 用"地址/前缀长度"的形式(如 192.168.1.0/24 或 2001:db8::/32)来表示一个连续的 IP 地址块。判断某个 IP 是否属于某个 CIDR 网段,本质上是一次位掩码运算:将 IP 地址与子网掩码做按位与,再与网络地址比较。在没有内置函数的情况下,SQL 工程师要么用字符串切割模拟这个逻辑(既繁琐又容易漏掉 IPv6 的 128 位地址),要么写 UDF 封装 Python/Java 的网络库。当需要将数百万条日志记录与数千条 CIDR 规则做关联(join)时,UDF 方案的性能瓶颈尤为突出,因为每行数据都要经历 JVM 或 Python 解释器的调用开销。
IP 函数带来了什么
现在,开发者可以直接用内置 SQL 函数完成以下操作:
- 解析(parse):将文本形式的 IP 地址转为可计算的网络对象
- 校验(validate):判断一个地址或网段是否合法
- 关联(join):把 IP 地址与 CIDR 网段进行匹配关联,这是网络分析中最常见也最耗资源的操作之一
这组函数同时覆盖 IPv4 和 IPv6,以及 CIDR 块。更关键的是,它们在 Photon 引擎中得到了优化——这意味着不再是简单的语法糖,而是从执行层面重构的高性能实现。
性能数据:CIDR Join 快 3.1 倍、便宜 6.4 倍
性能是这次发布最具说服力的部分。根据 Databricks 公布的基准测试,相比另一款主流云数据仓库,其 CIDR join 操作实现了:
- 速度最高提升 3.1 倍
- 成本最高降低 6.4 倍
CIDR join 是网络日志分析里的高频重操作——比如将数百万条访问记录与一张威胁情报网段表做匹配。成本下降 6.4 倍对大规模安全分析场景意味着实打实的账单差异。需要说明的是,基准测试结果通常依赖具体的数据规模与查询模式,实际收益会因场景而异,但方向上无疑是积极的。
Photon 是 Databricks 自研的向量化查询引擎,使用 C++ 编写,能够充分利用现代 CPU 的 SIMD(单指令多数据)指令集,以列式批处理方式执行计算,相比基于 JVM 的传统 Spark 执行引擎在 CPU 密集型操作上有显著优势。IP 函数在 Photon 中获得原生实现,意味着 CIDR 匹配的位运算可以在向量化路径上批量执行,避免了逐行调用 UDF 的解释开销。这也解释了为何成本降幅(6.4 倍)远大于速度提升(3.1 倍)——更快的执行意味着占用计算资源的时间更短,在按秒计费的云环境下,执行时间缩短直接映射为账单金额的下降。
Security Lakehouse 愿景中的关键一块
Databricks 把 IP 函数定位为其 Security Lakehouse 愿景的关键构建模块。这个定位值得单独解读。
传统安全分析往往需要在专门的 SIEM 系统、数据仓库和湖存储之间来回搬运数据,形成多份副本,治理困难。而 Security Lakehouse 的思路是:威胁检测(threat detection)、安全调查(investigation)和网络分析(network analytics)都在同一份受治理的数据副本上完成。
IP 函数的加入,补齐了网络层数据在 SQL 原生处理上的能力短板。当 IP 解析、CIDR 匹配这些底层操作变得既快又便宜,在湖仓上直接做安全分析的技术门槛和成本门槛都被拉低。这与业界近年来将安全运营与数据平台融合的趋势是一致的。
SIEM(Security Information and Event Management,安全信息与事件管理)系统是传统安全运营的核心基础设施,负责汇聚来自网络设备、服务器、应用的日志,并实时关联分析以发现威胁。然而传统 SIEM 普遍面临存储成本高、历史数据留存周期短、与数据科学/机器学习工作流割裂等挑战。Security Lakehouse 的核心主张是用开放格式的数据湖(如 Delta Lake)取代 SIEM 的封闭存储,让安全日志与业务数据共享同一套治理体系,同时支持从实时告警到长周期溯源调查的全谱系分析需求。Databricks 并非这一赛道的唯一玩家——Snowflake、Microsoft Sentinel 以及基于 Elastic 的方案都在尝试类似融合,但 IP 函数的 GA 标志着 Databricks 在网络日志这一核心数据类型上补齐了原生处理能力。
对实际用户意味着什么
对正在使用 Databricks 的团队来说,这次 GA 带来几点直接影响:
- 技术债减少:可以逐步淘汰过去维护的自定义 UDF 和正则方案,用标准函数替代
- 查询更可靠:内置校验逻辑降低了处理 IPv6 等边缘场景时出错的概率
- 成本可控:Photon 优化下的大规模 CIDR join 更划算,适合安全情报匹配类长期运行的任务
对于评估平台选型的安全与数据工程团队,这也是一个信号——Databricks 正在把湖仓从通用数据分析平台,向覆盖安全运营场景的方向延伸。IP 函数本身是个小特性,但它反映出平台在垂直场景能力上的持续填充。
更多细节可参考 Databricks 官方发布的说明文档。
相关推荐
用n8n搭建WhatsApp智能线索自动化:AI分级让商机不再流失
拆解一个基于n8n的WhatsApp线索自动化工作流:用AI把客户消息分为hot/warm/cold四级,自动应答并评分,仅在高价值线索出现时通知老板,帮助中小企业高效管理商机、节省人力。

Arabagent.ai:面向中东市场的托管式N8N自动化方案
Arabagent.ai 面向中东市场提供托管式 N8N 自动化服务,含私有工作空间、无限工作流执行、AI 自愈架构及阿拉伯语双语支持,兼顾开源可控性与 SaaS 便捷。

用 n8n 打造 Gmail→Google Sheets 自动化 CRM 实战教程
手把手教你用 n8n 搭建 Gmail 到 Google Sheets 的 AI 自动化 CRM:收到邮件自动触发,由 OpenAI 读取理解内容并提炼任务信息写入待办表格,含触发器、AI 智能体、提示词与 Sheets 工具的完整配置步骤。