Databricks 实战入门:从 CSV 到部署 ML 模型的完整流程
用 Databricks 免费版完成从 Kaggle CSV 到可调用机器学习端点的企业级全流程实操。
本文梳理了一个基于 Databricks 免费版的端到端机器学习实操教程:以 Kaggle 房价数据集为例,演示如何通过 Unity Catalog 的 Managed Volume 导入数据,用 Spark 进行预处理,再借助 PySpark ML Pipeline 串联特征工程与随机森林回归模型完成训练,并通过 MLflow 实现指标追踪、模型签名与版本注册。预测结果以 Delta 表形式持久化,支持 SQL 查询与版本管理;模型最终通过 Databricks Model Serving 部署为线上端点,可从本地 Python 脚本凭 Bearer token 调用推理。文章强调,这套流程的价值不在于模型精度,而在于展示 Databricks 覆盖数据到部署全链路的企业级能力,是 MLOps 方向求职者的重要技能储备。
Databricks 是企业级生产环境中广泛使用的 AI/ML 一体化平台。它基于 Spark 构建,主打大规模数据集和分布式计算场景,覆盖了从数据摄取、预处理、特征工程、模型训练评估,到版本管理与部署的完整链路。这不是那种用来做玩票项目的工具,而是真正会出现在招聘要求和自由职业项目中的技能。
本文基于一位 YouTube 技术博主的实操教程,完整梳理如何用 Databricks 免费版将一个 Kaggle 房价数据集(两个 CSV 文件)变成一个可对外调用的机器学习模型端点。整个流程无需付费功能即可复现。
为什么 Databricks 值得学
博主坦言这期视频由 Databricks 赞助,但他的态度基于真实经历:此前申请一个 MLOps 方向的自由职业项目时,Databricks 正是对方(一家知名大公司)的核心技能要求,因为他们内部所有机器学习流程都跑在这个平台上。
这说明 Databricks 的定位非常清晰——它面向企业级、生产级的数据与机器学习工作流,而非个人小项目或初创公司的临时方案。如果你打算进入企业级机器学习、MLOps 或 AIOps 方向,掌握 Databricks 是一项高价值技能。它的核心焦点始终是大规模与分布式。
平台的一个特点是高度以 UI 为中心,命令行交互较少,这让它显得没那么“极客”,但也降低了上手门槛——是否喜欢这种风格因人而异。
数据上传:Volume 与 Unity Catalog
Databricks 初次登录会让人有点摸不着头脑,因为它不是为单一任务设计的。你不是“进 Databricks 去训练模型”或“去上传数据集”,而是所有环节都在这里完成——上传文件、写 Notebook、预处理、训练、部署、调度任务,一站式搞定。
实操第一步是从 Kaggle 下载房价数据集的 train.csv 和 test.csv(这是一个回归问题,预测房价)。正确的导入方式是进入 Catalog,创建一个新的 Managed Volume:给它命名(如 tutorial_volume),选择由 Unity Catalog 管理存储,指定 catalog(workspace)和 schema(default),然后把两个 CSV 上传进去。
上传后,这些文件就被纳入整个 Databricks 生态,可以被其他组件访问、可以跑 SQL 查询,也可以在 Notebook 中直接读取。
Unity Catalog 是 Databricks 的统一数据治理层,于 2022 年正式发布。它在整个组织范围内提供集中式的元数据管理、权限控制和数据血缘追踪,管理粒度可精确到列级别。其层次结构为:Metastore → Catalog → Schema(数据库)→ Table/Volume/Function。Managed Volume 则是 Unity Catalog 中用于存储非结构化文件(如 CSV、图片、模型文件)的逻辑容器,与 Delta 表并列作为一等公民受到平台管理,生命周期和访问权限都由 Unity Catalog 统一控制。相比直接将文件扔到云存储桶(如 S3 或 ADLS),通过 Volume 上传的文件会自动继承 Catalog 的权限体系,团队成员无需手动配置云存储访问密钥,也无需关心文件的底层存储路径,大幅简化了多人协作和合规审计的复杂度。
用 Spark 加载与预处理数据
接着新建一个交互式 Python Notebook。它类似 Python 脚本,但支持分单元格执行,后台 kernel 会维护状态,无需从头跑到尾。博主还提到可以通过 Ctrl+Shift+P 开启 Vim 键位模式,这对习惯 Vim 的开发者是加分项。
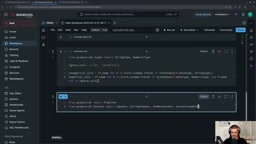
数据加载使用 Spark:spark.read.option("header", True).option("inferSchema", True) 读取 Volume 中的 CSV。博主坦率指出,对这个数据集而言 Spark 其实是“杀鸡用牛刀”——用 pandas 和 scikit-learn 单机就能搞定。但既然目标是演示企业级工作流,就刻意用 Spark 编写,并运行在 serverless 上,由 Databricks 自动扩缩容分配算力,面对真正的大数据集时才能体现价值。
预处理刻意保持简单:先做 80/20 的训练/验证集划分;所有字符串列视为类别特征做 one-hot 编码,所有数值列用中位数策略做缺失值填充。ID 列和目标列 sale_price 被排除在外。
构建 Pipeline 与训练随机森林
特征工程通过 PySpark ML 的 Pipeline 串联:Imputer(数值列中位数填充)→ StringIndexer(类别列索引化)→ OneHotEncoder(独热编码)→ VectorAssembler(组装成特征向量)→ RandomForestRegressor(200 棵树、最大深度 10)。
One-hot 编码的原理博主用画图做了说明:比如一个 country 列有 AT、DE、US 三个取值,编码后会拆成三列,用 0/1 表示某行属于哪个类别,本质是把类别值转成二进制激活向量。
用 MLflow 追踪、注册与部署模型
训练环节的重点是 MLflow。它不负责训练本身,而是负责追踪与记录。通过 with mlflow.start_run() 包裹训练过程,记录 RMSE 和 R² 两个指标。

最终结果 R² 约为 89.78%,RMSE 约 27,743。博主强调模型精度不是重点——预测值大致在正确量级(如预测 217,000 实际 223,000),但确实存在一定误差,重点是展示 Databricks 的完整能力。
要保存模型,需用 infer_signature 定义模型的输入输出签名,再通过 mlflow.spark.log_model 记录。注册到 Unity Catalog 时,必须将 registry URI 设为固定字符串 databricks-uc,然后用 mlflow.register_model 注册,Databricks 会自动支持模型版本管理。
之后在全量训练集上重新拟合得到最终模型,对测试集做预测,并把结果存为 Delta 表而非普通 CSV。Delta 表的优势在于它融入整个平台——支持可靠事务、版本管理、SQL 查询、仪表盘等。存好后可在 Catalog 中直接写 SQL 查询,比如 SELECT * FROM ... WHERE sale_price > 200000。
MLflow 是 Databricks 于 2018 年开源的机器学习生命周期管理框架,目前已成为行业标准之一。它由四个核心组件构成:Tracking(记录参数、指标、代码版本和产物)、Projects(打包可复现的训练代码)、Models(统一模型格式与多框架部署接口)和 Registry(模型版本管理与阶段晋升,如 Staging → Production)。在 Databricks 中,MLflow 被深度集成,每个 Notebook 运行自动关联一个 Experiment,无需额外配置即可在 UI 中对比多次实验的指标曲线。infer_signature 的作用是自动推断模型输入数据的 schema(列名与数据类型)和输出格式,并将其序列化到模型元数据中——这一签名在后续部署为端点时会被用于请求体的格式校验,避免线上推理因数据格式不匹配而静默出错。将 registry URI 设为 databricks-uc 是专门告知 MLflow 客户端将模型注册到 Unity Catalog(而非旧版 Workspace Registry),从而让模型同样受益于 Catalog 的权限管理与血缘追踪能力。
Delta 表基于 Delta Lake 格式,是 Databricks 力推的开源存储层。本质上是在 Parquet 文件之上增加了一个事务日志(_delta_log),从而支持 ACID 事务、Time Travel(按版本或时间戳查询历史数据)、Schema Enforcement 和高效的增删改操作。相比将预测结果存为普通 CSV,Delta 表的版本管理特性让你可以随时回溯到任意历史时刻的预测快照,事务保证则防止并发写入导致的数据损坏——这在多个 Job 同时向同一结果表写入时尤为重要。
部署端点并从本地调用
最后一步是模型服务化。在 Models 区域选中注册好的模型,点击 Serve,命名端点(如 tutorial_endpoint),选择 4GB 内存 CPU 版本、开启“空闲缩放到零”,创建即可。端点上线后会得到一个 URL。
调用需要认证。在用户设置 → Developer → Access Token 中生成一个带 model serving inference 权限的 token,放入本地 .env 文件。本地 Python 脚本依赖 pandas、python-dotenv、requests,将 token 作为 Bearer 头,向端点的 invocation URL 发送 POST 请求,传入一条测试数据(去掉 ID 列),即可拿到该房屋的预测价格。
至此就完成了从 CSV 到线上可调用模型的端到端流程。博主强调,左侧还有大量未涉及的功能——Jobs、Pipelines、Compute、AI Gateway、Agents、模型 Playground 等,可探索空间几乎是无限的。对于要走企业级机器学习路线的人来说,这是一个值得注册免费版亲自体验的重要平台。
相关推荐

只想要一个自定义域名邮箱,为何如此艰难?
拥有一个自定义域名邮箱看似简单,实则涉及 SPF/DKIM/DMARC 配置、IP 信誉、托管服务成本等诸多难题。本文梳理自建与托管方案的权衡,并给出实用建议。

Claude意外帮用户发现燃气泄漏:AI助手的安全应用边界
一位Reddit用户借助AI助手Claude识别出家中燃气泄漏隐患,PG&E上门确认并修复。本文分析AI助手在家庭安全场景中的真实价值与使用边界,以及处理燃气泄漏的正确做法。

Gemini 4 Argon发布:谷歌重返前沿,但故事没那么简单
谷歌时隔半年发布前沿模型Gemini 4 Argon,跑分重返一线却暂不开放。本文解析其基准表现、与Sonnet 5.5的竞争,以及模型能力与产品体验之争。