DEEPO:双熵增强策略优化,破解多模态大模型幻觉难题
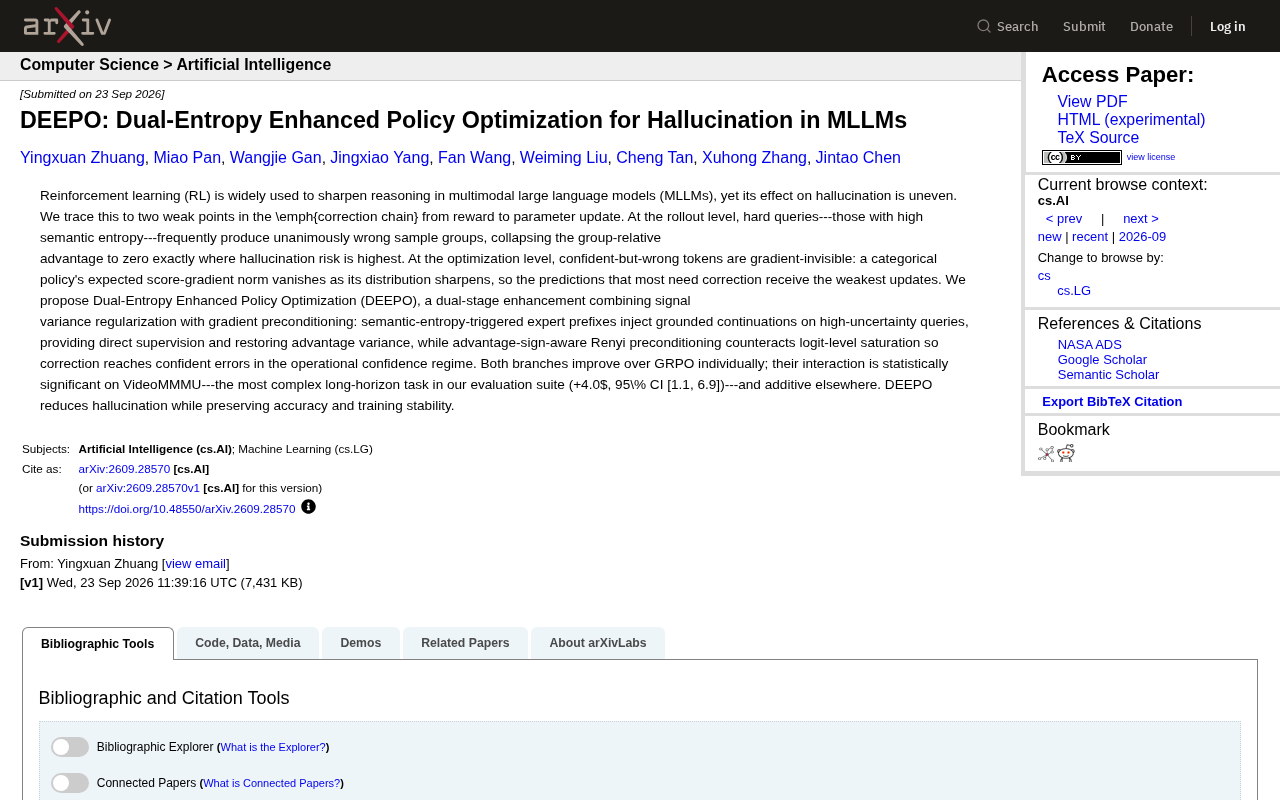
DEEPO通过语义熵触发监督注入与Renyi梯度预处理,修复RL训练中抑制多模态大模型幻觉的两处结构性漏洞。
多模态大语言模型(MLLM)在引入强化学习(RL)后,幻觉抑制效果仍不稳定。论文DEEPO指出根源在于"修正链条"的两处薄弱环节:一是高语义熵难题上采样组全部出错,导致组相对优势坍缩为零,模型在最需要学习的地方反而得不到梯度;二是"自信但错误"的token因输出分布过于尖锐,score-gradient范数趋近于零,梯度无法纠正最笃定的错误预测。针对这两个痛点,DEEPO设计了双分支方案:用语义熵触发的专家前缀恢复优势方差,用优势符号感知的Renyi预处理抵消logit饱和。实验显示,在最复杂的VideoMMMU任务上相比GRPO基线提升+4.0,同时保持准确率与训练稳定性。
多模态大语言模型(MLLM)在推理能力上突飞猛进,强化学习(RL)功不可没。但一个尴尬的事实是:RL 对模型"幻觉"(hallucination)的抑制效果参差不齐——有时能压制幻觉,有时反而无济于事。arXiv 上一篇题为《DEEPO: Dual-Entropy Enhanced Policy Optimization for Hallucination in MLLMs》的新论文,把矛头指向了从奖励到参数更新之间的"修正链条",并提出了一套双阶段增强方案。
RL 抑制幻觉为何时灵时不灵
论文的核心洞见是:现有基于组相对优势(group-relative advantage)的 RL 方法,在"修正链条"上存在两个薄弱环节,恰恰都出现在幻觉风险最高的地方。
第一个薄弱点出现在 rollout(采样)阶段。对于那些语义熵(semantic entropy)很高的"难题",模型往往会生成一整组"全军覆没"的错误样本。当一组采样结果全部错误时,组相对优势会坍缩为零。换句话说,在最需要学习信号的高不确定性场景,模型反而拿不到任何有效的梯度反馈。
第二个薄弱点在优化层面。所谓"自信但错误"(confident-but-wrong)的 token 是"梯度不可见"的:对于一个类别策略(categorical policy),随着输出分布变得越来越尖锐(sharp),其期望的 score-gradient 范数会趋近于零。这意味着那些模型最笃定、却又恰恰错得离谱的预测,得到的更新反而最微弱。这正是幻觉难以根除的深层机制之一——模型对错误答案过于自信,梯度却奈何不了它。
**语义熵(Semantic Entropy)**是衡量模型输出语义多样性的指标,由 Kuhn 等人于 2023 年提出。与普通的 token 级别熵不同,语义熵将含义相近的多个输出聚合为同一语义类别,再在这些类别上计算熵值。一个问题的语义熵高,意味着模型对该问题的"理解方向"本身就非常分散——不仅措辞不同,连语义意图都大相径庭。这类问题往往对应视觉信息模糊、问题开放性强或知识边界模糊的场景,恰好是多模态模型最容易产生幻觉的地方。**组相对优势(Group-Relative Advantage)**则是 GRPO 等方法的核心机制:对同一个问题采样多条输出,以组内平均奖励为基准计算每条输出的相对优势,从而替代传统 RL 中难以估计的价值函数。其前提是组内必须存在奖励差异;一旦所有样本的奖励相同(例如全部为零),优势值均为零,梯度信号随即消失。
DEEPO 的双分支设计
针对上述两个痛点,作者提出了 Dual-Entropy Enhanced Policy Optimization(DEEPO),一个结合"信号方差正则化"与"梯度预处理"的双阶段增强方法。
语义熵触发的专家前缀
第一条分支解决 rollout 层面的优势坍缩问题。当检测到某个查询的语义熵过高时,系统会注入"专家前缀"(expert prefixes),即基于事实的引导性续写。这相当于在高不确定性问题上直接提供监督信号,从而恢复优势的方差。有了方差,模型才能重新获得可用于学习的梯度差异,避免在难题上"躺平"。
**专家前缀(Expert Prefixes)**本质上是一种条件化的监督注入机制。在标准 RL 采样中,模型完全从自身分布出发生成回答;而注入专家前缀后,模型的后续生成被"锚定"在一个事实正确的起点上,从而大幅提升采样组内出现正确答案的概率。这与"拒绝采样微调"(Rejection Sampling Fine-tuning)或"思维链蒸馏"有一定相似性,但关键区别在于它是动态触发的——只在语义熵超过阈值时介入,而非对所有问题一律施加监督,从而避免过度压缩模型的探索空间。这种设计在工程上也有其合理性:对于语义熵低的"易题",模型本身已能采样到正确答案,强行注入前缀反而会引入偏差;只在"难题"上介入,则是以最小代价恢复学习信号的精准干预。
优势符号感知的 Renyi 预处理
第二条分支针对优化层面的 logit 饱和问题。作者引入了"优势符号感知的 Renyi 预处理"(advantage-sign-aware Renyi preconditioning),用以抵消 logit 层面的饱和现象。其目标是让修正信号能够真正抵达那些"自信错误"的预测——即在实际运行的置信区间内,把梯度重新导向最该被纠正的地方。
这两条分支各自独立于 GRPO(Group Relative Policy Optimization)基线之上都有提升,而它们的协同作用在最复杂的任务上尤为明显。
Renyi 预处理的思路来源于信息几何与自然梯度方法。标准梯度下降在参数空间中以欧氏距离衡量更新步长,而预处理方法通过引入曲率信息(如 Fisher 信息矩阵)来重新缩放梯度,使更新步长在概率分布空间中更加均匀。Renyi 散度是 KL 散度的推广,可以通过调节阶数参数来控制对分布尾部或峰值的敏感程度。在 logit 饱和的场景中,模型对某个 token 的输出概率已经极度接近 1,欧氏意义上的梯度范数趋近于零,但该预测在概率分布空间中仍有可观的"移动余地"。Renyi 预处理通过重新参数化这一曲率关系,使得即便在高置信度区域,梯度信号也能有效传递,从而让"自信但错误"的预测真正受到惩罚。优势符号感知则指预处理的方向会根据当前 token 对应的优势正负号进行调整,确保正确预测得到强化、错误预测得到抑制,而不是对两者施加相同强度的干预。
实验结果与意义
论文在评估套件中最复杂的长程任务 VideoMMMU 上观察到,两条分支的交互效应具有统计显著性:相比基线提升 +4.0(95% 置信区间 [1.1, 6.9])。在其他任务上,两条分支的效果则呈现可加性(additive)——即两者相加不会互相抵消。
更关键的是,DEEPO 在降低幻觉的同时,保持了模型准确率与训练稳定性。这一点很重要:许多针对幻觉的干预手段会以牺牲整体性能或训练稳定性为代价,而 DEEPO 声称做到了三者兼顾。
从方法论角度看,DEEPO 的价值不仅在于两个具体技巧,更在于它把"幻觉"这个模糊的现象,拆解为可分析、可干预的两个数学环节——优势坍缩与梯度不可见。这种"顺着修正链条找漏洞"的思路,为后续多模态 RL 对齐研究提供了一个清晰的分析框架。
小结
DEEPO 提醒我们,幻觉并非单纯的"数据不足"或"模型不够大"问题,而可能是训练动力学层面的结构性缺陷。当高不确定性问题的学习信号被抹平、当自信错误逃过梯度更新,再多的 RL 训练也难以触及幻觉的根源。通过语义熵触发的监督注入与 Renyi 梯度预处理这一"组合拳",DEEPO 为多模态大模型的可靠性提升提供了一条值得关注的技术路径。
相关推荐
人类能离太阳多近?帕克探测器穿越日冕的科学原理
人类能离太阳多近?NASA帕克太阳探测器曾飞至光球层上方380万英里,深入数百万度的日冕。本文解析为何探测器不会被汽化——温度与热量的区别、阳光强度及隔热罩设计的科学原理。
从空气中制造汽油:合成燃料为何尚未普及?
合成燃料能用空气中的二氧化碳、水和电力制造汽油、甲烷和火箭推进剂。本文解析萨巴蒂埃反应与费托合成的化学原理、热力学税、碳中和账本,以及合成燃料为何尚未普及、又将如何重塑能源地缘格局。
Router Rumble:用WiFi路由器演示梯度下降为何败给NSGA-II
Router Rumble 是一个开源 Python 项目,通过在模拟房间摆放 WiFi 路由器,直观对比梯度下降与 NSGA-II 进化算法在离散目标函数上的表现,揭示无梯度优化方法的优势。