DeepSeek Harness企业落地实战:从Agent原理到多项目开发

从Agent四重角色到DeepSeek Harness企业落地路径与八个实战项目的系统梳理。
本文基于B站UP主大宇老师的直播课,系统梳理了DeepSeek Harness的企业级落地路径。文章首先用「翻译官」比喻解释了Agent为何不可或缺——它弥补了原生大模型没有记忆、知识截止、无法联网、无法调用本地工具四大短板,并扮演翻译官、工具达人、记忆管家、任务管家四重角色。随后介绍了围绕DeepSeek Harness的近八个实战项目,覆盖LMVK自动化开发、Skill批量生成、电商多模态Agent等方向,强调不要求深厚技术背景而重在理解逻辑。文章还给出零基础学习路径建议,指出应先理清思路再看源码,并批评同质化教程的弊端。最后简述了Agent从工具调用到工程化底座的三阶段演进。
在AI大模型快速迭代的当下,如何将DeepSeek Harness真正落地到企业项目中,是许多开发者与转型者最关心的问题。B站UP主大宇老师在一期近一个半小时的直播课中,以零技术门槛为起点,系统讲解了DeepSeek Harness的企业级落地路径,并抛出近八个实战项目作为演练目标。本文基于该视频内容,梳理其中的核心观点与技术逻辑。
为什么Agent是大模型落地的关键
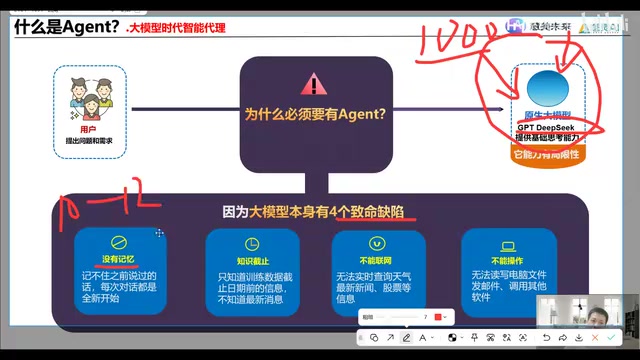
很多初学者会问:既然已经有了GPT、DeepSeek广告这样的原生大模型,为什么还需要Agent?大宇老师在直播中给出了一个形象的比喻——Agent就是大模型时代的"翻译官"。
原生大模型存在几个天然短板。第一,没有记忆:你跟它聊了十轮对话,第十二轮时它已经忘了前十轮的内容。第二,知识截止:模型只学到某个时间点,问它之后的事情,它会一本正经地胡说八道。第三,无法联网:问它明天的天气或股票走势,它同样无能为力。第四,无法调用你电脑上的工具。
Agent的出现正是为了解决这四个问题。它扮演四种角色:翻译官,把用户需求翻译成大模型能理解的指令;工具达人,帮大模型调用API实现联网与数据处理;记忆管家,维持多轮对话的连贯性;任务管家,将复杂问题拆解成小步骤并规划执行流程。
大宇老师特别指出,普通人日常使用的豆包、DeepSeek等产品,本质上都是Agent在背后运作——你的问题先发给Agent,Agent再调用大模型处理,最后把加工后的结果返回给你。
什么是大模型的「记忆」与「上下文窗口」
原生大模型所谓的「没有记忆」,本质上是其推理机制决定的。大模型每次回答时,只能看到当前传入的这段文本——也就是「上下文窗口」(Context Window)。它并不像人类那样拥有持久记忆,上下文窗口关闭后,这一轮对话的内容就不再被模型保留。所谓「多轮对话」,其实是Agent在每一轮把历史对话重新拼接进上下文,再次发给大模型而已。因此上下文窗口的长度直接决定了「记忆」的上限,一旦超出就会被截断或压缩。这也是为什么Agent需要专门的记忆管理模块,通过摘要、向量检索等方式,把关键信息从长对话中抽取出来,在有限窗口内保留最重要的内容。
「知识截止」与RAG的由来
大模型的知识来自训练时所用的语料,训练完成后参数就会被冻结,因此它的知识存在一个时间截止点。对于截止点之后的新闻、企业内部文档、私有数据,模型天然无从知晓,强行回答就容易产生「幻觉」(Hallucination),也就是看似合理实则编造的输出。业界应对这一问题的主流方案是RAG(Retrieval-Augmented Generation,检索增强生成):先从外部知识库中检索出相关内容,再把检索结果作为提示词的一部分喂给大模型,让它基于这些真实材料作答。文中提到的企业管理知识库、图片知识图谱,本质上都属于给大模型「外挂知识」的RAG思路,从而绕过知识截止和幻觉这两个根本性限制。
DeepSeek Harness能做什么:实战项目概览
直播中最引人注目的部分,是围绕DeepSeek Harness展开的近八个实战项目。这些项目覆盖了从自动化开发到多模态应用的多个方向。
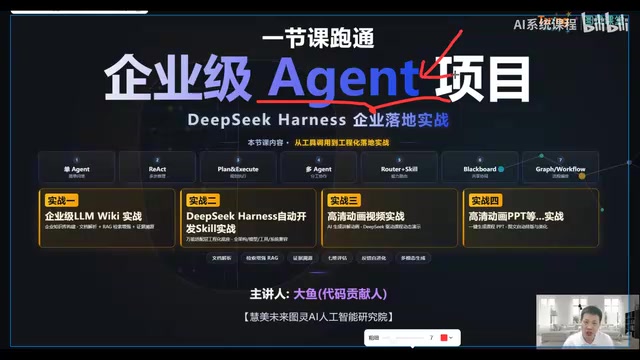
第一个方向是自动化开发LMVK类项目,涉及项目工作台、企业管理知识库、图片知识图谱和评估系统等技术模块。第二个方向是用DeepSeek Harness自动化开发Skill,针对当前大量开发者手动编写Skill的效率瓶颈,通过Harness实现批量自动化生成。第三个方向结合电商场景,开发多模态Agent——用户只需与DeepSeek进行实时对话,外挂专属开发的Skill和插件,就能构建出真实可用的电商领域Agent,同时涉及模型微调在特定场景下的应用。
这些项目的共同特点是:不要求学员具备深厚的技术背景,而是强调理解逻辑思路后,结合提供的项目源码去适配自己的业务场景。
Skill、插件与工具调用
文中所说的Skill(技能),可以理解为一段封装好的、可被Agent按需调用的能力单元,比如「查询订单」「生成周报」「调用某个内部API」。它通常由一段描述(告诉模型这个Skill能做什么、需要什么参数)加一段可执行代码组成。Agent在推理时根据用户意图,自动判断是否需要调用某个Skill,并填充参数、执行、再把结果纳入后续推理。插件(Plugin)概念与Skill高度重叠,更多强调对第三方系统的对接。文中提到的「批量自动化生成Skill」,指的是用DeepSeek Harness本身去产出这些能力单元,把原本需要人工手写的Skill开发流程自动化,从而解决开发者逐个手写Skill效率低的问题,这其实是「用Agent造Agent」的一种自我增强思路。
零基础如何选择学习路径
大宇老师在直播中反复强调一个判断:当前大模型应用赛道类似于十几年前的Java和安卓爆发期,岗位多、人才少,是"卷技术和项目"而非"卷学历"的阶段。他建议关注AI大模型领域的同学抓住政策方向去学习,否则容易陷入迷茫。
对于零基础学员,他给出的具体建议是:重点听思路而非纠结代码细节,先把整个逻辑链路理清楚,拿到项目源码后再结合自己的场景去复现和改造。他同时批评了当前网上大量同质化的教程——"全国都是一个模子出来的,只会写一二三,反过来让你写三二一就不会了",认为这是很多人学了一两年仍原地踏步的根本原因。
Agent技术演进的三个阶段
直播后半段,大宇老师简要梳理了Agent技术的三次跃迁:从早期的工具调用,到编程编排,再到当前的工程化底座阶段。这一演进轨迹反映出Agent正从单点能力走向系统化工程。
不过由于直播时间限制,这部分内容尚未充分展开。从已有信息来看,DeepSeek Harness的定位更偏向工程化底座——它试图解决的是如何将Agent能力标准化、可复用地嵌入企业开发流程,而非停留在单次对话或简单工具调用的层面。
工程化底座与可复用性
所谓「工程化底座」,指的是把Agent开发中反复出现的通用能力——如提示词管理、工具注册、记忆存储、任务编排、日志与评估——沉淀为一套标准化的框架或平台,让开发者不必从零搭建每一个Agent。它与前两个阶段的差别在于关注点的转移:工具调用阶段解决的是「能不能做」,编程编排阶段解决的是「怎么把多步串起来」,而底座阶段解决的是「如何让千百个Agent稳定、可维护、可复用地上线」。对企业而言,底座的价值尤其体现在降本增效上——不同业务线的Agent可以共享同一套记忆、工具和评估机制,避免重复造轮子,也让Agent能力能够像积木一样被嵌入既有的开发流程。
总结
这场直播的核心价值在于两点:一是用通俗的比喻讲清了Agent在大模型生态中的位置和不可替代性;二是给出了从零基础到企业级项目的学习路径建议。对于正在考虑AI转型的开发者来说,理解Agent解决的问题比掌握某个具体工具更重要——工具会迭代,但"翻译、工具调用、记忆管理、任务拆解"这四层能力框架,是理解所有Agent产品的通用钥匙。
相关推荐

iPhone Duo续航实测:一天一充跑不掉,大屏是耗电元凶
iPhone Duo续航实测:重度使用一天需至少充电一次,6.5小时亮屏约剩30%电量。大屏展开频率是耗电关键,MagSafe电池背夹可救场,长期衰减同样值得关注。

Kimi K3.1 Pro开源发布:2.8万亿参数逼近Opus
Moonshot发布开源MoE模型Kimi K3.1 Pro,2.8万亿总参数、1040亿激活参数,Terminal Bench 4.0仅落后Opus 5.5不到1分,单任务成本约三分之一,API价格减半,开源权重11月4日开放。

Costco科技产品价格竞猜:显示器、键鼠、Bose音响值不值?
YouTube博主在Costco竞猜科技产品价格:2K 180Hz显示器、罗技键鼠、Bose音响和CyberPower UPS实测估价,揭示仓储会员店的选品定价逻辑与品牌溢价真相。