DeepSeek Harness实战:10轮提示构建工业级LLM Wiki知识库

用DeepSeek Harness通过10轮提示、Skills与Agent预设的组装式开发,完成工业级RAG知识库系统。
本文介绍了一期使用 DeepSeek Harness(DSH)完成 LLM Wiki 知识库项目的公开课案例。整个项目仅用 10 轮专业提示,配合 8 个 Skills、一套 Agent 预设和两个功能插件,搭建出具备可溯源问答、双形态知识图谱、增量编译和在线评估能力的完整系统。文章的核心方法论是"先组装、后开发":根据具体任务为 Agent 配置 Skills 补充领域上下文、用插件覆盖绘图与验收薄弱环节、用预设将开发规范和流程约束固化下来,以保证长链路任务中 Agent 行为的一致性。文章同时提醒,"超过 Codex 和 Claude Code"属主观判断,"10 轮提示"也隐去了单轮复杂度,读者应将注意力放在流程拆解和组件化配置方法上,而非工具优劣结论。
用10轮提示搭出一个完整知识库系统
当下的Agent编程工具竞争激烈,Claude Code、Codex都在抢占开发者心智。而这期公开课选择用 DeepSeek广告 Harness(简称DSH)来验证其工业级开发能力,交出的答卷颇具说服力——整个 LLM Wiki 知识库项目,从零搭建开发环境到最终交付,只用了 10 轮专业提示,外加 8 个 Skills、一套 Agent 预设和两个功能插件。
按照原作者的评价,这套工具"强到离谱",开发过程"异常稳定、效率极高",个人体验甚至超过了 Codex 和 Claude Code。这类主观判断需要谨慎看待,但 10 轮提示完成一个功能完整的复杂项目,确实是一个值得拆解的案例。
LLM Wiki 到底是什么
LLM Wiki 是今年比较火的一类知识库形态,核心在于把散落的资料采集、编译成结构化知识,再通过检索增强的方式支撑问答。这个项目最终实现的功能相当完整:
- 样式美观的工作台 Dashboard,承载整体操作入口;
- 完整的文档管理、编译、上传能力,并支持查阅 Wiki 编译结果;
- 增量文档编译,不必每次全量重编,适合持续更新的知识库场景;
- 双形态知识图谱,可直观查看知识之间的关联结构;
- 可溯源的知识库问答,任何回复都能关联回原始知识片段,这是降低大模型幻觉、提升可信度的关键设计;
- 在线评估与优化,可根据检索命中率、证据覆盖率等指标,反向优化编译方式和检索流程。
其中"可溯源问答"和"在线评估"两点最有工业价值。前者让答案可追溯、可验证,后者把知识库质量从"凭感觉"变成"看指标",形成采集→编译→问答→评估→优化的闭环。
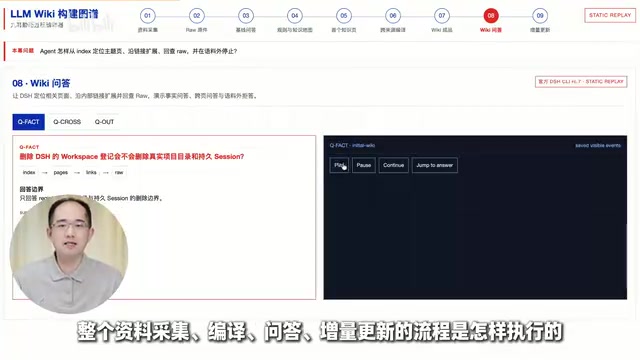
这里提到的"检索增强"即 RAG(Retrieval-Augmented Generation)技术,是当前知识库问答系统的主流架构。其核心思路是:不让大模型凭记忆直接回答,而是先把用户问题转换成向量,在预先建好的知识向量库中检索出最相关的文本片段,再把这些片段作为上下文"喂"给模型,让模型基于真实材料生成回答。这样做的好处是双重的——一方面显著降低模型"胡编"的概率(即幻觉问题),另一方面让每条回答都可以附上来源引用,便于人工核查。"可溯源问答"正是 RAG 架构的自然产物:系统知道答案依赖了哪些原始片段,就能把这些片段作为证据一并呈现给用户。"在线评估"则通过检索命中率、证据覆盖率等指标量化 RAG 管道的质量,从而指导知识切片策略、向量模型选型和检索参数调优。
关键在于给 Agent 做"功能组装"
这期内容真正有方法论价值的部分,是提出了用好 DSH 的核心思路:根据实际开发目标,对 Agent 进行功能组装。
不是直接甩一句需求给模型,而是先围绕任务配置好三类组件:
Skills:补充意图与辅助开发
本次项目装配了一系列 Skills,用于补充意图信息和辅助开发。据作者介绍,这些 Skills 是从为复训学员提供的 Agent 库中 400 多个 Skills 里挑出来的几个。Skills 的作用类似于给 Agent 预装了特定领域的"工作手册",让它在理解需求和执行时少走弯路。
Skills 在 Agent 框架中的作用类似于"系统提示的模块化单元"。传统做法是把所有背景知识、约束规则和示例全部堆入一条超长系统提示,既难以维护,也容易在长对话中被模型遗忘。Skills 机制将这些信息拆分成独立的、可按需加载的知识块:需要哪个领域的上下文,就挂载对应的 Skill,Agent 在推理时会优先参照其中的规范和示例。这种做法的好处在于复用性强——一个"代码审查规范" Skill 可以同时用于多个项目,而不必每次重写;对于长链路任务,按阶段激活不同 Skill 还能缓解上下文窗口的压力,让 Agent 在每个阶段只"看到"最相关的指导信息。
插件:绘图与验收
项目用到了两个插件:
- DSH Diagram:辅助绘制流程图、随时查看项目结构;
- DSH Build-in Browser:辅助进行产品页面的功能验收。
一个管设计可视化,一个管结果验证,覆盖了开发过程中的两个薄弱环节。
Agent 预设:被称为"最强隐藏功能"
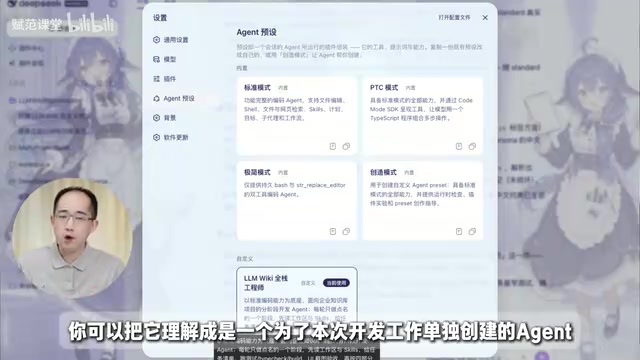
作者专门为本次开发创建了一个 Agent 预设,可以理解为一个针对该任务定制的 Agent,职责是严格执行 LLM Wiki 的开发流程,并灵活调用相关插件和 Skills。原文把 Agent 预设称为 DSH 的"最强隐藏功能",认为用好它能让 Agent 性能实现"跨越式提升"。
这个判断背后的逻辑是合理的:预设相当于把开发规范、流程约束和工具调用策略固化下来,让 Agent 在长链路任务中保持一致性,而不会越做越跑偏。
11 个阶段的标准化开发流程
LLM Wiki 是一个相对复杂的项目,整体被拆成了 11 个开发阶段,严格遵循:环境搭建 → 项目基座开发 → 核心功能模块开发 → 功能验收 这条主线。作者强调这也是当下最标准的 Agent 开发完整流程。
教程的呈现方式是"看得到输入、看得到输出、还讲中间原理":
- 展示每个阶段的输入提示词;
- 展示执行过程以及中间补充的每一段提示内容;
- 展示阶段性成果截图;
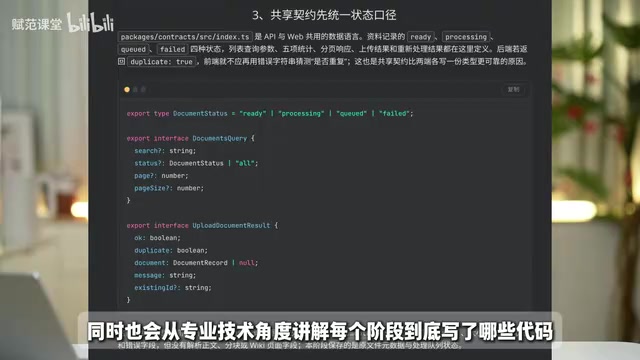
- 从专业角度讲解写了哪些代码、各自作用是什么。
这种"提示流程 + 代码讲解"双轨并行的方式,对零基础学习者比较友好——即便前期不懂原理和代码,也能跟着提示一步步做出成果;而有基础的人则能同时理解背后的实现逻辑。
这套实战的价值与需要注意的地方
从方法论角度,这期内容最值得借鉴的是"先组装、后开发"的思路。很多人用 AI 编程工具效果不佳,问题往往不在模型本身,而在于没有为具体任务配置好 Skills、插件和预设,导致 Agent 缺少领域上下文和流程约束。
配套资源也相对齐全:课件、DSH Studio 桌面端安装包、LLM Wiki 项目源码、Agent 预设、Skills、架构图、逐轮提示词和阶段截图等,据称都已上线对应社区供领取,并提供了一键装配开发环境的脚本。
需要保持理性的是:"超过 Codex 和 Claude Code"属于创作者的主观体验,缺乏横向基准测试数据佐证;"10 轮提示"的说法也隐去了每轮提示的复杂度和中间补充内容的篇幅,实际工作量可能并不像数字看起来那么轻松。对于想复现的开发者来说,更务实的收获是这套流程拆解方式和组件化配置思路,而非工具优劣的结论。
在 Agent 编程工具的横向比较中,"轮数"并非唯一有效的评估维度。更严格的基准通常会同时考量:单轮提示的平均 token 消耗、任务完成率(而非仅完成度)、代码可运行率、人工干预次数,以及在标准化 benchmark(如 SWE-bench、HumanEval)上的得分。"10 轮提示"这一数字若不附带每轮输入的字符量和中间补充次数,很难与其他工具进行公平对比。评估 Agent 编程工具时,更值得关注的是其在"模糊需求澄清""错误自我修复"和"跨文件上下文维护"三个维度上的表现,这三点是当前各工具分化最明显的地方。
小结
这期公开课通过一个完整的 LLM Wiki 知识库项目,演示了如何用 DeepSeek Harness 进行工业级开发。核心亮点包括可溯源问答、双形态知识图谱、增量编译和在线评估等功能,以及"Skills + 插件 + Agent 预设"的组装式开发方法论。对于关注 Agent 编程和 RAG 知识库落地的开发者,这是一个值得参考的完整实战样本。
相关推荐

OpenAI Agents SDK 实战:如何实现 Human-in-the-Loop 人工审批
基于 OpenAI Agents SDK 实现 Human-in-the-Loop 人工审批机制的完整教程:从 needs_approval 暂停工具调用、捕获 interruptions 中断,到 approve/reject 决策与 RunState 状态序列化恢复,让 AI Agent 在执行高风险操作前先征得人类同意。

MaRN开源:用低维参数映射训练神经网络的PyTorch库
开源PyTorch库MaRN通过低维参数映射训练神经网络,MNIST CNN参数压缩57.7倍仍保持91.8%准确率。本文解析其基准测试、功能构成与适用场景。

NeurIPS SAC门票不可转让引讨论:政策变动惹争议
NeurIPS SAC 门票是否仍可转让引发 Reddit 机器学习社区热议。本文梳理政策变动争议、收紧背后的可能原因及对参会者的实用建议,帮助研究者正确应对顶会票务管理变化。