DeepSeek+Ollama+AnythingLLM本地RAG知识库部署全攻略

在Ubuntu本地用Ollama+AnythingLLM+DeepSeek三件套,搭建完全私有化的RAG企业知识库。
本文拆解了一套完全本地化的私有RAG知识库搭建方案,核心工具链为Ollama(模型运行环境)、AnythingLLM(知识库与向量化管理)和DeepSeek-R1(推理大模型)。RAG的价值在于为大模型挂载外部数据库,解决其知识滞后和无法读取企业私有信息的两大痛点。部署流程分三步:通过Docker安装AnythingLLM并配置国内镜像源、手动安装Ollama并拉取DeepSeek模型、打通两者之间的网络访问。实操中的真正难点集中在几个配置细节——Docker镜像源替换、将`OLLAMA_HOST`改为`0.0.0.0`以允许容器访问、UFW防火墙放行11434端口,以及CPU指令集兼容性问题。完成配置后,上传企业文档并向量化,即可让DeepSeek基于私有知识库回答专属问题。
想让大模型回答公司内部的制度、流程等私有信息?单靠通用大模型做不到。本文基于B站UP主孤暴科技Mike的实操分享,拆解如何在Ubuntu环境下用Ollama、AnythingLLM和DeepSeek三件套,搭建一套完全本地化的私有RAG知识库,让专属行业大模型落地。
为什么需要本地RAG知识库
RAG(Retrieval-Augmented Generation,检索增强生成)的核心价值在于弥补大模型的两个天然短板。
大模型的训练是离线进行的,这意味着它的知识库存在明显的滞后性,无法掌握最新信息。更关键的是,对于企业内部的非公开资料,大模型根本无从得知——当你问它某家公司的内部制度时,它只能回答不出来。这两点严重限制了大模型在商业场景中的应用。
RAG的思路是给大模型额外挂载一个数据库。当用户提问时,系统先到数据库中检索与问题相关的上下文,再把检索结果和原始问题拼接在一起交给大模型分析。这样既保证了回答的时效性,又能让模型调用私有知识,从根本上解决上述两个痛点。
向量化(Embedding)是RAG系统的技术基础,值得稍加说明。文档上传后,系统会先将文本切分成若干片段(Chunk),再通过Embedding模型将每个片段转换为高维数字向量,存入向量数据库。用户提问时,问题同样被转换成向量,系统通过计算向量之间的余弦相似度或欧氏距离,快速找出语义最接近的文档片段,再将这些片段作为上下文"喂"给大模型。这一机制使检索不依赖关键词匹配,而是基于语义理解,即便提问措辞与原文不同,也能找到相关内容。LanceDB作为向量数据库,其优势在于无需独立部署服务、直接以文件形式存储,非常适合本地化轻量部署场景。
三大核心组件的分工
整套方案由三个工具协同完成,各司其职:
- Ollama:专门运行开源大模型的运行环境,作用类似Docker容器,负责加载和调度模型;
- AnythingLLM:开源的知识库工具,负责文档管理、向量化处理和对话交互;
- DeepSeek广告:充当实际的推理大模型,本文选用的是DeepSeek-R1系列。
在数据存储层面,AnythingLLM默认使用LanceDB作为向量数据库来存储文档切分后的向量数据,向量处理则由内置的AnythingLLM Embedding完成。
第一步:通过Docker部署AnythingLLM
原作者坦言,官方提供的installer.sh脚本在Ubuntu环境下运行存在问题,且在GitHub的issue里没找到答案,因此改用Docker方式安装AnythingLLM,这也是更稳妥的选择。
安装前需先配置Docker环境:用apt-get remove清理旧包,再通过apt-get install安装证书、依赖库和GPG密钥,并添加Docker镜像源。随后执行apt update和apt upgrade更新软件包库,最后用apt-get install docker-ce docker-ce-cli containerd.io完成Docker安装。
装完后用systemctl start docker启动,再用systemctl status docker确认运行状态正常。
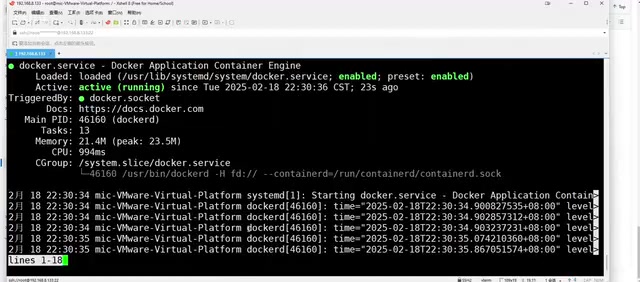
拉取AnythingLLM镜像时会遇到一个常见坑:官方仓库需要外网访问,直接pull会报错。解决办法是创建/etc/docker/daemon.json文件,写入阿里云广告、USTC等国内第三方镜像源地址。改完配置后必须执行systemctl daemon-reload重新加载,并停掉docker及docker.socket服务后再重启,否则配置不生效。
镜像约2.5G,下载需耐心等待。拉取完成后用docker images查看,再通过docker run -d -p 3001命令把镜像运行成容器并做端口映射。启动后通过服务器IP:3001即可访问AnythingLLM的Web界面。
第二步:安装Ollama并下载DeepSeek
官方的Ollama安装脚本下载速度偏慢,作者推荐的加速方案是:先从GitHub的Ollama仓库release页面下载对应环境的预编译包(Linux环境选择linux-amd64,带rocm后缀的是GPU版本,CPU环境无需选它)。

把包传到服务器自建目录(如/data/program)后,用tar -C /usr -xzf解压到/usr路径,再用chmod +x /usr/bin/ollama赋予可执行权限。此时ollama serve已可直接运行。
为方便管理,作者建议将其注册为系统服务:先用adduser创建独立的ollama用户做隔离,再创建/etc/systemd/system/ollama.service服务文件,指定执行命令和运行用户。通过systemctl daemon-reload加载、systemctl enable ollama设为开机自启、systemctl start ollama启动即可。
模型下载非常简洁,直接执行ollama run deepseek-r1,不带版本号时系统会根据硬件环境自动匹配合适的规格(通常默认7B)。参数规模越大推理能力越强,从1.5B到671B不等。本文下载的模型约4.7G,完成后即可在命令行与DeepSeek对话。

DeepSeek-R1系列模型的参数规模从1.5B到671B不等,选择时需要结合本机硬件综合权衡。参数量(B即Billion,十亿)大致决定了模型的推理能力上限,但同时也对内存和显存提出更高要求。以常见配置为参考:7B模型在CPU模式下约需16GB内存,可流畅运行;14B模型需32GB内存;70B及以上则通常需要多张高显存GPU。Ollama在不指定版本时会自动根据检测到的硬件资源选择合适规格,这对初次部署者非常友好。CPU推理速度会明显慢于GPU,但对于知识库问答这类对响应延迟要求不极端的场景,仍在可接受范围内。
第三步:打通Ollama与AnythingLLM
这是整个流程中最容易卡壳的环节。在AnythingLLM配置页面选择Ollama作为LLM提供方后,填入地址却一直loading加载不出模型。
根本原因在于Ollama默认只允许本机访问——查看OLLAMA_HOST环境变量会发现其默认值为127.0.0.1。解决办法是在ollama.service的service段添加环境变量Environment=OLLAMA_HOST=0.0.0.0:11434,允许任意节点访问。改完后同样需要daemon-reload并重启服务,可用systemctl show --property=Environment ollama.service验证配置是否生效。
即便如此,可能还是访问不了,这时需要用ufw allow 11434/tcp打开防火墙端口。全部搞定后,AnythingLLM就能成功识别并加载本地的DeepSeek模型。

值得一提的是作者遇到的一个硬坑:在某台服务器上,每次配置好地址点下一步时Docker容器就会崩溃。查阅GitHub issue后发现,这很可能与CPU芯片的指令集支持有关。作者最终换了一台服务器重新部署才顺利通过——这提醒我们,开源组件的稳定性受硬件环境影响较大,部署遇阻不必慌张。
Ollama默认监听127.0.0.1(即loopback地址)而非0.0.0.0,这是Linux网络服务的常见安全默认策略:服务只对本机可见,杜绝外部访问。当AnythingLLM运行在Docker容器内时,容器有独立的网络命名空间,即便两者在同一台物理机上,容器内的请求也不属于"本机"请求,因此会被Ollama拒绝。将OLLAMA_HOST设为0.0.0.0:11434意味着Ollama开始监听所有网络接口,容器和外部机器均可访问。UFW(Uncomplicated Firewall)是Ubuntu默认的防火墙管理工具,即便Ollama已对外监听,若UFW规则未放行11434端口,网络层面的数据包仍会被丢弃,这就是为什么两步配置缺一不可。
搭建专属知识库并验证效果
完成集成配置后,依次确认LLM用Ollama、向量处理用AnythingLLM Embedding、向量库用LanceDB,填写邮箱(可跳过),创建工作区(Workspace),整套系统就搭建完毕。
知识库的使用非常直观:进入工作区后,点击上传按钮把企业文档(如某公司的规章制度文件)传入,再点击move添加到当前工作区,执行save and embed完成文档的解析、切分与向量化存储。AnythingLLM还支持输入网址,自动抓取网页内容作为知识库的一部分。
验证效果时,提问诸如"某公司某项制度有哪些"这类私有问题,系统会先从上传的知识库中检索相关上下文,再结合问题交给DeepSeek生成完整回答——这正是RAG检索增强生成的核心工作原理。
小结
这套Ollama+AnythingLLM+DeepSeek组合为中小团队提供了一条低门槛的私有大模型落地路径:数据完全本地化、支持CPU运行、全程开源免费。实操中真正的难点不在于工具本身,而在于镜像源配置、Ollama远程访问权限、防火墙放行以及CPU兼容性这几个细节。掌握了这些关键节点,零基础用户也能搭出属于自己的行业知识库。
相关推荐

Opus 5.5实测:一个Skill把PDF变成交互式动画电子书
开发者基于 Claude Opus 5.5 打造开源 Skill「Papermorph」,通过 PDF→规划→分镜→旁白→动画测验的流水线,把静态 PDF 自动转化为带交互测验的动画网页电子书,且暂未使用图像模型。本文拆解其工作流与技术亮点。

Perplexity押注垂直整合:Vera芯片替代x86背后的Agent基建野心
Perplexity宣布垂直整合其智能体基础设施,自建沙箱并押注Vera架构替代x86,开始部署Perplexity Computer。本文解析这一战略背后的技术逻辑与行业意义。

Extra Big Ass Intelligence:一场对AI炒作的幽默反讽
Extra Big Ass Intelligence是一个在Hacker News走红的恶搞项目,用幽默反讽调侃AI行业的过度炒作与命名通胀,引发技术社区对AI营销泡沫的集体反思。