DeepSeek v4.1 Flash本地部署真相:23秒才吐一个token
DeepSeek v4.1 Flash性能领先、MIT开源,但510GB体积与本地部署的真实成本远超宣传数字。
DeepSeek v4.1 Flash在软件工程基准上以74.2分超越Claude Opus 5等商业旗舰,并采用真正的MIT许可证,令本地部署的热情高涨。然而实测揭示了被营销数字掩盖的现实:模型实际体积约510GB,MoE架构要求378个未激活专家全部常驻内存,「选择性计算不等于选择性存储」;16GB Mac Mini实测每token需23秒;权重已以FP4出厂,社区量化压缩空间几乎耗尽;能流畅运行的配置需四台DGX Spark共花约1.88万美元,速度仍只有DeepSeek API的四分之一,按实际使用量估算回本周期超过四年。本地部署仅在数据合规硬约束场景下真正成立,对多数用户而言,开源权重的最大价值在于压制了托管API的定价天花板。
MIT许可证、超越自家旗舰的性能、开源可商用——DeepSeek v4.1 Flash发布后,无数人第一时间想到的都是同一件事:终于可以彻底摆脱云端API,把这个模型跑在自己的机器上了。但当一位海外测评者真正坐下来算账、动手部署之后,兴奋很快变成了一种「幸好我及时刹车」的庆幸。
这篇文章基于该测评的完整分析,拆解这个模型「本地部署」这件事背后被营销数字掩盖的真实成本——从存储、硬件到那令人绝望的每token 23秒的生成速度。
为什么这个模型值得兴奋
先说好的一面。DeepSeek v4.1 Flash确实是一项真实的成就,而不是又一个营销噱头。
在DeepSWE v1.1这个考察真实软件工程能力的Agentic编程基准测试上,v4.1 Flash拿到了74.2分。作为参照,Claude Opus 5是74.0,GPT系列旗舰约73.0。换句话说,一个任何人都能下载、自己运行的开源权重模型,在业内最激烈竞争的基准之一上,坐上了榜首,而且领先幅度并不小。
更关键的是它采用的是真正的MIT许可证——不是「仅限研究」,也不是「除非你赚钱否则联系我们律师」的那种伪开源。这意味着可以拿来做产品、商业化服务,基本上想怎么用都行。
DeepSeek随后做的一件事更是把这个点钉死了:他们直接退役了旗舰模型v4.1 Pro——那个1.6万亿参数的巨兽,并把所有对Pro的API调用直接路由到Flash。厂商自己都在告诉你:小模型赢了。他们造出了一个击败自家旗舰、却只用一小部分算力的模型。这个故事足够精彩,也正是它让很多人(包括测评者本人)激动地想在家跑起来的原因。
「它能跑」到底意味着什么
权重放出后一天之内,人们就把v4.1 Flash跑在了各种设备上:16核Mac Mini、多节点集群、游戏主机,甚至某个满是扎带和祈祷的家用服务器。每一篇帖子都说同一句话——它能跑。
但帖子里没有放在开头、甚至要翻到评论深处才提到的,是速度。
一位开发者在16GB内存的Mac Mini上用未压缩原始权重运行,得到的生成速度是每个token需要23秒。注意,不是每秒23个token,而是每生成一个token要等23秒。第一个词在提交prompt后108秒才出现——整整一分四十八秒盯着光标。
人们确实为此欢呼,因为「技术上它成功了」:模型运行了,读了图片,答对了。但按这个速度,一段约150词的文字要花一个多小时,一封短邮件写完你午休都结束了,让它调试一个200行的脚本,你出门买菜做饭回来它可能还在跑。
测评者的反问很直接:在什么节点上,「它能跑」才不再是一句有意义的话? 技术上,你也可以靠烧美元钞票取暖,那也「能用」,只是不太优。
被误读的参数:选择性计算不等于选择性存储
这里是几乎所有报道都搞错的地方。DeepSeek官方数据显示,模型读代码时激活约80亿参数,写答案时激活约160亿。这些数字听起来很小——160亿参数的模型在一块像样的游戏GPU上跑还有富余。人们就是拿这个数字去规划硬件的。
它准确,但极具误导性。
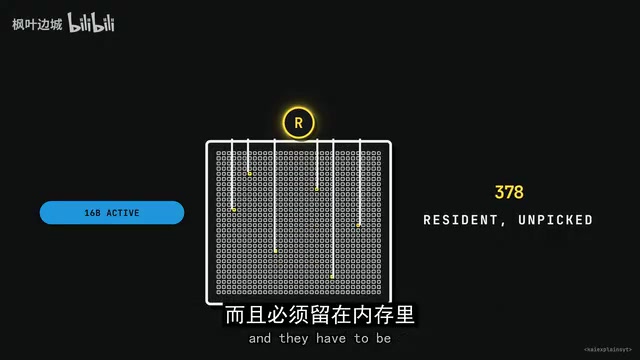
v4.1 Flash是混合专家(MoE)架构:每一层包含384个路由专家网络外加1个共享专家,路由器为每个token挑选其中6个。所以确实,任意时刻只有约160亿参数在激活。但另外378个专家仍然必须常驻内存——因为下一个token会挑选不同的6个,选择是动态的,你无法预知需要哪些,于是它们全都得留在内存里。
「选择性计算」并不意味着「选择性存储」。 这句话是理解整件事的钥匙。
此外,这一版还引入了名为Ngram的新机制:40层中有2层包含条件记忆表,1960亿参数坐在一个用最多4个token序列去匹配1600万词表的查找表里。它不是计算层,而是一个巨大的「索引卡片抽屉」,答案是从里面抽出来的。
所以从Hugging Face下载的实际体积是48个文件、约510GB。如果你按激活参数量去配置机器,那你少估了差不多494GB。而操作系统会显示约475GB——已经有人因为单位换算搞错,怎么也想不通为什么下载塞不进硬盘。
那台Mac Mini以每token 23秒的速度从SSD流式读取权重,并不是坏了,而是物理定律的必然结果:让一个又小又快的存储设备不断寻址、读取分散的约9.5GB数据去生成单个token,就是这个下场。
混合专家(Mixture of Experts,MoE)架构是理解这一切的基础。传统的密集型Transformer中,每一层的所有参数都会参与每个token的计算;而MoE将每一层的前馈网络替换为多个并行的「专家」子网络,再加一个路由器(Router)来决定每个token该交给哪几个专家处理。由于每次只激活少数几个专家,模型的总参数量可以做得很大,但单次前向传播的计算量(FLOPs)却与小得多的密集模型相当——这正是「用更少算力打败旗舰」的技术根基。
然而MoE的内存特性与密集模型截然不同。密集模型的参数量等于计算量等于内存占用,三者高度相关;MoE模型的计算量远小于参数总量,但内存占用仍然等于参数总量。路由决策是逐token动态完成的,系统在生成下一个token之前无法预知路由器会选中哪些专家,因此所有专家必须同时驻留在可寻址的内存(RAM或显存)中。这是架构层面的约束,不是工程实现的缺陷。
量化这条路已经走不通了
所有人(包括测评者)看到问题后的第一反应都是:量化压缩不就行了?
上一代v4 Flash(7月发布,2840亿参数)确实可以。社区把4-bit专家重新打包成gguf文件,一周内就有了128GB的版本,有人用四张二手RTX 3060(每张两三百美元)就跑起来了,真正做到了平民可及。
但这条路现在断了。原因是DeepSeek在你下载之前就已经量化过一次了。v4.1 Flash的专家权重直接以FP4(每参数4比特)出厂,这已经接近该格式在不损坏结构完整性前提下的压缩极限,而且从未发布过8-bit版本可供回退。往4比特以下压,专业做压缩发布的人会明确告诉你:这些模型不适合Agentic任务了。
唯一剩下的杠杆是8比特出厂的Ngram表,转成4比特能省下约100GB,于是从约475GB降到约385GB。这是真实的进步,但和128GB相差甚远——385GB对大多数人现有的机器配置来说,仍然是一个无解的内存难题。
量化(Quantization)是将模型权重从高精度浮点数(如FP16,每参数16位)压缩到低精度格式(如INT8或INT4,每参数8位或4位)的技术,目标是在可接受的性能损失下大幅缩减内存占用和带宽需求。GGUF是llama.cpp生态广泛使用的量化权重格式,社区用它把大模型打包成可在消费级硬件上运行的版本。
FP4(每参数4比特)是目前主流推理生态中实用量化的下限。低于这个精度,权重能表示的数值范围急剧收窄,模型对输入分布的微小变化变得极为敏感,尤其是需要多步推理、工具调用和自我纠错的Agentic任务——这类任务中的误差会跨步骤累积放大。DeepSeek直接以FP4出厂意味着社区失去了「从更高精度版本自行量化」的起点,这是v4.1 Flash与上一代部署生态最关键的差异之一。
一套能跑的配置要多少钱
有人真的搭出了可用配置并公开了参数,这种透明度很值得赞赏,因为它让其他人能在花冤枉钱之前先算清楚账。
这套配置需要4台NVIDIA DGX Spark,每台是搭载128GB统一内存的GB10 Grace Blackwell芯片。每台目前售价4699美元(从发布时的3999美元涨了价),四台合计18796美元——还没算税、连接它们的网络硬件和硬盘。
它们在VLLM下以Tensor Parallel 4运行,Ngram表卸载到SSD并跨机切分。这是目前能看到的第一份真实实测解码速度:代码和HTML约70 token/秒,JSON掉到45,散文和规划任务约30。
作为对比,DeepSeek自家API跑同一个模型能超过300 token/秒。
最扎心的是:上一代v4 Flash两台Spark就能装下,六周后它的接班人需要四台。硬件没变,门槛却抬高了,一套完全能用的两Spark配置在新模型发布当天就落后了一代。新模型不仅基准更强,托管也更重——这是一笔没人公开宣布的交易。
把账算清楚:四年才回本
把数字明明白白写出来,才能真正体会这个决策的分量。
非高峰时段,DeepSeek API的定价是每百万输入token 15美分、每百万输出token 60美分。取一个有意义的工作量:输入100万token、输出10万token,整个任务成本约0.21美元。
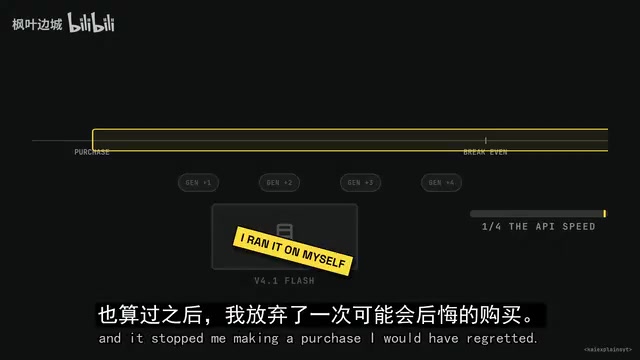
按0.21美元一个任务算,那套集群要跑约89500个任务才能回本——而这还没算一分钱电费。以70 token/秒计,10万输出token耗时24分钟,89500个任务约等于35500小时纯生成时间。哪怕24小时不间断运行,也要四年多才能回本。
四台机器长期接近千瓦功耗,四年约35000度电,按每度15美分再加约5300美元。所以实际上四年还回不了本——回本时,这个模型早已过时四五代,速度只有当年API的四分之一。
速度差距同样惊人:生成10万输出token的任务,API约5分钟完成,那套集群要24分钟。你花了1.9万美元,换来的是每个任务多等19分钟。
什么情况下本地部署才成立
公平地说,上面所有数字对某些人完全无关紧要。
如果你的数据不能离开建筑物——医疗记录、国防合同、受数据驻留法规约束的业务,或明确禁止第三方数据处理的客户协议——那么API根本就不是一个你被允许选的选项。这时的对比从来不是「本地 vs 托管」,而是「本地 vs 根本不做这件事」。把1.9万美元和一次合规违规或审计失败放在一起比,它反而是个合理的数字。
还有一个更微妙的点:正是开源权重的存在,才让API只卖0.21美元。 当任何人都能下载并自行部署模型,任何服务商的定价就有了天花板。这个天花板惠及所有人,包括那些从不下载权重的用户。开源发布,是让托管价格保持诚实的力量。
所以如果你手上已经有能装下它的机器或集群,那这个实验只花你一点电费和一个下午——这和订购四台新机器是完全不同的决策。跑起来,测你自己机器上的token价值,别信任何人的数字,因为唯一算数的是你自己机器给出的那个。
这个模型本就是为数据中心设计的
理解这一切的最后一块拼图是:DeepSeek造v4.1 Flash,针对的是数据中心的问题形态——成千上万个并发对话,KV缓存吞噬内存预算。他们把缓存优化得极其出色,现在每token只需890字节,约为上一代Flash的四分之一。对同时跑上千会话的服务来说,这是巨大的胜利。
但独自一人在房间里,你把这笔交易反着继承了:省下了你根本不会在意的那1GB,却为无法回避的510GB付了全价。
模型是真的,基准是真的,MIT许可证也是真的。而510GB、每token 23秒、以及那台18796美元的集群,同样是真的。如果你打算本地部署,请睁大眼睛:按常驻内存的量去配置机器,而不是按每token激活的量——这是两个完全不同的数字。
KV缓存(Key-Value Cache)是Transformer推理中的核心内存消耗来源。在自回归生成过程中,模型每生成一个新token都需要访问此前所有token对应的注意力键值向量;为了避免重复计算,这些向量会被缓存下来。在单用户场景下KV缓存相对有限,但在数据中心同时服务数千个并发会话时,KV缓存会迅速成为内存预算的最大消耗方,甚至超过模型权重本身。
DeepSeek将每token KV缓存压缩至890字节(约为上一代的四分之一),其核心技术是MLA(Multi-head Latent Attention,多头潜在注意力),通过低秩投影将键值向量压缩到一个紧凑的潜在空间中,大幅降低缓存占用。这一优化对高并发服务的意义是决定性的——它让同等内存硬件能支撑四倍以上的并发会话数。但对于单用户本地部署场景,并发会话数接近于1,这项优化几乎没有实际价值,用户却已经为510GB的全量权重付出了存储和内存成本。
相关推荐
LynnReal-Omni:32B统一视频扩散模型开源,四步生成多任务全覆盖
LynnReal-Omni 是基于 MiniMax H3 架构的 32B 统一视频扩散模型,支持文生视频、图生视频、姿态引导、视频修复等多任务,四步快速生成,Flash 版单张 H100 上 377ms 完成 540p 视频,权重与 ComfyUI 节点已开源。

Anthropic联合创始人:AI"紧急停止开关"或应强制立法
Anthropic联合创始人向BBC表示,AI系统的"紧急停止开关"(kill switch)可能需要通过法律强制推行。本文分析这一呼吁背后的产业逻辑、技术挑战以及监管与创新之间的张力。

AI数据中心建设热潮,正冲击工业创伤深重的城市
AI数据中心建设热潮正与曾受重工业创伤的城市社区激烈碰撞。以费城为例,全国性反对声浪聚焦能耗、水资源与环境公平问题,揭示AI增长与地方利益的结构性冲突。