DeepSeek V4.1 Flash更新:参数真相、跑分争议与成本革命
DeepSeek发布V4.1 Flash,基准全涨、成本大降,但自曝分数与口径差异待验证。
DeepSeek于10月17日发布V4.1 Flash 1017模型并开放搜索接口。官方称其为9月版本的小幅更新,但11项基准测试全部上涨,Terminal Bench 4.0提升11.1分至42.3,智能体能力显著增强。参数从552B变为763B并非扩容,而是统计口径从主干切换为全部权重。成本侧改进实在:同任务Token输出减少2.5倍,耗时减半,单任务成本不到2美分。然而核心分数均为自曝、缺乏第三方验证,且旧版9个强项基准集体缺席,智能体特化是否导致传统能力回退待观察。本地部署门槛极高,API仍是主流选择。
DeepSeek在10月17日连续放出两个动作:上午开放搜索接口,下午发布新模型V4.1 Flash 1017。官方将其定性为9月版本的“小幅更新”,但基准测试分数的涨幅和社区反应都说明,这次更新的分量远比字面描述更重。
成绩单:11项基准全线上涨,终端智能体提升显著
官方公布了11项基准测试结果,全部较9月版本有所提升,涨幅在2到11.1分之间。其中最引人注目的是三个与智能体(Agent)能力直接相关的项目:
- Terminal Bench 4.0:测试终端环境中执行真实任务的能力,从31.2分升至42.3分,提升11.1分。
- Program Bench:Meta提出的整个软件重建基准,从20.3分升至29.1分,提升8.8分。
- Deep SWE:长任务真实仓库工程测试,从74.2分升至77分,提升2.8分。
训练方法上,官方披露采用了带自我反馈的强化学习,并演示了从游戏到3D建模的完整项目流程。中文媒体将其称为“许愿式编程”。需要注意的是,这些对比的旧分均来自9月版本,属于同模型名下的自我迭代比较。
据B站UP主和Hacker News、Reddit社区的多源讨论,Hugging Face联合创始人发帖调侃“小幅更新”的说法,Hacker News相关帖子获得700多分,Reddit获900多赞,社区关注度远超官方口径。
Terminal Bench 是评估大模型在真实终端(shell)环境中执行多步骤任务能力的基准,任务包括文件操作、软件安装、脚本调试等,要求模型根据自然语言指令自主完成并验证结果。Program Bench 由 Meta 提出,要求模型从零开始重建整个软件项目,考察代码生成、架构设计与调试的综合能力。Deep SWE 则聚焦长周期、真实代码仓库的工程任务,模拟开发者日常的 issue 修复与功能迭代。这三个基准共同指向“智能体(Agent)”能力——即模型能否像人类工程师一样,在开放环境中规划、执行并自我纠错,而非仅完成单轮问答。
参数辨析:763B不是扩容,是统计口径变了
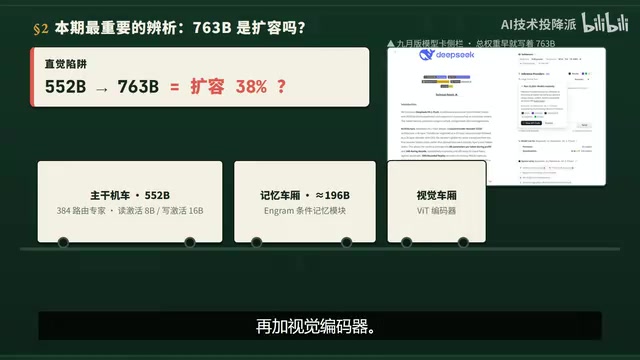
很多人看到新版本参数从5520亿变成7630亿,第一反应是模型扩容。这个理解需要纠正。
对比两版模型卡可以发现:9月版本的页面侧栏已明确标注“Model Size 763B Params”,即9月版本的总权重就是7630亿。它由三部分组成——5520亿的主干、约1960亿的记忆模块,以及视觉编码器。9月版宣传页写的是“552B Backbone Parameters”,强调的是主干参数。
所以763B不是扩容,而是这次将口径从“主干参数”切换为“全部权重”。架构本身没有变化,本质上是一个新的后训练检查点,权重继续以MIT协议开源。
模型参数统计口径 的差异常导致误解。通常“参数量”指模型中可训练权重的总数,但不同厂商在宣传时可能只强调主干网络(Backbone)的参数,而忽略记忆模块、视觉编码器等附加组件。DeepSeek广告 9月版本宣传的“552B Backbone Parameters”即仅指主干,而模型卡侧栏标注的“763B Params”才是全部权重。这种口径切换并非架构扩容,而是信息披露维度的变化。后训练检查点 指在预训练模型基础上,经过指令微调、强化学习等后训练阶段得到的版本,权重结构不变,但行为策略已更新。
冷眼看待:自曝分数、口径差异与消失的旧项目
尽管分数亮眼,但有几个问题需要冷静看待。
第一,缺乏第三方验证。 三个核心分数均为DeepSeek自曝,发布仅一天,尚无独立机构复现。
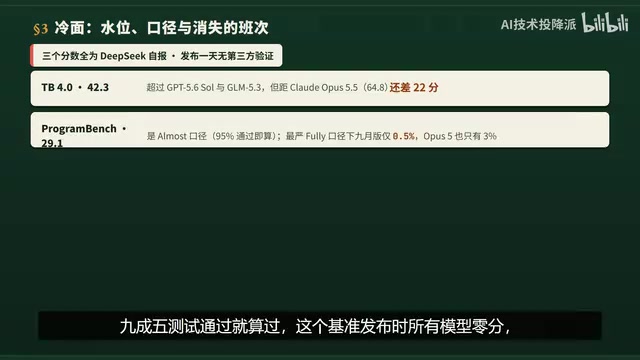
第二,口径差异影响横向对比。 Terminal Bench 4.0的42.3分超过了GPT5.6 Soul和GLM5.3,但距离Claude Opus 5.5的64.8分仍有22分差距。Program Bench的29.1分使用的是“Almost”口径——9次测试中5次通过即算通过,该基准发布时所有模型均为零分。第三方用最严格的“Fully”口径测试9月版本时,通过率仅为0.5%。Deep SWE的77分则需要在排除Meta自曝79分的MuseWonder后才算第一。
第三,旧强项集体消失。 9月成绩单上的9个项目——Codeforces、TB2.1、GPQA、Cybergym等——在本次更新中集体缺席。这是否意味着智能体特化导致了传统基准回退?官方未作说明,只能标记为待观察。
基准测试的“Almost”与“Fully”口径 是评估严格程度的差异。“Almost”口径允许模型在多次尝试中部分通过即算成功(如9次中5次通过),而“Fully”口径要求每次尝试均通过。这种差异会显著影响分数横向对比的公平性。第三方复现 是AI基准测试公信力的关键,指独立机构使用相同测试集与评测脚本验证厂商公布的分数。缺乏第三方验证时,自曝分数可能因测试环境、提示词工程或数据泄露而偏高。旧强项基准缺席 可能意味着模型能力特化导致通用能力回退,也可能是厂商选择性披露有利结果,需结合后续独立评测判断。
成本账:速度翻倍,Token消耗降低
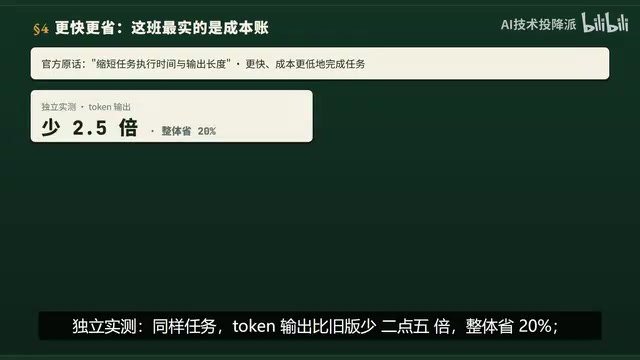
这次更新中最实在的改进在成本侧。官方原话是“缩短任务执行时间与输出长度”。独立实测显示,同样任务下Token输出比旧版减少2.5倍,整体节省20%。
具体数据:跑一个任务耗时7.4秒,花费不到2美分;旧版需要16.8秒,耗时多一倍以上,费用反而略高。推理力度调到最低档也终于变得可用。
API名称保持不变,仍为DeepSeek Flash,价格也不变:错峰时段每百万Token输入0.15元、输出0.6元,峰值时段翻倍。官方将这一改进称为“性能与成本的帕雷托改进”。
本地部署:开源不等于免费午餐
763B全量FP8权重分为48个分片,合计约510GB,仅下载就需要相当时间。社区共识是消费级硬件难以承载。量化路线可参考9月版本的经验:4比特量化相对稳定,3比特会出现死循环。64GB内存的Mac顶配跑2比特量化,推理速度也只有每秒几个Token。
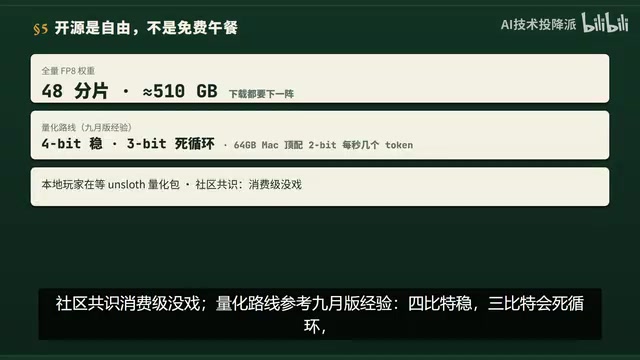
本地玩家目前正在等待Unsloth的量化包。对绝大多数用户而言,使用API仍然是更务实的选择。
FP8 量化 是一种将模型权重从高精度(如FP16/BF16)压缩到8位浮点数的技术,可大幅减少显存占用与传输带宽,但可能带来轻微精度损失。4比特/3比特量化 进一步压缩权重,4比特通常能在消费级硬件上保持可用性,而3比特可能导致推理退化(如死循环、重复输出)。分片下载 指将大模型权重切分为多个文件(如48个分片),便于分布式下载与加载,但总大小仍决定存储与内存门槛。763B全量FP8权重约510GB,远超消费级显卡显存,因此本地部署需依赖量化压缩或云端API。
节奏成为武器:搜索接口与模型更新的组合拳
同一天上午,DeepSeek还开放了搜索接口:5元1000次调用,11月1日前免费。模型更快更便宜,联网搜索的成本也降了下来,Agent所需的水电煤正在一次配齐。
9月首发、10月调校,同一个名字、同一套编组、价格不变,每月换一次大脑。版本号直接写日期这个动作本身就在传递信号:更新节奏已经成为竞争武器。下一班车何时到站?从时刻表来看,不需要等太久。
相关推荐

OpenAI与Shield合作:Astra智能体如何革新IT故障修复
OpenAI与Shield合作推出Astra智能体,可自动登录电脑和遗留系统,实时修复IT故障,比传统模型快35%到40%,仅在需要人类判断时引入人工。

iPhone Duo续航实测:一天一充跑不掉,大屏是耗电元凶
iPhone Duo续航实测:重度使用一天需至少充电一次,6.5小时亮屏约剩30%电量。大屏展开频率是耗电关键,MagSafe电池背夹可救场,长期衰减同样值得关注。

Kimi K3.1 Pro开源发布:2.8万亿参数逼近Opus
Moonshot发布开源MoE模型Kimi K3.1 Pro,2.8万亿总参数、1040亿激活参数,Terminal Bench 4.0仅落后Opus 5.5不到1分,单任务成本约三分之一,API价格减半,开源权重11月4日开放。