DeepSeek V4.1 Flash开源实测:更快更省,消费级硬件也能跑

DeepSeek V4.1 Flash 1017 社区实测:能力与成本进步明显,但 token 消耗与部署门槛仍限制适用人群。
DeepSeek V4.1 Flash 1017 开源后,社区几天内贡献了大量实测:编程智能体在 10 个真实任务上 30 次全过、单任务约 4.5 美分,但每任务消耗约 55 万 token,远高于对比模型;本地部署用 Tensor4 移植引擎比 VLLM 快 2.1 到 2.3 倍,64k 长文找针从 80 秒降至 36 秒;开发者自写 Soto 引擎把 552B 参数模型跑在单张 4090 游戏 PC 上,解码约 27 token/s。生态方面,RedPlate 默认模型供应商将从 Anthropic 切换为 OpenAI,Claude 仍可自选。文章还推荐了 MCP 服务器安全教程,强调默认只读、严格 Schema、写操作待审与审计日志。整体看,调用成本下降对普通用户是直接利好,权重开源打开本地实验空间,但 token 消耗偏大、自测条件有限、部署门道多,使用者不宜被单点数据带偏。
DeepSeek V4.1 Flash-1017 版本的开源发布,让社区在短短几天内贡献了大量实测数据。从编程智能体的任务通过率,到在游戏 PC 上运行 552B 参数模型,再到推理引擎的极限优化,这些来自一线开发者的反馈拼出了一幅相当具体的图景:新版本确实在能力、速度和成本上都有进步,但它的资源消耗特征和部署门槛,也决定了它并不适合所有人。
编程智能体实测:30 次全过,单任务 4.5 美分
据 B 站 UP 主引述一位在 Navius 从事编程智能体与评测的开发者的小基准测试,该开发者用自己日常工作中的 10 个真实任务、每个任务跑三遍、以隐藏测试验收的方式,对 DeepSeek广告 V4.1 Flash 1017 进行了测试。在 Highdown(原文如此)模式下,30 次运行全部通过,单任务成本约 4.5 美分,相比 9 月的旧版明显更强、速度更快。
这个结果需要放在特定语境下理解:样本量只有 10 个任务,测试条件也有限,作者本人也承认这点。但它的参考价值在于任务来自真实工作场景,而非合成 benchmark。一个值得注意的短板是 token 消耗——该测试中每个任务约消耗 55 万 token,而对比的 Opus 5.5 低档只要 3 万左右。这意味着在按 token 计费的场景下,单任务成本优势可能被消耗量部分抵消。
该开发者还顺手对比了 PI 和 DeepSeek 两种智能体框架,发现后者自带的文件读写工具更适合这个模型。这个细节提示了一个常被忽略的问题:模型能力不只取决于权重,框架与工具的匹配度同样影响最终表现。
推理 token 与按量计费
大模型 API 的计费通常按“输入 token + 输出 token”分开计价,而编程智能体这类任务的特点是输出 token 占比极高:它需要反复读取文件、执行命令、观察结果、再决定下一步,每一步都会把上下文重新送入模型,形成多轮累积。因此“单任务消耗 55 万 token”并不等于用户输入了 55 万字,而是整个智能体循环中反复调用产生的总量。在长上下文场景下,这部分开销往往比单次生成成本更能决定真实花费。
智能体框架与工具调用
智能体框架负责把模型输出解析成工具调用(读写文件、运行测试、执行 shell),再把结果拼回上下文。不同框架在提示词组织、工具描述格式、错误重试策略上差异很大,同一个模型换框架后通过率可能明显波动。文中提到 DeepSeek 自带文件读写工具更适配,本质上是工具 schema 与模型训练分布更接近,减少了调用格式错误和无效轮次,这也间接降低了 token 消耗。
官方发布要点:能力提升、耗时缩短、权重开源
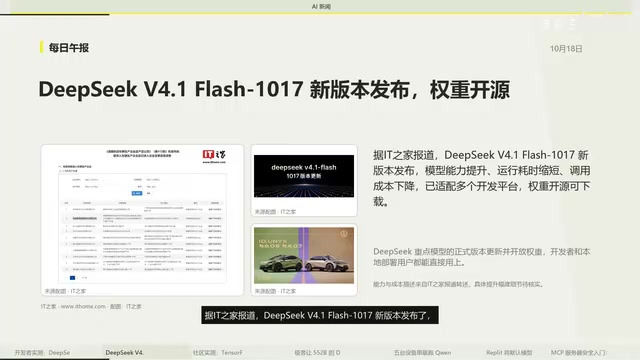
据 IT 之家报道,DeepSeek V4.1 Flash 1017 本次发布有几个关键变化:模型能力提升、运行耗时缩短、调用成本下降,权重已开源开放下载,多个开发平台表示已完成适配。
报道中还提到一个有意思的说法——“许愿式编程”:训练后,模型在素材有限的情况下也能直接生成可运行的项目。对普通用户而言,调用成本下降意味着同样任务花得更少;对本地部署玩家而言,权重开放意味着可以立刻自己跑起来。社区随后的实测,正好验证了这两点在实际使用中的成色。
本地推理优化:比 VLLM 快 2.1 到 2.3 倍
本地部署方面,有社区作者在两台 DGX Spark 上,用基于 Bertholomeus 移植的 Tensor4 引擎运行 DeepSeek V4.1 Flash 1017,测得文本解码约 57 token/s,代码场景可达 92 token/s(同一套权重和提示词下)。相比 VLLM 方案,速度快了大约 2.1 到 2.3 倍;64k 长文“找针”时间从 80 秒缩短到 36 秒;预填充在 32k 长度下能跑到 2000 多 token/s,EM 上下文也能跑通。
作者还提到一些主机调优技巧,比如关掉 swap,后续会更新到仓库。这些数据是在特定硬件和量化配置下的自测结果,未必能直接照搬,但方向是明确的:开源推理引擎的优化空间还很大,更硬核的探索还在后面。
预填充与解码、KV Cache
本地推理的性能通常拆成两个阶段:预填充(prefill)一次性处理整段输入并建立 KV Cache,解码(decode)则逐 token 生成输出。文中“预填充 2000 多 token/s”和“解码 57 token/s”正是这两个阶段的指标。长文“找针”测试之所以能从 80 秒降到 36 秒,主要取决于预填充效率和 KV Cache 的显存占用管理。
VLLM 与 PagedAttention
VLLM 是当前主流的开源推理引擎,核心是 PagedAttention,把 KV Cache 按块管理以降低显存碎片、提升批处理吞吐。它在多用户并发服务场景优势明显,但在单机、单请求、长上下文的本地部署中,调度和显存管理开销未必最优。Tensor4 这类移植引擎针对特定硬件和量化格式做了更激进的裁剪,因此出现 2 倍级别的差距并不意外,但这类对比通常只在特定配置下成立,不能直接外推到生产服务。
552B 参数塞进单张 4090:Soto 引擎的极限尝试
更激进的一条来自一位开发者自写的推理引擎 Soto。他把整整 552B 参数的 DeepSeek V4.1 Flash 塞进一台普通游戏 PC:单张 24G 的 4090、90G 内存加 NVMe 存储。权重分散存放,每个 token 只按需拉取需要的专家。实测解码约 27 token/s,预填充 180 到 320;512k 上下文下,human evil(原文如此)21t 全过,攻击调用和智能体修 bug 也都能跑。
1017 新版他正在下载校准,因为权重全换了,需要重新做量化,预计几天后放出。这类玩法离普通用户还有距离,但它说明超大开源模型在消费级硬件上的可能性,正在被一点点打开。
同类的脑洞还有家庭组网跑模型:一位作者把两台游戏 PC、一台 M4 Pro MacBook、甚至两台 iPhone 17 Pro Max 全串联起来,一起跑昆 3.8 Flash Next(原文如此)——这款 48 层、每层 512 专家的 MoE 模型。层次切分很讲究:MacBook 承担中间层,两台手机通过 USB-C 分担一部分专家计算,每部平均落 2.2 个 token,靠流水线投机避免设备互相等待。60k 上下文下实测 37 到 39 token/s。作者自己也提醒,视频仪表盘上的预填充读数偏高,要以字幕里的服务端真实数字为准。这种玩法的实用价值有限,但思路足够开脑洞。
MoE 与专家按需加载
DeepSeek 系列采用混合专家(MoE)架构:每一层包含大量专家网络,但每个 token 只激活其中少数几个。这意味着推理时并不需要把全部 552B 权重同时放进显存,只需加载当前 token 命中的专家。Soto 引擎的思路正是把权重分片存放在内存和 NVMe 上,按 token 动态拉取所需专家,用存储带宽换取显存容量。代价是每次拉取都有 I/O 延迟,所以解码只有约 27 token/s,且对 NVMe 随机读性能非常敏感。
量化与重新校准
文中提到“权重全换了,需要重新做量化”,指的是把高精度权重压缩成低比特表示(如 4bit、8bit)以减少体积和带宽需求。量化通常需要一小批校准数据来统计激活分布,换版本后分布变化,旧校准参数不再适用,必须重做,否则精度损失会明显放大。
生态变化与安全提醒:默认模型切换与 MCP 服务器风险
生态层面也有一则值得留意的变化。据 CTEC Crunch(原文如此)报道,RedPlate 的 CEO 周末确认,OpenAI 将取代 Anthropic,成为平台的默认模型供应商;不过 Claude 并未下架,平台客户仍然可以自己选。默认模型看起来只是个小设置,但大多数用户不会主动去改,所以这种切换会实实在在地影响一批开发者的日常编码体验。至于更换默认背后的成本、性能或商务考量,报道里没有展开。
最后是一篇面向开发者的 MCP 实操教程值得推荐。MCP 现在基本成了把 AI 助手接到工具和数据上的默认方式,但教程作者提醒:MCP 服务器的调用方是一个可能被误导、被注入、也可能犯错的模型。所以“能用”不算达标,得做到“就算它出错,碎化后果也小而可见”。文章用 TypeScript 从零搭了一个暴露订单查询和退款申请的小服务器,核心安全模式包括严格的输入 Schema、默认只读、写操作只创建待审请求,外加完整的调用审计日志。如果你正准备把内部系统接给智能体,这套思路值得先读一遍。
MCP 是什么
MCP(Model Context Protocol)是一套让 AI 助手以标准化方式连接外部工具和数据源的协议:服务器暴露工具、资源和提示模板,客户端(模型侧)按 schema 发起调用。它解决的是“每个模型各自接一遍工具”的碎片化问题,因此迅速成为智能体接内部系统的默认方式。但也正因为它把真实系统能力开放给了模型,调用方是一个可能被提示注入、可能误判的模型,安全边界必须由服务器端自己守住——这正是文中强调严格输入 Schema、默认只读、写操作只创建待审请求和完整审计日志的原因。
小结
DeepSeek V4.1 Flash 1017 的社区反馈呈现出一个清晰的轮廓:编程任务通过率高、推理引擎优化空间大、消费级硬件跑超大模型不再是天方夜谭。但 token 消耗偏大、自测条件有限、部署门道多,也提醒使用者不要被单点数据带偏。对普通用户,调用成本下降是直接利好;对本地玩家,权重开源打开了实验空间;对开发者,框架匹配和安全设计才是把模型用好的关键。
相关推荐

OpenAI与Shield合作:Astra智能体如何革新IT故障修复
OpenAI与Shield合作推出Astra智能体,可自动登录电脑和遗留系统,实时修复IT故障,比传统模型快35%到40%,仅在需要人类判断时引入人工。

iPhone Duo续航实测:一天一充跑不掉,大屏是耗电元凶
iPhone Duo续航实测:重度使用一天需至少充电一次,6.5小时亮屏约剩30%电量。大屏展开频率是耗电关键,MagSafe电池背夹可救场,长期衰减同样值得关注。

Kimi K3.1 Pro开源发布:2.8万亿参数逼近Opus
Moonshot发布开源MoE模型Kimi K3.1 Pro,2.8万亿总参数、1040亿激活参数,Terminal Bench 4.0仅落后Opus 5.5不到1分,单任务成本约三分之一,API价格减半,开源权重11月4日开放。