DeepSeek V4.1 Flash实测:不到1美元烧掉6500万tokens

DeepSeek V4.1 Flash凭借CED架构与Ingram机制将推理成本压缩至极低水平,编程能力逼近闭源前沿模型。
DeepSeek最新发布的V4.1 Flash通过一系列架构创新实现了惊人的性价比:实测89分钟、消耗近6500万tokens构建完整应用,总花费不到1美元。其核心突破在于因果编码器-解码器(CED)架构——输入阶段仅激活半数权重,并将KV缓存从每token近400KB大幅压缩至不足1KB,使百万token上下文窗口仅需约1GB显存。此外,Ingram条件记忆机制允许近2000亿参数从主机内存按需预取,无需常驻GPU显存。该模型采用MIT许可证可自由托管,编程基准得分与价格贵10倍的闭源模型相当,正在重塑AI推理的成本格局。
DeepSeek再次交出了一份让人意外的答卷。最新发布的V4.1 Flash不仅更快、更强,最关键的是——更便宜。在一次实测中,海外博主用它跑了89分钟、消耗近6500万tokens构建一个完整应用,总花费竟不到1美元。这背后是一整套架构层面的创新,而非简单的参数堆叠。
一次真实的极限测试
为了验证这款模型的实力,测试者使用了DeepSeek广告自家的运行框架DeepSeek Harness。这个框架最有意思的地方在于「一切皆插件」:你可以让模型直接修改自己,插件在运行时动态生效,从而改UI、改逻辑、加功能,而且真的能跑起来。
测试任务并不简单——构建一个LLM水印(watermarking)Web应用。这是一个用来判断某段文本是否由大语言模型生成的技术。测试者提交了一个相对复杂的prompt,模型运行了整整89分钟,消耗了近6500万tokens。
结果令人印象深刻:最终生成的应用UI精致、功能完整,加载了一个小型LLM,生成文本时用红色和绿色高亮标注不同词汇,水印机制运转正常。而这一切的总成本,不到1美元。这个性价比在当前的模型生态里几乎是碾压级的。
因果编码器-解码器:便宜的秘密
V4.1 Flash是一款多模态混合专家(MoE)模型,拥有5520亿骨干参数,支持最高100万tokens的上下文长度,原生处理图像与文本。但真正让它与众不同的,是它的架构设计。
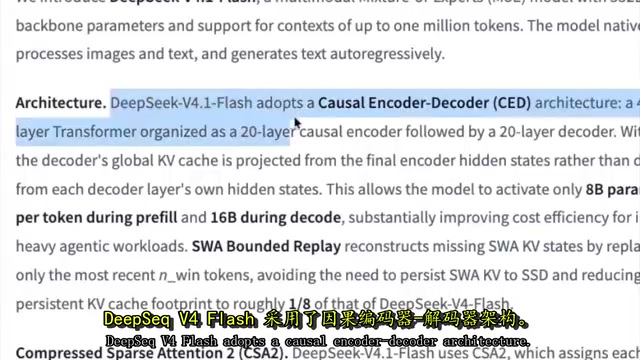
DeepSeek V4.1 Flash采用了因果编码器-解码器(Causal Encoder-Decoder,CED)架构:一个40层的transformer,前20层是因果编码器,后20层是解码器。这与经典的GPT-2式架构截然不同——在传统架构里,所有层都是解码器,每个token都要穿过全部40层。
这里的关键洞察是:输入token和输出token的数量往往极不对称。以编程场景为例,模型要读大量代码文件,却只生成很小的代码片段;研究场景同理,读海量文档,最后浓缩成一段简短回答。输入远多于输出。
CED架构正是抓住了这一点:编码器(占模型一半)只在处理输入token时运行,解码器(另一半)只在预测输出时运行。这意味着输入阶段只需激活一半的模型权重,计算量和资源需求都大幅下降。
混合专家(Mixture of Experts,MoE)架构是理解V4.1 Flash高效性的另一个基础。与稠密模型不同,MoE模型将前馈网络层替换为多个"专家"子网络,每次推理时由一个门控路由机制动态选择少数几个专家处理当前token,而非激活全部参数。这意味着模型拥有5520亿总参数,但每个token实际参与计算的只是其中一小部分——预填充阶段约80亿,解码阶段约160亿。这种"大而稀疏"的设计使模型在保留海量知识容量的同时,将单次推理的算力消耗压缩到与小模型相当的水平,是当前大规模语言模型降本提效的主流路径之一。
KV缓存瘦身:从400KB到不足1KB
CED架构的另一处巧思在于KV缓存的处理方式。
在传统架构中,每一层都有自己独立的KV缓存——每个token进入某一层后,其隐藏状态会被投影为K和V向量,供后续token做预测。而CED架构中,解码器的全局KV缓存不再来自每一层各自的隐藏状态,而是从编码器最后一层的隐藏状态投影而来。
简单说,预测第10个token时需要前9个token的KV缓存,传统架构下这份缓存分布在所有层,而CED只把它保留在编码器部分,解码器复用这份缓存,效果几乎无损。
这带来了惊人的内存节省。测试者给出的数据颇具冲击力:DeepSeek V1时代每个增量token需要近400KB的KV缓存,V3.2降到48KB,而V4.1 Flash每token的KV缓存已不足1KB(约890字节)。
这意味着什么?如果填满100万tokens的完整上下文窗口,仅需约1GB内存。作为对比,另一款近期模型每token需52KB,同样的上下文窗口要占用52GB。
对模型服务商而言,这是决定性的差异。如果一个GPU机架有1TB显存,每个用户KV缓存的大小直接决定了能同时服务多少用户——而用户数就等于tokens销量,等于收入与成本。一个看似「小」的架构调整,转化成了巨大的成本优势。此外,模型在预填充(prefill)阶段每token仅激活80亿参数,解码(decode)阶段激活160亿参数。
KV缓存(Key-Value Cache)是Transformer推理时的核心内存开销来源。在自回归生成过程中,模型每生成一个新token都需要"回顾"之前所有token的注意力信息。为避免重复计算,每个token经过每一层时产生的Key和Value向量会被缓存下来。传统架构下,一个N层模型就有N组KV缓存叠加,上下文越长、层数越多,显存占用越大,这直接制约了可同时服务的用户数量。CED架构通过让解码器统一复用编码器最后一层输出的KV表示,从根本上打破了"层数×token数"的线性增长规律,使内存开销主要由编码器层数决定而非全部层数,这正是每token缓存从数百KB骤降至不足1KB的结构性原因。
Ingram条件记忆:知识不必常驻显存
V4.1 Flash还引入了名为Ingram的机制。模型的5520亿是「骨干参数」,这意味着还有非骨干参数——即1960亿参数的Ingram条件记忆。
传统LLM如GPT-2只在模型开头有一个嵌入层,把token ID映射为嵌入向量。而Ingram在后续层也加入了额外的嵌入向量。最巧妙之处在于:推理时通过确定性寻址(deterministic addressing),这些嵌入可以从主机内存预取。也就是说,在真正需要之前就能知道要用哪些嵌入向量。
这让Ingram参数在赋予模型更多知识和能力的同时,无需常驻宝贵的GPU显存,可以offload到主机内存——又是一笔可观的资源节省。
确定性寻址(deterministic addressing)是Ingram机制能够实现预取的技术关键。在传统注意力机制中,模型需要"看完"全部上下文才能决定激活哪些知识表示,具有动态性和不确定性,因此无法提前调度。而Ingram的设计使得给定输入token序列后,所需的额外嵌入向量在计算开始前就可以被确定性地推算出来,从而允许系统在GPU执行前一批计算的同时,异步地从主机内存(RAM)或硬盘将下一批嵌入预取到设备缓冲区。这种CPU-GPU协同的异步流水线技术,让近2000亿参数的知识容量得以在不占用宝贵HBM显存的前提下按需参与推理,是将超大规模模型部署到资源受限环境的重要工程思路。
MIT许可证与价格战的信号
模型一发布就有多家服务商上线。价格方面,每百万输入token为0.15美元,每百万输出token为0.6美元,而已提交过的缓存读取输入token价格低到不足1美分。
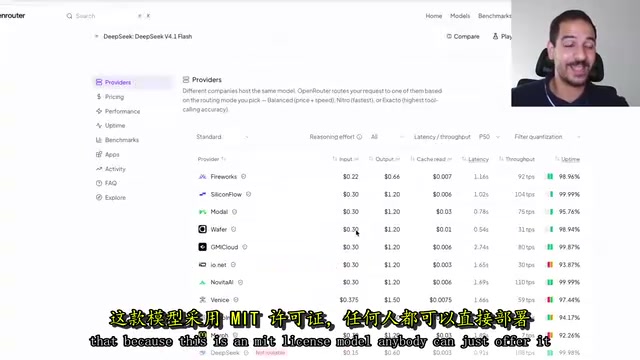
更关键的是它采用MIT许可证,任何人都能自由托管、随意使用。这与Kimi K3等模型形成对比——后者虽是开源权重,但若要大规模部署(营收或用户数超过阈值),仍需与背后的公司达成商业协议。
在编程能力上,测试者引用SWE-bench类基准数据,V4.1 Flash得分74.2,与Opus 5、GPT 5.6处于同一水平。而这些闭源模型的价格是它的10倍以上。虽然基准分数不完全等同于真实编码能力,但它是一个不错的参考。当一个便宜10倍的模型能拿到相近的分数时,为高价模型买单的理由正在变得越来越难以成立。
前沿能力正在走向可自托管
抛开这款模型本身,测试者认为这次发布最令人兴奋的信号有两点。
其一,我们正迎来一批在编程和知识工作等任务上几乎逼近前沿水平的模型,而且它们可以自托管——无论是租用GPU还是消费级硬件,都不必依赖闭源模型提供商的访问权限。
其二,这对市场竞争极为有利。当如此强大的模型出现在这个价位,其他厂商也会被迫降价。作为消费者,这意味着我们能用更少的内存、更少的算力,获得同样丰富的智能与能力。
或许在不远的将来,我们就能在一台普通Mac或PC上运行一个真正胜任编程和知识工作的强大模型,而且它就是能跑起来——这才是最让人期待的部分。
相关推荐

智谱ZCode开源引争议:代码开了,权益没开
智谱ZCode正式开源却在注释中限制权益活动,引发社区争议。本文盘点ZCode开源风波、端侧小模型崛起、Qwen-Image-2.1开放权重、有道语音识别及多平台免费额度福利。

OpenAI公开数学证明:4款开源AI数学工具本地就能跑
OpenAI公开Navier-Stokes等数学难题的Lean形式化证明并全部开源。本文梳理OpenAI证明仓库、Lean Copilot、DeepSeek-Math、OpenProver四款开源AI数学工具的定位、能力与本地运行硬件门槛,帮你按需选型。

dsh-agent-studio 开源:可视化配置 AI Agent 的提示词、工具与技能
dsh-agent-studio 是一款已开源的 AI Agent 可视化配置插件,支持自由组装提示词、工具、MCP、Skill 与后备模型,可为每个子代理单独设定模型和思考强度,帮助开发者构建干净可控的上下文和完整的 Agent 团队。