DeepSeek V4.1 Flash实测:单价降60%,总花费为何反涨36%

DeepSeek V4.1 Flash工程类任务全面领先,但推理类退步、静默路由决策与总花费反涨引发争议。
DeepSeek V4.1 Flash 采用输入80B/输出160B的不对称MoE结构,为Agent场景的token倾斜分布专门设计,缓存命中价格砍60%。官方宣称「全面超越」旗舰V4 Pro,成绩表在编程和Agent方向确实全线领先,但博士级理科问答与「人类最后的考试」两项反而落后,说明所谓「全面」有明显例外。社区实测揭示了两个反直觉现象:复杂任务因大量开启子Agent,总花费反涨36%;输出速度达335 token/秒,但任务总耗时仍超三小时。此外,DeepSeek不经通知将V4 Pro请求静默路由至Flash,引发开发者对模型名作为稳定API接口的强烈质疑,最终仅推迟了下线时间,方案未变。
全面超越?先把参数摆清楚
DeepSeek广告 在 9 月 10 号发布了 V4.1 Flash,官方给出的定调是四个字——「全面超越」,超越对象是自家旗舰 V4 Pro。但当你把官方那张成绩表逐行读完,会发现宣传口径和实测数据之间,藏着比数据本身更值得玩味的信息。
先把技术底座讲明白。V4.1 Flash 总参数 552B,是一个混合专家(MoE)模型,采用了全新的因果编码器-解码器结构,最大的特点是输入和输出不对称:读入时只激活 80 亿参数,输出时激活 160 亿参数。
这种不对称结构的逻辑很清晰。Agent 类任务的 token 结构天然极度倾斜——几万 token 的上下文和工具返回喂进去,换出来可能只有几百 token 的输出。既然大部分算力花在「听」上,那就把输入侧的激活压到最低,等到真正「发言」时再火力全开。DeepSeek 赌的就是这个token分布规律,而这个赌注在 Agent 场景里相当合理。
混合专家模型(MoE,Mixture of Experts)是一种稀疏激活的神经网络架构。与传统的稠密模型(每次推理都跑完所有参数)不同,MoE 模型将参数切分成多个「专家」子网络,每次推理只由一个路由器选出少数专家参与计算。这样做的好处是:模型的总参数量可以做得很大(提升知识容量),但单次推理的实际计算量只涉及被激活的那部分参数,从而大幅降低算力需求和推理延迟。V4.1 Flash 总参数 552B,但实际激活量只有 80B(读入)到 160B(输出),这正是 MoE 架构的典型体现。理解这个机制是读懂本文所有性能与成本数字的前提——「552B 模型」和「80B 激活」并不矛盾,前者是容量,后者是推理时的真实开销。
缓存压缩的数字陷阱
这一代缓存压缩确实很凶,但社区转述里有个常见的误读需要澄清。
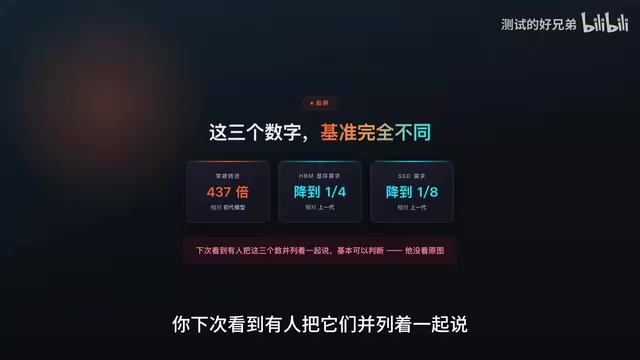
很多人说「这代缓存缩小了 437 倍」,这话本身没错,但基准被偷换了——437 倍是相对初代模型而言,不是相对上一代。相对上一代,官方的真实口径是:对高带宽显存的需求降到四分之一,对固态硬盘的需求降到八分之一。
这三个数字(437 倍、1/4、1/8)的基准完全不同。如果你看到有人把它们并列着一起说,基本可以判断这个人没有看过官方原图。
价格方面,从 9 月 10 号中午 12 点起,缓存命中的输入降到每百万 token 两分钱,未命中是一块,输出四块。缓存命中这一项直接砍了 60%。但要注意这是闲时价,高峰时段(工作日上午和下午各一段)要贵一倍,其余时间包括周末全天都算闲时。
另一个产品层面的变化:网页端和 App 端原来的「快速 / 专家 / 实时」三个模式现在全部合并,统一接入 V4.1 Flash,用户不再需要手动选择。
成绩表的两面:工程类赢,推理类输
成绩表才是这篇文章真正的重点。
在编程和 Agent 方向上,V4.1 Flash 对上代旗舰的提升是实打实的:终端操作测试 2.1 版 90.6 对 87.9、3.0 版 30 对 11.8、4.0 版 31.2 对 12.4、软件工程 74.2 对 62.7、网络安全 88.1 对 83.3、自动化任务 54.8 对 43.2。这些项目 Flash 全赢,幅度也不小。
但同一张表往下翻,有两行是相反的:博士级理科问答,Flash 90.9 输给 V4 Pro 的 92.4;「人类最后的考试」,Flash 36.8 输给 V4 Pro 的 42.7。
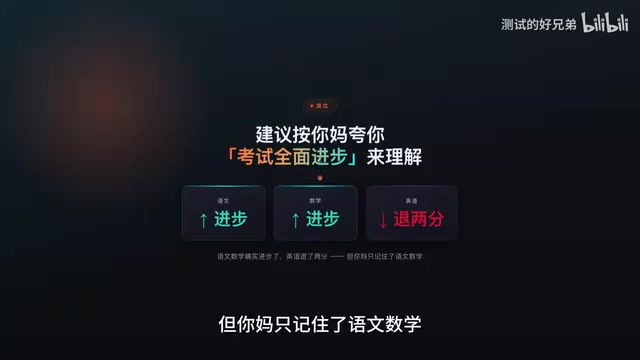
这两项恰好都是纯知识推理类任务,与编程、Agent 正好是两个方向。换句话说,Flash 的强项集中在工程类任务,弱项在知识推理。所以「全面超越」这四个字,更准确的理解应该是「工程类进步明显,推理类有所退步」——全面这个词在中文里本不该有例外。
再看对标竞品一栏,差距更清晰。终端操作 3.0 版,V4.1 Flash 30 分,对手分别是 34.4 和 43.3;4.0 版 31.2 对 39.9、51.8。最微妙的是软件工程那项,Flash 的 74.2 虽然是整张表最高分,但领先最强旗舰只有 0.2 分。真实结论是:Flash 在工程和 Agent 类任务上确实追到了第一梯队,部分项目咬得很紧,但不是拉开了,是并排了;纯推理类则还差一截。
单价降60%,总花费为何反涨36%
比分数更值得看的是一份社区实测。这份测试跑了 3 亿 token、14 组任务、2400 多次请求,而且是在 9 月 10 号降价之前完成的,这一点很关键。
结论令人意外:同一个计费口径下,V4.1 Flash 的总花费比旧版高了 36%。单价降了,总花费反而涨了。
原因在于它在复杂任务里倾向于多开子 Agent。实测中,一个大型游戏任务加一个十万字小说任务,两道题累计开了 37 个子 Agent,光子任务就烧掉超过一百万 token。这 37 个子 Agent「不领工资,但都来找你报销」。
另一份实测更说明问题:有博主测一个 3D 车库网页,输出速度达到每秒 335 token,快得飞起,但整个任务跑完花了三个多小时,约八成时间耗在「渲染—截图—交给视觉模型看—不合心意再改」的循环里。
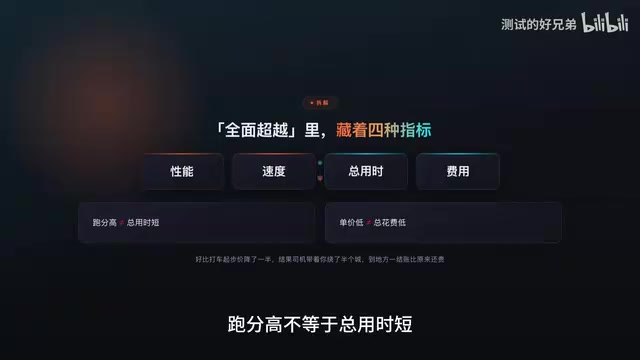
这引出一个关键认知:输出速度快不等于交付快。Agent 任务的总用时取决于它要来回折腾多少轮。就像打车起步价降了一半,但司机绕了半个城,到地方结账比原来还贵。「全面超越」里其实藏着性能、速度、总用时、费用四种指标,它们在真实场景里经常互相打架——跑分高不等于总用时短,单价低不等于总花费低。
静默路由引发的社区争议
这周争议最大的一件事与技术无关,而是产品决策。9 月 9 号,DeepSeek 宣布所有发往 V4 Pro 的请求会被静默路由到 V4.1 Flash,按 Flash 的价格计费,理由就是那句「全面超越」。
翻译成人话:老客户还按 Pro 的价格付费,但后台跑的已经悄悄换成 Flash,不通知。
消息一出,开源社区几乎一边倒反对,而且反对点高度集中——不是技术,而是「你替我做决定」。有人举了个到位的例子:你围绕 V4 Pro 调了好几个月的提示词和 Agent 流程,全是照着它的脾气调出来的,后台一声不吭换了模型,业务可能直接出问题,而且你连排查方向都没有。
还有更现实的顾虑:B 端业务按 Pro 标准收费,推理突然变快,老板以为是优化成功,等 V4.1 Pro 上线速度又调回去,这个落差谁来负责?
争议的核心是一句话:模型名到底是合同,还是实现细节?对开发者来说,模型名就是稳定接口,改了它等于单方面撕毁一份没写在纸上的协议。最终官方把下线时间从 9 月 10 号推迟到 9 月 14 号中午 12 点,但只推迟了时间,方案没变——到那天请求照样全量路由到 Flash、照样按 Flash 计费。
「静默路由」(silent routing)在云服务语境下,指服务提供商在不通知用户的情况下,将某个 API 端点的实际处理模型替换为另一个模型。与显式弃用(提前公告、给过渡期、返回明确的版本标识)相对,静默路由让调用方无法通过日志或响应头感知后端发生了变化。对 LLM API 的使用者来说,这会带来几个具体麻烦:提示词针对特定模型行为调优的结果可能悄然失效;A/B 测试的对照组出现不受控变量;计费凭证上显示的仍是旧模型名,但实际成本结构已经改变。正因如此,OpenAI、Anthropic 等主要供应商的惯例是为每个模型维护带精确版本号的端点(如 gpt-4o-2024-08-06),并在弃用时提前数月公告。DeepSeek 此次操作偏离了这一行业惯例,是争议爆发的制度背景。
分三档给的迁移建议
客观说,这波批评里有些过头了。那个「总花费高 36%」,如果你的任务本身是短平快、不触发多开子 Agent 的类型,这个数字跟你基本无关,你只会感受到单价便宜了 60%。脱离限定条件去传播,就是拿别人的场景吓唬自己。
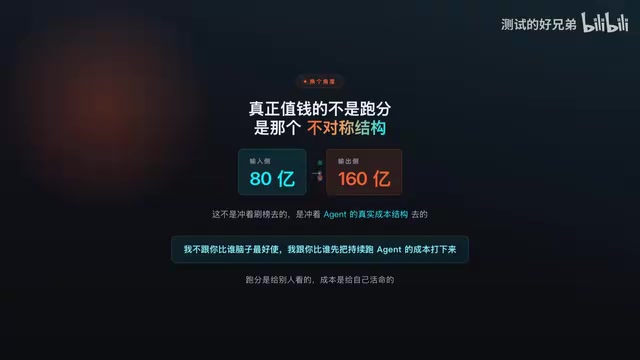
而且这次真正值钱的不是跑分,是那个不对称结构——输入侧 80 亿、输出侧 160 亿,它不是冲着刷榜去的,是冲着 Agent 的真实成本结构去的。思路很明确:不比谁脑子最好使,比谁先把持续跑 Agent 的成本打下来。
针对不同用户,可以分三档行动:
- 第一档(在用旧版 Flash 的):直接换,不用犹豫,性能涨了、单价还降了。
- 第二档(手上跑 V4 Pro 的):这两天必须做迁移测试,别拖到 14 号。重点测长上下文里的关键数字记不记得住——实测里反复出现长文档前后数字对不上的问题。
- 第三档(做长文档、要求高一致性的):先小范围试,别一把缩。这代视觉进步是真的,短视觉任务从几百秒压到十几秒,但长上下文一致性和工具控制反馈仍偏弱。
看模型发布,得同时看官方怎么说和官方自己画的表怎么画。同一份材料里,口径和数据的出入,往往比数据本身更有信息量。接下来拼的可能不再是单点跑分,而是单位成本下的持续可靠性——跑分能赢一次,账单要付一辈子。
相关推荐

Workbuddy零基础入门:桌面AI智能体如何落地工作流
Workbuddy桌面AI智能体零基础教程解读:从安装、积分领取到文件管理与自动化工作流搭建,对比CodeX的适用场景与成本差异,帮助职场人完成从AI提问者到AI管理者的思维转变。

OpenAI智能体新栈:计算机操作、决策API与超速工作流
OpenAI Dev Day发布智能体新栈:Computer Use操作速度超越普通人,Decisions API基于Luna实现极低延迟分类,Agents API开放同源计算机操作能力,GPT-6.1 Sol成本仅为Astra七分之一。本文梳理核心更新、实测数据与开发者落地要点。

梁文峰开源推理框架DeepInfo,硬刚美国禁令
DeepSeek在开源模型后再开源推理框架DeepInfo,包含GPU/CPU交叉流水线、小模型预判大模型复核、华为昇腾与英伟达芯片全面适配等技术,直面美国联邦禁令。本文解析其对AI产业落地的意义与开源策略。