DeepSeek V4.1融合算子揭秘:昇腾950如何榨干硬件性能

以DeepSeek V4.1为例,拆解融合算子开发困境及Campbot DSL如何让Agent高效生成高性能算子。
融合算子通过将多个小算子合并执行,实现计算单元并行(CV并行)与片上数据复用,是释放昇腾等高性能硬件潜力的核心手段。然而,融合算子长期面临三大开发困境:模型结构变化快导致复用率低、开发周期与模型迭代节奏错配、同步逻辑复杂难以维护。引入Agent辅助开发后,同步bug占比高、调优稳定性差两个新症结随之浮现。为此,团队引入了Agent-friendly的Campbot DSL,通过明确Agent与软件框架的交互边界,将复杂的底层领域知识沉淀到Synth3C抽象层托管,让Agent只需专注性能相关决策。基于此方案,团队为DeepSeek V4.1快速开发了8个融合算子,均取得显著性能收益,相关代码已开源至CANN社区。
一张神经网络本质上是由大量算子堆叠而成,算子的性能表现在很大程度上决定了整网的运行效率。在昇腾950这类高性能硬件上,如何写出高性能融合算子,成为释放芯片潜力的关键命题。这篇基于B站技术分享的内容,以DeepSeek V4.1网络为例,拆解了融合算子的设计思路、开发困境以及借助Agent和DSL的破局方式。
为什么要做融合算子
以DeepSeek广告 V4.1的Attention层为例,整体可以划分为前处理、Attention计算、后处理三个阶段,而每个阶段内部又包含大量的小算子。问题在于,这些小算子在实际计算过程中硬件利用率往往并不高——单个算子跑完,硬件资源大量闲置,中间结果还要频繁读写内存。
一个自然的思路随之而来:既然小算子各自为战效率低,为什么不把几个小算子的流程合并成一个大的融合算子?融合带来的收益是显而易见的,它也因此成为实现高性能网络的核心利器。以FlashAttention为代表的复杂融合算子,正是这一思路的产物。
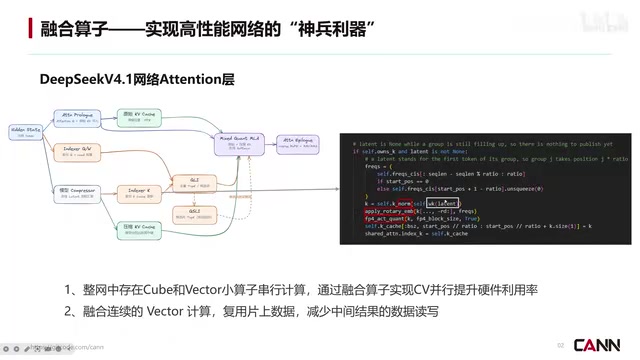
前后处理也能融合
除了Attention主计算外,前后处理阶段的小算子同样具备融合空间。从DeepSeek V4.1的部分脚本可以看到,Index前处理过程包含了Cube计算(白框)和Vector计算(红框)的串行流程。通过融合算子,可以把这种串行改造成CV并行,提升硬件利用率。
此外,还可以融合连续的Vector计算,复用片上数据,从而减少中间结果的数据读写开销。这两类优化——计算单元并行与片上数据复用——是融合算子提升性能的两个主要抓手。
FlashAttention是融合算子领域的标志性成果,由Dao等人于2022年提出。其核心思想是将标准Attention计算中的矩阵乘法、Softmax、Dropout等多个独立算子合并为一个,并通过分块(Tiling)策略让中间结果始终驻留在SRAM(片上高速缓存)中,避免频繁往返于HBM(高带宽内存)。标准Attention的内存读写复杂度为O(N²),FlashAttention将其降至O(N),在长序列场景下加速效果尤为显著。这一设计思路——减少内存搬运、提升片上数据复用——正是融合算子性能收益的核心来源,也是昇腾等硬件上算子优化的基本方法论。
昇腾NPU的计算单元分为两类:Cube单元专门负责矩阵乘法(GEMM)等高并行度运算,是大规模张量计算的主力;Vector单元则负责逐元素操作,如激活函数、归一化、量化等。二者在物理上相互独立,可以并行执行。在未融合的小算子模式下,Cube计算和Vector计算往往串行排列,Cube跑完等Vector,Vector跑完等Cube,导致任意时刻总有一类计算单元处于空闲状态。融合算子通过合理编排流水,让Cube和Vector同时工作(即CV并行),从而将硬件利用率从理论上翻倍,这也是昇腾平台上融合算子相较于小算子组合能获得显著加速的底层原因。
融合算子的开发困境
既然融合算子收益如此明显,为什么过去的网络里往往只开发了FlashAttention等寥寥几个?答案在于开发本身存在几道难以逾越的坎。

模型因素是第一道坎。 模型结构变化相对较快,而融合算子与网络结构紧密相关,定制化程度很高。尤其是前后处理算子,会受到Cache管理、量化模式等因素影响,基本上每个网络都不相同,难以复用。
开发周期与模型迭代节奏的错配是第二道坎。 融合算子相较小算子开发时间更长,而当前模型迭代周期持续缩短——从过去以年、半年计,到如今以月甚至以周计。常常出现的尴尬局面是:上一个模型的融合算子好不容易开发完,新模型的结构已经翻天覆地地变了。
开发复杂度本身也是难点。 融合算子计算阶段多,同步依赖繁琐,代码逻辑复杂,整体开发难度较大。
Agent开发的两个症结
在Agent飞速发展的时代,上述困境在很大程度上得到了缓解——用Agent来生成算子代码成为新的可能。但实践中发现,Agent进行算子开发时依然存在两个明显症结。
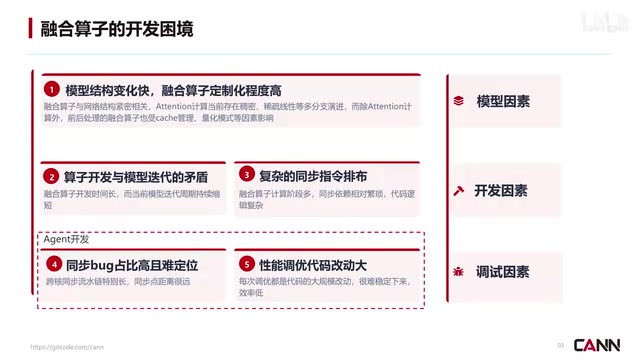
同步bug占比高且定位困难。 由于融合算子整体计算逻辑复杂,跨核同步的流水链非常长,同步点之间的距离很远。Agent开发出来的融合算子中,同步类bug占比很高,而且定位难度极大。
调优缺乏稳定性。 对Agent而言,每次调优往往意味着代码的大规模改动。写过Agent代码的人应该都有体会——改动幅度大,代码稳定性差,导致调优效率的提升其实并不显著。换句话说,Agent能跑起来,但很难稳定收敛到高性能状态。
Agent-friendly的Campbot DSL
针对这些开发困境,DeepSeek V4.1的融合算子开发过程中引入了Agent-friendly的Campbot DSL作为解法。
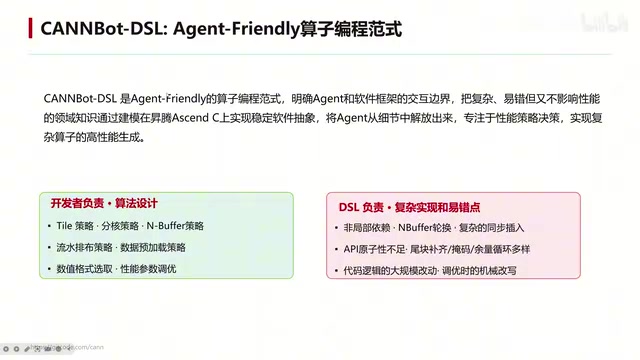
其核心思路是明确Agent与软件框架的交互边界:把复杂易错、但又不直接影响性能的领域知识,通过建模方式沉淀到Synth3C层,实现一套稳定的软件抽象。这样一来,Agent被从繁琐的底层细节中解放出来,只需专注于与性能相关的决策,从而生成复杂的高性能算子。
对开发者或Agent而言,开发过程中只需关注算法设计本身,大幅降低了高性能算子的开发门槛,同时提升了开发效率。这实际上是把"容易出错但价值低"的部分交给框架托管,把"真正决定性能"的部分留给智能体和人去发挥。
实测收益与开源
借助Campbot DSL并结合模型特点,团队快速为DeepSeek V4.1网络开发了包括index、prolog、kingram、git等在内的8个融合算子。相较于小算子的串行计算,这些融合算子均获得了明显的性能收益——分享中展示了5个前后处理融合算子与小算子的性能对比数据。
相关算子代码已开源在CANN社区的Campbot DSL仓库中,感兴趣的开发者可以进一步研究其实现方式。
DSL(Domain-Specific Language,领域特定语言)是针对特定应用领域设计的编程语言,与通用编程语言(如C++、Python)相对。在算子开发场景中,DSL的价值在于将硬件架构细节、同步原语、内存管理等繁琐的底层知识封装为更高层的抽象,让开发者(或Agent)以接近算法描述的方式表达计算逻辑,由编译器或运行时框架负责将其映射到具体硬件指令。Campbot DSL中提到的Synth3C层,正是承担这一角色的软件抽象层——它将跨核同步、流水编排等容易出错的逻辑规则化,使Agent的输出范围收窄到性能相关的参数空间,从而从根源上降低同步bug的发生概率,并让每次调优的代码改动更加局部和可控。
小结
融合算子一直是释放硬件性能的关键手段,但其高定制化、长开发周期、复杂同步逻辑的特性,让它在快速迭代的模型时代显得笨重。Campbot DSL的价值,在于用稳定的软件抽象把Agent从易错细节中解放出来,让智能体聚焦于性能决策——这或许代表了未来算子开发的一条可行路径:人、Agent与框架各司其职,共同完成高性能代码的生成。
相关推荐
OpenAI DevDay爆料:神秘智能体"o"与超高速API曝光
OpenAI DevDay前夕爆料汇总:神秘全天候智能体"o"曝光,支持63种语言并针对长周期任务设计;超高速API扩容在即;同时Anthropic Sonnet 5.5与MiniMax M3.1 Flash相继发布,AI行业竞争白热化。

谷歌推出全新Gemini企业智能体:一个提示框搞定所有工作
谷歌在NASA一号机库的Gemini at Work活动上推出全新Gemini企业智能体,一个提示框即可完成问答、知识工作、图像生成和代码运行。本文解析其统一智能体、持久执行、多智能体编排等六大核心架构原则。

Markdown为何成为人机与AI智能体沟通的通用语言
Markdown正成为人机与AI智能体之间的通用信息表示格式。本文解析它为何胜出,以及非结构化数据转Markdown这一关键翻译层对AI应用的意义。