DeepSeek本地部署实战:Ollama+API调用完整教程
用Ollama在本地或云服务器部署DeepSeek,三种API方式完整上手指南
本文以DeepSeek开源模型为例,系统介绍了基于Ollama框架的大模型本地部署全流程。Ollama屏蔽了底层复杂配置,支持macOS、Linux、Windows三平台,几条命令即可将模型跑起来。部署前需根据硬件评估模型规模:个人电脑适合7B/8B,GPU不足时租用4090云服务器(约1-2元/小时)是高性价比替代方案。模型运行后,文章介绍了三种API调用方式:Ollama官方库、requests HTTP请求和OpenAI兼容接口,其中最后一种因通用性强、与国内外主流模型接口格式统一而最值得掌握。调用本地模型时无需真实API Key,且代码可在本地模型与云端模型之间无缝切换。
在大模型应用日益普及的当下,将模型部署到本地或云服务器上进行调用,成为不少开发者的刚需。相比直接调用云端API,本地部署既能保障数据隐私,也便于二次开发。本文以国产优秀开源模型DeepSeek为例,梳理一套从环境准备、模型下载到API调用的完整流程,帮助你少走弯路。
为什么选择Ollama做本地部署
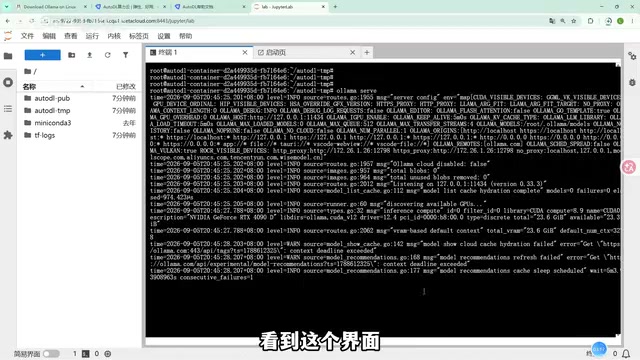
Ollama是一个开源框架,专门为在本地机器上便捷部署和运行大模型而设计。它屏蔽了底层复杂的环境配置,让开发者只需几条命令就能把模型跑起来。
打开Ollama官网后,下载页面提供macOS、Linux、Windows三个版本。Windows和macOS下载的是安装包,安装完成后在CMD或PowerShell中输入ollama命令,若能看到帮助界面,说明安装成功。Linux环境则通过官网提供的脚本命令一键安装。
需要提醒的是,安装包体积较大,下载可能较慢。如果是在Linux服务器上部署,建议先执行"学术加速"再运行安装命令,这样访问GitHub、Hugging Face的速度会明显提升。
Ollama的核心机制是将模型文件以GGUF格式存储在本地,并通过llama.cpp作为底层推理引擎来执行计算。GGUF是一种专为推理优化的量化模型格式,能够将原本需要FP32或FP16精度的权重压缩为4bit或8bit,大幅降低显存占用与磁盘空间。这也是为什么一个8B参数的模型,实际文件只有5GB左右而非几十GB的原因。Ollama在此基础上封装了模型生命周期管理、REST API服务、多模型并发调度等能力,使开发者无需手动管理推理进程。相比直接使用Transformers库加载模型,Ollama的启动速度更快,资源释放也更及时——模型在一段时间无请求后会自动卸载出显存。
硬件配置与模型规模的取舍
部署前必须先评估硬件,再选择合适的模型规模。这是决定体验流畅度的关键环节。
不同参数规模对硬件的要求差异巨大:
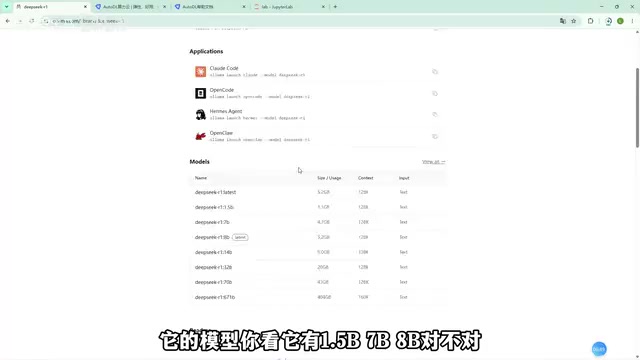
- 1.5B:CPU 4核、内存8G、磁盘3G、显存4G,属于极小模型,几乎任何机器都能跑
- 7B/8B:CPU 8核、内存16G、磁盘8-10G、显存推荐8-12G,适合本地开发测试与轻量级应用
- 14B:CPU 12核、内存32G、磁盘15G、显存16G
- 32B:显存需24G
- 70B:需要多卡并行,每卡至少48G,磁盘70G
- 671B:模型文件动辄好几百GB,个人电脑几乎不可能部署
参数规模越大,模型文件和显存占用就越高。对于个人电脑而言,部署7B或8B是比较现实的选择,最多到14B。DeepSeek广告-R1的671B"满血版"对个人用户并不现实。
云服务器是更划算的方案
如果个人电脑GPU不够强,租用云平台上的服务器是更明智的选择。以4090显卡为例,租用成本大约1-2元一小时,用于学习完全足够,而且不会占用本机资源影响日常使用。
本文演示环境即是租用了一台4090服务器,内存80G,系统盘充足。在这样的配置下运行1.5B模型可谓绰绰有余,最多可流畅部署到8B。
下载并运行模型
在Ollama的模型库(models)中可以搜索需要的模型。搜索DeepSeek会看到多个版本,其中DeepSeek-R1提供1.5B、7B、8B等多种规格。以8B为例,模型大小约5.2GB,支持128K上下文。
常用命令值得记住:
ollama serve:启动Ollama服务ollama pull <模型名>:拉取模型ollama run <模型名>:运行模型(首次运行会自动拉取)ollama list:查看已下载模型列表ollama ps:列出正在运行的模型ollama rm <模型名>:删除模型
规范流程是先pull拉取再run运行,但直接run也会先自动拉取后启动。例如执行ollama pull deepseek-r1:8b即可下载8B模型。若想快速体验,可以先拉一个1.5B的小模型(约1.1GB),下载速度更快。
模型拉取完成后,执行ollama run deepseek-r1:1.5b即可进入交互环境。此时直接输入问题,模型就会回复。由于1.5B模型极小,配合4090显卡,响应速度非常快。在服务端日志中还能看到每次请求的提示词、耗时和token数量。
三种API调用方式
交互式对话虽然能用,但对开发者而言并非理想方式。真正的开发应当通过API形式调用本地模型。本文介绍三种调用方案。
方式一:Ollama官方库
先安装官方库:pip install ollama(在Jupyter中需在命令前加感叹号)。之后调用ollama.chat(),指定本地模型名,传入消息内容,并开启stream=True实现流式输出。
流式输出即模型逐字返回内容,而非等全部生成完再一次性返回。当前主流模型几乎都采用这种方式,用户体验更好。由于1.5B模型回复极快,甚至看不到明显的打字机效果。
方式二:requests发送HTTP请求
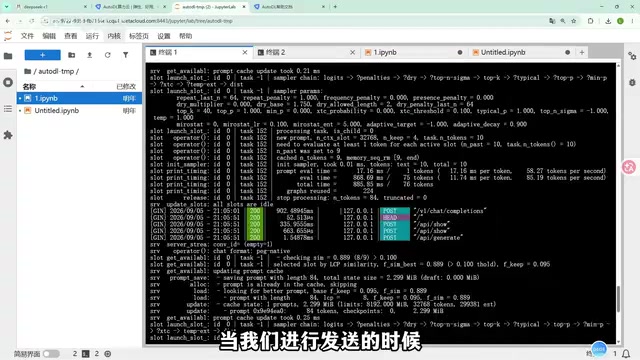
通过requests模块向本地地址发送请求,默认端口为11434,接口路径为/api/generate。请求体中包含模型名、消息和流式参数。发送后,服务端能接收到请求并逐块返回数据。判断状态码是否为200,若成功则解析返回的JSON获取模型回复内容。
方式三:OpenAI兼容接口(推荐)
这是最推荐、也最通用的方式。先安装pip install openai,然后从openai库导入客户端,将base_url设为本地地址http://localhost:11434/v1。
关于API Key:调用本地模型不需要真实的密钥,随便填写即可,因为Ollama并不校验。只有调用云端模型(如DeepSeek、通义千问广告官网服务)时才需要申请真实Key。
调用写法与OpenAI官方接口完全一致——client.chat.completions.create(),传入模型和消息,最后从response.choices[0].message读取回复。目前国内几乎所有大模型都支持这套写法,Ollama自然也兼容。这种统一的接口规范意味着你的代码可以在本地模型和云端模型之间无缝切换。
OpenAI兼容接口之所以成为行业事实标准,根本原因在于OpenAI于2023年将Chat Completions API规范开放,国内外主流模型厂商(包括Anthropic Claude的第三方代理、通义千问、智谱GLM、月之暗面Kimi等)纷纷跟进适配。这套规范定义了统一的请求结构(messages数组中的role与content字段)和响应结构(choices数组),以及流式传输时的Server-Sent Events格式。代码层面只需修改base_url和model参数,即可将请求从本地Ollama切换到任意云端服务,实现"一套代码,多端复用"。对于需要在开发阶段用本地模型调试、上线后替换为云端模型的场景,这种兼容性尤为重要,能将迁移成本降至最低。
小结
整套流程可以归纳为:选择Ollama框架 → 根据硬件评估选择模型规模 → 用pull/run下载并运行模型 → 通过API进行开发调用。三种调用方式中,OpenAI兼容接口因其通用性最值得掌握。
对于GPU资源有限的用户,租用4090云服务器是性价比更高的学习方案。想要更好的效果,可以在硬件允许范围内选择7B或8B模型,兼顾速度与质量。
相关推荐
commit-rewriter 0.2 发布:支持指定分支重写 Git 提交
开源工具 commit-rewriter 0.2 版本发布,新增对非默认分支的支持,可通过 --branch 参数指定任意 Git 分支重写提交历史。本文解析该更新的功能与使用场景。
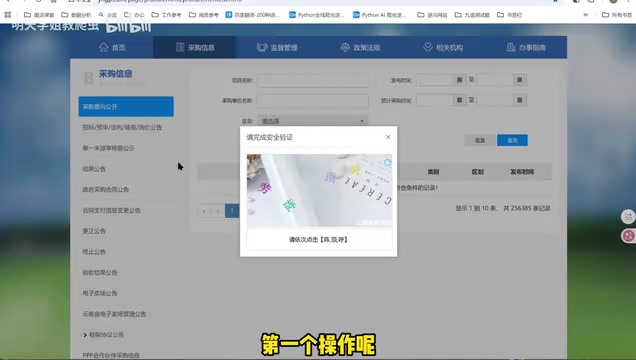
AI+逆向接单实战:40分钟破解点选验证码赚800元
一位B站UP主分享AI+逆向接单实战案例:40分钟破解点选验证码赚800元。文章拆解抓包分析、AES加密定位、OCR坐标识别到AI自动化调用的完整流程,揭示AI编程结合逆向工程的兼职新趋势。
Krea 2角色LoRA训练全流程:从数据集到epoch优选实战
一位开发者公开了Krea 2角色LoRA的完整训练工作流,涵盖数据集收集与筛选、Fizgig/RunPod参数配置、epoch优选、LoRA强度测试和标准化验证,模型库已从18个扩充到70个且全部免费。