DeepSeek补齐工具链,ChatGPT代付仍需人工确认
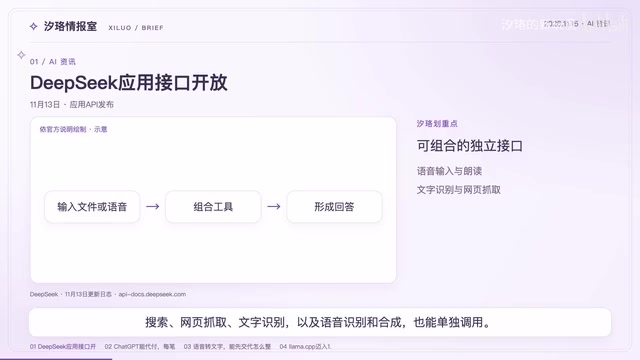
DeepSeek、OpenAI、Salesforce与llama.cpp齐更新,减步骤但划清费用权限边界。
11月12日至13日,DeepSeek、OpenAI、Salesforce和llama.cpp接连发布更新,共同方向是减少手动步骤、让AI多办事。DeepSeek开放联网搜索、文件输入、链接阅读、工具调用等应用接口,开发者可组合调用,但需自行核查权限与费用,且指定使用Flash模型。ChatGPT推出钱包功能,智能体可代为比价下单,但付款前仍需人工核对商品、总价和卡信息并通过生物识别确认,首批仅限美国Pro用户。Salesforce开放SOV Transcribe 1语音转写模型,采用Apache 2.0许可,支持七种语言但不含中文,且为非流式转写。llama.cpp发布1.0版本,承诺用主版本号标识不兼容变更,但硬件性能仍取决于量化方式与设备。
一周AI动态:智能体能力跃迁,但控制权仍在人类手中
据B站UP主“希洛”整理的11月12日至13日官方消息,DeepSeek广告、OpenAI、Salesforce及llama.cpp接连放出更新,方向高度一致:让AI少绕弯、多办事。但每一条消息背后,都把费用、权限和适用范围摆到了台前。
DeepSeek开放应用接口,补的是“接线”的活
11月13日,深度求索开放了一整套应用接口。开发者在构建聊天助手时,可以直接接入联网搜索、文件输入、链接阅读、工具调用和资料拼接,这些能力由服务端处理,省去了自己对接的麻烦。
搜索、网页抓取、文字识别以及语音识别和合成也能单独调用。比如一个文档问答工具,就可以把读文件和语音输入组合起来。但需要分清:这次是开放应用能力,不是发布新的基础模型。官方文档指定使用Flash模型,搜索、解析和语音各有工具费用。同时开源的聊天演示客户端可导入历史对话,定位是演示项目。对开发者来说,省下的是接线工作,权限、费用和回答质量仍要自己检查。
“Flash模型”是DeepSeek按推理成本与响应速度划分的模型档位之一,通常定位为轻量快速版本,适合高频、低延迟的对话和工具调用场景,而能力更强的版本则以更高费用提供。文章所说的“应用接口”指围绕模型搭建的周边能力接口,例如联网搜索、网页解析、OCR、语音识别与合成、工具调用等,这些能力由服务端封装,开发者通过API组合调用即可,无需自行维护爬虫、解析器或语音管线。所谓“接线”就是指把这些分散能力连接成完整工作流的工程工作。
“工具调用”(function calling)指模型根据用户意图输出结构化参数,由外部程序执行具体操作(如查询数据库、调用搜索、发送请求),再把结果回传给模型继续生成回答。它让模型从“只会说话”变为“能触发动作”,但权限控制、费用计费和结果可靠性必须由开发者自行设计兜底。
ChatGPT钱包:智能体跑腿,付款前你仍要点头
ChatGPT推出钱包功能,让智能体帮用户完成购买。但付款之前,你仍要核对商品、总价和选用的卡,再通过人脸或指纹验证确认,随后才支付。网络提供替代真实卡信息的支付凭证——按官方介绍,智能体和商家拿不到你的实际卡资料。
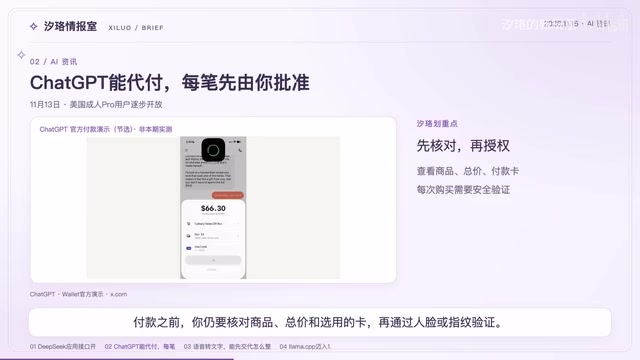
首批仅面向美国18岁以上的Pro用户,且需要符合条件的美国发行卡。这一步把比价和下单连起来了,但不代表所有网站都已支持授权支付,也不等于订单已经成功。结账后还要看商家的确认。可以理解为让助手多跑一步,最后花多少钱、买什么,仍要由人把关。
“支付凭证”(payment credential/token)是支付网络为单次交易生成的替代性卡信息,通常与真实卡号绑定但一次性或限定商户使用,商家和智能体只能看到这串凭证而非用户的真实卡资料。这种机制源于网络令牌化(network tokenization)技术,目的是降低卡号泄露风险,并使交易可被追踪和撤销。
“生物识别确认”指通过设备的人脸或指纹验证来授权支付,相当于把最终决定权保留在用户本人身上。即便智能体完成了比价、加购和填写信息,支付仍需用户主动确认,这既符合监管对强客户认证的要求,也避免了模型误判导致的资金损失。需要注意的是,授权支付能否成功还取决于商户网站是否接入相应支付协议,订单最终是否成立仍以商家确认为准。
Salesforce语音转写:开放权重,但中文缺席
Salesforce开放了新的语音转写模型SOV Transcribe 1,重点是把录音变成更符合需要的文字。你可以要求逐字保留,也可以整理掉口头停顿、调整标点和数字格式,还可以提前给它人名或专业词,帮助识别容易听错的内容。
模型采用Apache 2.0许可,团队可以放在自己的基础设施上运行。不过它做的是非流式转写,不是边说边出字的实时对话模型。模型卡列出英语等七种语言,没有把中文列在支持名单里。所以更适合先拿真实业务录音验证,别把开放权重理解成开箱就能替代所有听写工具。
“开放权重”(open weights)指模型训练后的参数被公开发布,团队可以下载并在自有基础设施上运行、微调,但未必公开训练数据和完整训练代码。它与“开源”不完全等同:前者侧重可用性,后者还涉及可复现性和许可自由度。Apache 2.0是宽松型开源许可,允许商用、修改和再分发,但需保留版权声明与许可文本。
“非流式转写”指系统先接收完整音频再一次性输出文字,而非边说边出字。非流式通常能利用整段上下文做更好的纠错和标点还原,准确率往往高于流式,但延迟更高,不适合实时字幕或语音对话。模型卡列出的支持语言决定了实际可用范围,未列入中文意味着中文识别效果没有官方保证,需用真实业务录音做验证后再决定是否采用。
llama.cpp 1.0:接口稳定性的里程碑
本地AI工具llama.cpp发布了1.0版本,它负责让模型在本机等不同硬件上运行。这次重点之一是接口的稳定性:今后出现不兼容的接口变化,会通过主版本号明确告诉开发者。对基于它做软件的人来说,升级前更容易判断需不需要修改代码。
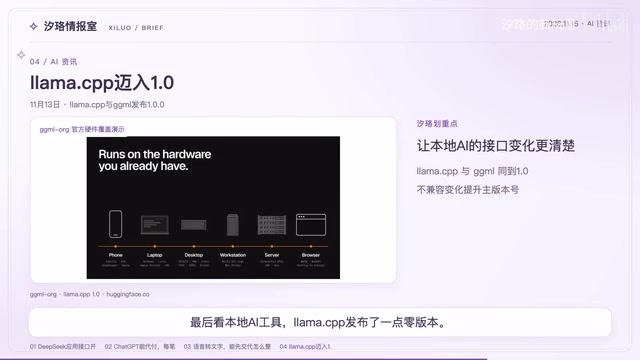
这一版也更新了网页界面,加入聊天分组和文本编辑等功能。但1.0不等于所有模型都能在你的电脑上流畅运行,速度和内存需求仍然取决于模型量化方式以及实际硬件。如果你使用的是依赖它的其他软件,还要等那个软件完成适配。
“模型量化”指把模型权重从高精度浮点数压缩为更低位数(如4位、8位整数),以显著降低内存占用和计算量,代价是可能损失少量精度。量化方式(如GGUF格式下的不同量化等级)直接决定模型能否在消费级显卡或CPU上运行,以及生成速度。
语义化版本号(SemVer)约定主版本号变更代表不兼容的接口改动,次版本号代表向后兼容的新功能,修订号代表修复。llama.cpp承诺用主版本号标识破坏性变更,意味着依赖它的上层软件在升级前可通过版本号判断是否需要改代码。但1.0仅代表接口趋于稳定,不代表性能保证:实际速度与内存需求仍取决于量化等级、模型规模和硬件配置,使用其作为依赖的软件也需完成自身适配后才能受益。
小结:减少手动步骤,但代价与边界同样清晰
四条消息都在减少手动步骤,同时也把费用、权限和适用范围摆到台前。DeepSeek省的是对接成本,ChatGPT代付留的是人工确认,Salesforce开放权重却未覆盖中文,llama.cpp稳定接口但硬件门槛依旧。你更希望AI先帮你整理文件,还是帮你完成一次购物?
相关推荐
哈佛AI安全课程CS 2881R引热议
哈佛大学CS 2881R AI Safety课程在Hacker News被提及,本文介绍课程背景、AI安全的核心议题及对学习者的启示,帮助理解顶尖高校如何培养AI安全人才。

拓展社交圈:值得尝试的几款交友应用
交友应用怎么选?本文梳理朋友发现平台BFF与活动导向应用Timeleft等不同定位的友谊类应用,分析两类思路的适用人群,并给出线下见面安全与预期管理的实用建议。
为什么不该在个人电脑上运行Hermes智能体
为什么不应该在个人电脑上运行Hermes等自主AI智能体?本文从安全风险、资源占用、凭证泄露和自主性需求四个角度,分析为何应将智能体部署到独立VPS而非主力设备,并给出隔离部署的实践逻辑。