DeepSeek开源DeepInfer:推理降本与国产芯片变局
DeepSeek开源推理框架DeepInfer,展示低成本如何由模型结构而非硬件堆叠决定。
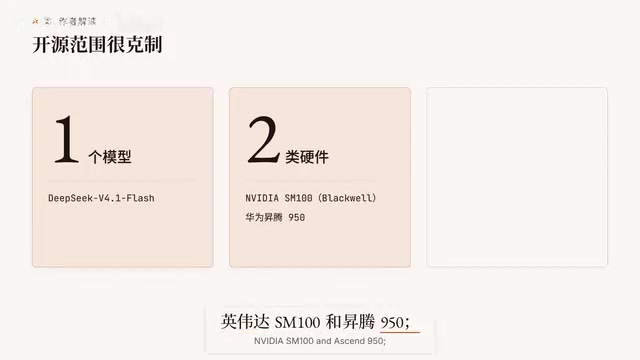
DeepSeek开源了内部推理框架DeepInfer,范围克制:仅覆盖DeepSeek V4.1 Flash、英伟达SM100与昇腾950的离线推理,不含KV Cache存储、PD分离和在线服务。文章的核心判断是,DeepSeek的低成本是结构性的——YOCO跨层共享KV让Pre-fill计算省掉近一半,PD分离让Pre-fill和Decode互不拖累,这些收益在训练时就必须设计进去。昇腾在框架中成为与英伟达并列的一等公民,TileLang算子一一对应,DeepSeek加昇腾可能成为国内大规模推理的默认组合,而其他国产芯片的适配门槛被抬高。硬件期望也写进了引擎:FP4专家权重、FP8激活与KV、UE8M0缩放因子,瓶颈从算力转向互联。
DeepSeek把内部推理框架DeepInfer开源了。这不是一个普通的工程开源动作——它把训练时的结构选择与推理时的成本结构直接绑在一起,让「低成本」从运营技巧变成了模型架构的内生属性。
开源了什么:克制的范围与明确的边界
官方给出的理由很直接:训练让模型学有所成,推理才让模型被人用上,推理效率直接决定算力成本和电力消耗。这次开源包含两样东西:DeepInfer推理框架(兼容英伟达与昇腾)和DeepSeek广告 Recipe(编解码组件,与官方API对齐)。
但开源范围相当克制:只覆盖一个模型(DeepSeek V4.1 Flash)、两类硬件(英伟达SM100与昇腾950),而且只有离线推理。KV Cache存储、PD分离、负载均衡和在线服务都不在其中。它更像生产系统里的单个引擎,不是拿来就能上线的服务框架。
这种克制恰恰值得细读。DeepInfer最早基于vLLM,但现在vLLM的痕迹已经很少,调度器、输入准备和采样输入构造都改成了C++。换言之,这不是给社区递一个「能跑起来」的demo,而是把生产环境里经过验证的核心引擎抽出来,让你看到边界在哪里。
低成本是结构性的,不是堆硬件堆出来的
原文问答部分给了一组线上数字:单集群每天约155万亿Token,折算每卡每小时收入约38美元。Decode用EP64到EP128,Pre-fill只用EP2到EP8,KV Cache存在3FS上,采用10加2纠删码,保留3到7天。
这组数字背后是一个关键判断:Pre-fill吃算力,Decode吃显存带宽,分开部署两边就不会互相拖累。而最省钱的部分都和模型结构绑定——跨层共享KV,后半部分层借用中间层的KV(即YOCO,出自微软2024年的论文),前半层生成一份全局KV,后半层直接复用,Pre-fill还能提前结束。训练时就得这样设计,推理时才能省。
读完代码最大的感受是:DeepSeek的低成本是结构性的。KV压得这么小,Pre-fill计算省掉近一半,靠的是软硬件协同设计(Codesign),只靠堆硬件或者调kernel做不到这种程度。全局KV缓存、PD分离、跨级群负载均衡和故障处理这次都没放出来,但对云厂商仍是重大利好——第一天就有参照和现成实现。结果是在开源模型够用的任务上,服务价格的下限会继续往下走。
YOCO(You Only Cache Once) 是微软研究院2024年提出的一种解码器架构设计。标准Transformer的每一层都需要维护自己的KV Cache,显存占用随层数线性增长;YOCO则让模型的前半部分层正常计算并生成一份全局KV缓存,后半部分层直接复用这份缓存,不再各自存储。这样KV Cache的总量大幅压缩,长上下文场景下的显存压力显著降低。更关键的是,由于后半层不再需要重新计算KV,Pre-fill阶段可以提前结束,计算量省掉近一半。但这种收益无法在推理阶段临时获得——模型在训练时就必须按YOCO结构设计,否则推理时无缓存可复用。这正是文中“结构决定成本”判断的技术根基。
国产芯片:昇腾成为一等公民,其他厂商门槛抬高
硬件抽象只有两条路径:英伟达的CUDA和NCCL,昇腾的CANN和HCCL。DeepInfer里昇腾和英伟达一样是一等公民——TileLang算子两边各30个一一对应,还有DeepGEMM和DeepEP的昇腾版。
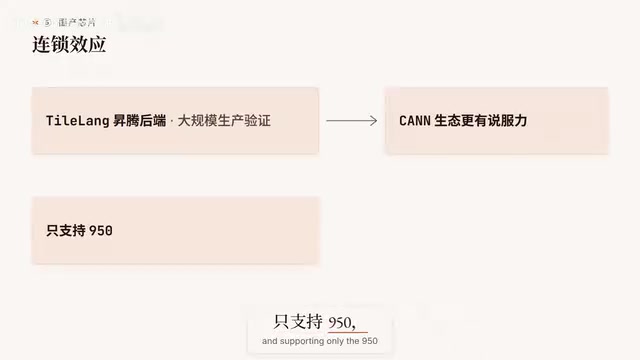
以前国产芯片靠厂商自己维护vLLM或SGLang分支,一直跟在后面。现在同一个引擎、同一套算法,差距只剩硬件和底层算子。连锁效应有两个:一是TileLang昇腾后端经过大规模生产验证,CANN生态更有说服力;二是只支持950也帮华为推动客户换代。DeepSeek加昇腾很可能成为国内大规模推理部署的默认组合之一。
其他厂商就没这么好过了。寒武纪、海光、昆仑芯、摩尔线程、沐曦、壁仞、燧原、天数智芯想要完整适配,大致要推翻原有引擎,要补的不少:TileLang后端合约30个算子、FP8×FP4的GEMM融合、分发计算合并的Mega MoE、稀疏注意力和TopK,再加上设备端主动通信的专家并行库、Ngram的跨卡查表和平台层适配。TileLang后端越成熟,移植成本越低。
TileLang 是一种面向张量计算的领域特定语言(DSL),目标是让算子开发者在不同硬件后端上写一份代码、编译出各自的原生实现。它介于CUDA/HIP等底层编程模型与PyTorch等高层框架之间,通过编译器把统一的张量程序 lowering 到目标硬件的指令序列。对DeepInfer而言,TileLang是硬件抽象的关键一层:英伟达和昇腾各维护30个一一对应的算子,同一套算法逻辑就能跑在两种芯片上。TileLang后端的成熟度直接决定了新硬件平台的移植成本——后端越完善,芯片厂商需要补的算子越少,适配周期越短。这也解释了为什么适配的主战场正从手写kernel转向DSL和编译器。
对硬件的三个新期望
这套引擎也写进了对硬件的期望。第一是低精度格式:专家权重用FP4,激活和KV用FP8,缩放因子用UE8M0。去年V3.1时DeepSeek就说过UE8M0 FP8是为下一代国产芯片设计的,这次全面落地,不支持的芯片要么丢精度要么丢性能。E8M0只有8位指数没有尾数,缩放因子都是2的整数次幂,硬件实现很便宜。
第二是显存压力降了:每Token的KV小到1KB以下,长上下文对HBM的需求大降,HBM偏小的国产芯片直接受益。
第三是瓶颈转移:EP64以上的专家并行和Mega MoE要求大规模高速互联和设备端通信,瓶颈转到了互联,主机带宽更重要。Ngram表放在主机内存,前向时按哈希远程拉取,NPU路径还专门调用昇腾接口锁页。
UE8M0 是一种极简的缩放因子数值格式:8位全部用于指数,没有尾数位,也没有符号位。这意味着它只能表示2的整数次幂(如2^-3、2^5),无法表示任意小数。在FP8/FP4混合精度计算中,缩放因子用于把不同量级的数值归一化到低精度格式的可表示范围内;用UE8M0表示缩放因子,硬件只需做移位操作,不需要复杂的乘法器,实现成本极低。代价是缩放粒度必须足够细,才能用2的幂次逼近真实的动态范围。DeepSeek在V3.1时期就提出UE8M0 FP8是为下一代国产芯片设计,这次在DeepInfer中全面落地,意味着不支持该格式的芯片在精度或性能上会直接吃亏。
Mega MoE 指的是把MoE(混合专家)模型中原本分离的“分发—计算—合并”三个步骤融合进一个大的融合算子中执行。标准MoE推理需要先把Token按路由结果分发到各专家所在的设备,各专家计算后再把结果合并回来,这中间涉及多次核函数启动和跨设备通信。Mega MoE将这些步骤合并,减少启动开销和中间结果的显存往返,同时让通信与计算更好地重叠。在EP64以上的大规模专家并行下,这种融合对互联带宽和设备端主动通信提出了更高要求,也是文中判断“瓶颈从算力转向互联”的直接依据。
启示:适配主战场正在转移
对大模型公司来说,推理成本越来越取决于训练时的结构选择:KV大小、Pre-fill计算量、投机解码接受率都是设计目标。对芯片厂商来说,联合优化已是必选项,Day-0支持直接影响客户选择。适配的主战场正转向TileLang这类DSL和低精度格式。
对普通开发者,DeepInfer不会取代vLLM和SGLang——它不做前缀缓存和在线服务——但它是个好参照:哪些状态必须存、哪些可以重新计算,通用框架会怎么吸收这些设计,值得持续关注。
相关推荐
AWS官方Agent Toolkit发布:让AI代理直接构建管理AWS应用
AWS发布官方Agent Toolkit,以可安装插件形式让AI编码代理直接构建和管理AWS应用,覆盖CDK、CloudFormation、Serverless、Bedrock Agents及DevSecOps等场景,并附安装注意事项。
用非周期序研究打造AI推理阶梯:可验证奖励问题的开放数据集
研究者发布非周期序AI谜题数据集,包含已解梯级用于RL训练、开放梯级对接真实数学研究,探索可验证奖励强化学习的课程与评估新思路。
AI智能体需要自己的"第二基地"吗?三环架构解析
受阿西莫夫《基地》系列启发,一个多智能体AI架构假设提出执行、验证、适应三层控制回路,通过独立评估、守门验收和GEPA优化减少相关错误,提升AI结果可信度。