#推理框架
共 12 篇相关文章
DeepInfer开源:DeepSig生产级推理引擎深度解析
DeepSig开源生产级推理引擎DeepInfer,基于vLLM构建,兼容NVIDIA SM10与昇腾950 NPU,单集群日处理155万亿Token、缓存命中率96%。本文解析其自研内核、调度机制与离线引擎的局限。
DeepSeek开源DeepInfer:推理框架开放如何搅动AI生态
DeepSeek开源推理框架DeepInfer,将模型、代码、推理栈逐一开放。本文分析这一动作对开发者生态、闭源厂商竞争格局的影响,以及开源AI从权重走向全栈的趋势。
DeepSeek开源推理框架DeepInfer:推理服务赚钱逻辑与行业影响
DeepSeek开源自用推理框架DeepInfer,首次公开推理服务成本收益模型:128卡集群年收益超4000万美元。本文解析KV Cache、Prefill/Decode分离等技术优化,分析开源对云厂商、第三方API服务商的影响,以及DeepSeek构建生态的真实意图。
DeepSeek开源推理框架领衔,本周五大科技亮点
本周科技周报:DeepSeek开源生产推理框架DeepInfo,DuckDB 2.0迈向服务端,Rust版TypeScript编译器TSRS性能提升8倍,Mac直接运行安卓应用,开源排版软件DesignCraft与电视桌面Ariel亮相。

梁文峰开源推理框架DeepInfo,硬刚美国禁令
DeepSeek在开源模型后再开源推理框架DeepInfo,包含GPU/CPU交叉流水线、小模型预判大模型复核、华为昇腾与英伟达芯片全面适配等技术,直面美国联邦禁令。本文解析其对AI产业落地的意义与开源策略。

DeepSeek开源推理框架DeepInfer,海外网友:这才是真正的OpenAI
DeepSeek在发布V4.1 Flash三天后开源推理框架DeepInfer,主打降低推理算力成本与能耗。海外开发者社区反应热烈,有网友称其为真正的OpenAI。本文梳理开源推理栈相比模型权重的实际价值及社区分歧。

DeepSeek开源DeepInfer:推理框架如何让AI服务更便宜
DeepSeek开源推理框架DeepInfer,公开日处理155万亿token的集群账本。本文用饭馆类比讲清prefill与decode分离、KV缓存命中率96%、DeepSpark投机解码和专家负载均衡,分析推理框架如何降低AI服务成本,以及普通开发者能否直接用。
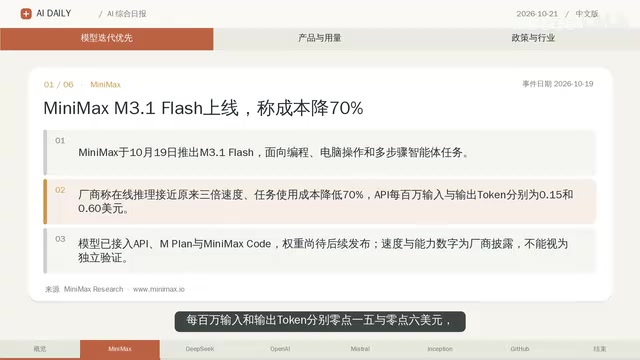
DeepSeek开源推理框架,MiniMax M3.1 Flash成本降70%|AI日报
DeepSeek开源推理框架DeepInfer,MiniMax M3.1 Flash称推理提速近三倍、成本降70%,OpenAI公布低资源编程语言评测,VoxChannel与Mercury发布新工具,GitHub Copilot停用6款旧模型。本期AI日报逐条解读六条消息的成本、边界与实际可用性。

DeepSeek开源DeepInfer推理框架:服务V4.1-Flash
DeepSeek 开源 Apache 2.0 推理框架 DeepInfer,服务 DeepSeek-V4.1-Flash 生产环境,支持 NVIDIA SM100 GPU 与华为昇腾 950 NPU,当前仅提供离线推理能力。

DeepSeek开源DeepInfer:高性能大模型推理框架
DeepSeek开源DeepInfer推理框架,定位高性能与大规模部署。本文分析其对私有化推理、社区引擎如gufo/halogen的影响,以及开源推理生态的竞争格局。
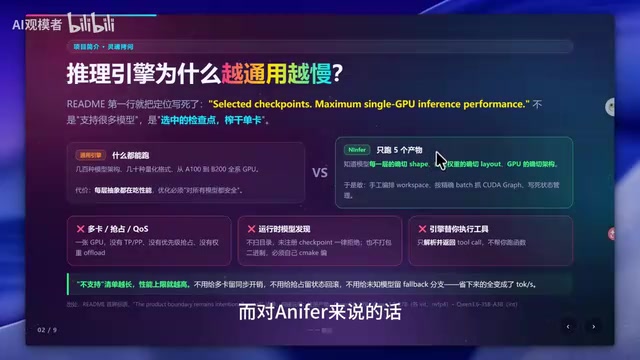
Anifer开源推理引擎实测:单卡5090狂飙150 token/s
开源推理引擎 Anifer 用 C++/CUDA 深度优化,单张 RTX 5090 上 Qwen3.8 27B 单并发实测稳定 144~150 token/s,8 并发官方跑分冲到 1147 token/s。本文解析它为何比 vLLM、llama.cpp 更快及实测数据。
 科技前沿
SGLang举办Agent Loops主题Office Hour,聚焦智能体循环架构优化
SGLang团队举办Agent Loops主题Office Hour,深入探讨智能体循环调用的推理优化方案,涵盖KV Cache复用、低延迟多轮对话及工具调用等关键技术,助力AI Agent开发者提升推理性能。