DeepSeek开源DeepInfer:推理框架到底有什么用?
DeepSeek开源推理框架DeepInfer,优化调度与计算加速模型推理。
DeepSeek开源了推理框架DeepInfer,采用Apache 2.0许可证。该框架负责将模型部署到计算设备并调度计算,通过组批调度、调度与计算重叠、FlashMLA/DeepGEMM专用程序优化以及多芯片协作来提升推理效率。其DSPark功能采用草稿模型先猜、主模型验证的投机方式加速逐步生成,但验证不保证事实正确。公开版本支持DeepSeek V4.1 Flash离线推理和格式约束输出,硬件支持英伟达SM100架构GPU与华为昇腾950,但完整在线服务配套系统未全部开源。对普通用户而言,推理效率提升可能改善响应速度和并发体验,但实际效果取决于模型、设备和请求量。
DeepSeek开源了推理框架DeepInfer,代码已上传至GitHub并采用Apache 2.0许可证。对于大多数只通过聊天界面使用DeepSeek的用户来说,这个名字可能有些陌生——它不生成回答,也不出现在对话框里。但每一次提问获得回答的速度、服务在高并发下的稳定性,都与这类推理框架的工作直接相关。
DeepInfer是什么:模型与硬件之间的调度层
DeepSeek广告模型负责根据输入生成回答,而DeepInfer负责把模型放到计算设备上运行,并安排这些计算如何进行。这个用训练好的模型处理输入、生成结果的过程叫做推理,DeepInfer就是一套专用于推理的框架。
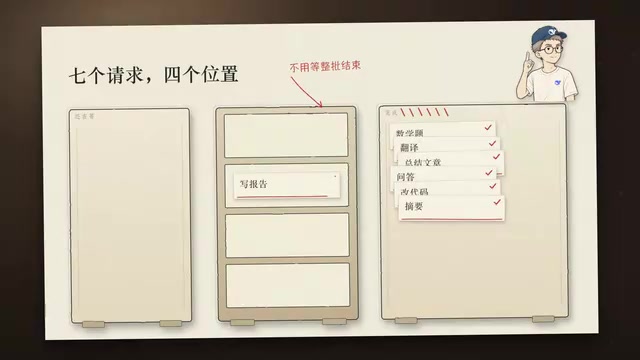
为什么运行模型还需要专门开发一套软件?当一个用户提交文章请求总结时,服务器中的计算设备需要先处理输入,再根据模型参数逐步生成回答。另一边,可能有大量其他用户正在提问数学题、撰写报告,这些请求长短不一、到达时间随机。如果设备每次只处理一个请求,其他人就只能排队。要让更多人同时得到回答,就必须把设备用好——这正是推理框架要解决的问题。
在请求调度层面,DeepInfer会把多个请求组成一批让计算设备一起处理,某个用户的回答生成完毕后将该请求移出,再让等待中的请求进入。这个安排会遇到一个硬性限制:每个请求都要占用设备内存(如显卡显存),一次放入的请求太多空间可能不够,放得太少设备又无法充分发挥作用。安排多少请求、何时加入,会同时影响等待时间和设备能处理的请求数量。此外,DeepInfer支持让一部分调度工作与设备上的计算同时进行,芯片计算时系统就可以准备后续任务,减少设备等待调度的时间。
推理与训练的区别:文章提到“推理”这个术语,它指的是用训练好的模型处理新输入、生成结果的过程,与“训练”(用大量数据调整模型参数)相对。推理通常更关注延迟(单个请求多快得到回答)和吞吐量(单位时间能处理多少请求),而训练更关注计算总量和收敛效果。DeepInfer作为推理框架,其设计目标正是优化这两项指标,而非改变模型本身的能力。
显存与批处理:文中提到“设备内存(如显卡显存)”,显存是GPU上用于存放模型参数、中间计算结果和请求数据的专用高速内存。每个并发请求都需要在显存中保留自己的上下文(如已生成的文本、注意力缓存),因此显存容量直接限制了同时处理的请求数量。批处理(batching)是将多个请求合并成一批一起计算,以提高GPU利用率,但批越大,每个请求分摊的显存也越多,需要在吞吐和延迟之间权衡。
计算优化与多芯片协作
请求进入设备之后,真正的运算才开始。一篇文章要经过大量运算才能生成摘要,DeepInfer会调用针对特定计算优化过的程序,例如FlashMLA和DeepGEMM,帮助设备更高效地完成这些步骤。模型运行也可能需要多张芯片协作,此时DeepInfer会把部分工作分配到不同芯片上并行计算,而芯片之间的数据交换方式和通信速度都会影响最终效果。具体能快多少,取决于使用的设备和配置。
FlashMLA与DeepGEMM:FlashMLA是一种针对注意力机制(Transformer模型的核心组件)优化的计算内核,通过减少显存读写和利用硬件特性来加速长序列处理。DeepGEMM则是针对矩阵乘法(模型中最主要的运算)的高性能实现,通常利用GPU的Tensor Core等专用单元。这类内核需要针对特定硬件架构手工调优,因此推理框架往往会集成多种优化内核,并根据设备自动选择。
DSPark:先猜再验证的加速思路
模型处理完输入后,还要把摘要一小段一小段逐步生成,因为前面生成的内容会影响后面接什么。
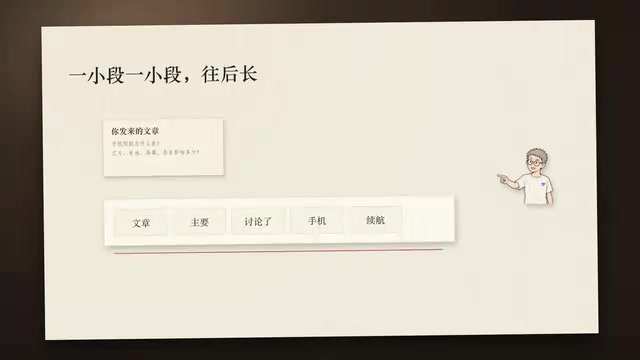
DeepInfer中的DSPark功能专门尝试加快这一步。它的做法是先让一个草稿模型猜测一小段可能出现的内容,再让负责生成回答的模型一次验证其中多个位置。例如文章讲手机续航,草稿模型猜后面可能接“手机续航受到哪些因素影响”,如果验证后开头一部分可以接受,系统就保留这部分,从没有通过的位置继续生成。一次验证如果能连续接受多个内容片段,就有机会减少主模型逐步往后算的次数。
这里用整句话举例只是方便理解,实际处理的单位不一定正好是一个词。先猜再验证本身也要花计算,猜中的部分多可能节省更多时间,经常不能接受则收益变小。DSPark还会估计候选内容被接受的可能性,帮助安排一轮验证多少内容。需要强调的是,这里的验证只判断候选内容能不能用于接下来的生成,并不能保证摘要里的事实都正确,文章有没有被总结错仍需另外核对。
投机解码(Speculative Decoding):DSPark采用的“先猜再验证”思路在业界称为投机解码。其核心是使用一个更小、更快的草稿模型生成多个候选token,然后由主模型并行验证这些候选。如果草稿模型猜得准,主模型一次前向就能接受多个token,从而减少逐步生成的总次数。这种方法不改变最终输出分布(在理想情况下),但收益取决于草稿模型与主模型的一致性以及任务类型。
输出格式约束与开发者可用能力
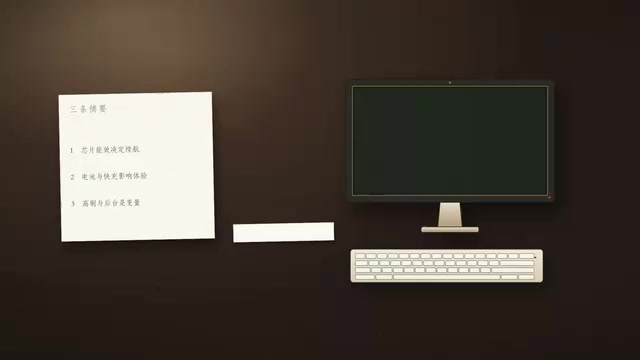
对把模型接入自己应用的开发者来说,生成文字之后还有一步:让应用能顺利读取这份摘要。DeepInfer支持对输出格式加约束,在特定配置下也支持让相同输入和设置得到可重复的输出,这有助于开发和检查。不过格式正确仍然不代表内容一定正确。
目前公开的DeepInfer版本支持DeepSeek V4.1 Flash,提供离线推理能力。开发者准备好受支持的设备和模型后,可以在自己的环境中提交输入让模型给出结果。官方仓库列出的硬件包括英伟达SM100架构的GPU以及华为昇腾950。
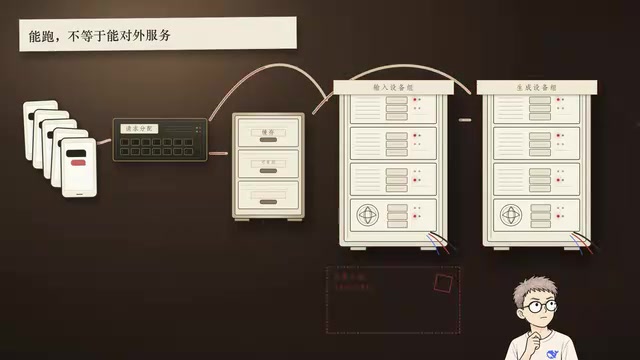
在自己环境中运行模型只是第一步。如果要把它做成让很多人同时访问的在线服务,还需要保存和管理可复用的缓存、把用户请求分配给不同设备、在需要时让处理输入和生成回答的设备组互相配合等配套工作。官方说明这些完整服务所需的配套系统没有全部包含在这次公开的版本里。开发者也有其他选择,比如vLLM支持多种模型并提供在线服务接口;DeepSeek在官方仓库中说明DeepInfer最初主要基于vLLM开发,也借鉴了SGLang和英伟达的TensorRT-LLM。选择哪套框架,取决于要运行的模型、手里的设备以及想搭建的服务类型。
对普通用户意味着什么
后台软件虽然不会出现在聊天界面上,但它的工作会影响几个熟悉的感受:发出去的问题多久开始得到回答、回答生成得快不快、使用的人多了以后服务能不能顺畅响应。如果运行效率提高,在其他条件相近时,同样的设备就有机会处理更多请求,或者用更少的资源完成相同的工作。
不过实际体验还取决于模型、设备和当时的请求量。DeepInfer开源本身不能保证每个人立刻感觉更快,也不能直接说明价格一定会下降。它的意义在于把DeepSeek模型运行和计算资源调度这一层能力开放出来,让开发者可以在自己的硬件上部署和验证推理能力,也为后续的在线服务生态提供了基础组件。
相关推荐

WorkBuddy智能体一句话跑通GEO数据库挖掘全流程
WorkBuddy智能体实现GEO数据库挖掘全自动化:从数据搜索、下载整理到批次校正、差异分析、共表达网络、特征基因筛选及免疫浸润分析,一句话提示词即可生成完整生信分析报告,大幅降低生信分析门槛。

PC内存被浪费?Hacker News热议集中式数据中心之争
Hacker News用户提出个人电脑内存被浪费、应集中到数据中心的观点,引发关于集中式与分布式计算资源分配的讨论。本文分析该观点背后的逻辑、集中化的代价,以及AI时代内存资源分配的新张力。

合理使用为何惠及所有人?OpenAI 发布多方案例解读
OpenAI 公开多份法院简报摘录,汇集创作者、学者、无障碍倡导者与法律专家的观点,解读合理使用如何支撑 AI 训练与创新,并分析其对开发者与内容从业者的实际影响。