DeepSeek开源DeepInfer:推理框架如何让AI服务更便宜

DeepSeek 开源推理框架 DeepInfer,公开日处理 155 万亿 token 的后厨调度经验。
DeepSeek 开源推理框架 DeepInfer,并公开其单集群日处理 155 万亿 token、单卡每小时收入 38 美元的运营账本。文章用饭馆类比解释推理框架的定位:训练是学手艺,推理是开门接客,框架就是后厨调度系统。技术上,DeepInfer 将 prefill 与 decode 分离部署,用 KV 缓存复用前缀使 96% 的输入命中、单卡吞吐提升 25 倍,再以投机解码和专家负载均衡把最忙卡与均值差距压到 9%。但开源版仅支持英伟达 SM100 与华为昇腾 950 且只能离线推理,线上组件需自行补齐。其真正价值在于把推理优化经验从各家私藏变为公开讨论,有望推动 AI 服务成本下行。
DeepSeek 又开源了,这次不是新模型,而是一个叫 DeepInfer 的推理框架。更关键的是,它顺手把"账本"亮了出来:一个集群一天处理 155 万亿个 token,按低谷时段价格算,平均每张卡每小时收入 38 美元。
推理框架到底是什么?为什么它可能让 AI 服务变便宜?用一家饭馆来类比,会清晰很多。
训练是学手艺,推理是开门接客
大模型的生命周期分两段。训练是厨子关起门来学手艺,推理是厨师出师后开店接客。DeepSeek广告 公告里的原话是:训练使模型学有所成,推理则让模型为人所用。
手艺再好,成千上万人同时涌进来点菜,谁先做、灶台怎么排、料怎么不浪费,得有人管。推理框架就是这套后厨调度系统。它不改变菜的味道,但决定了同样的厨房一小时能出多少盘菜、浪费多少食材。
这次开源的 DeepInfer,本质上是把 DeepSeek 自己后厨的排班表和管理手册公开了。
一条消息背后的两步:备菜与出菜
你每发一条消息,后厨其实分两步干活。
第一步叫 prefill,也就是备菜:把你的问题、聊天记录、上传的文件一口气读完,一次就是几万个 token,主要拼算力。第二步叫 decode,也就是出菜:答案一个字一个字往外蹦,每蹦一个字都要回头翻一遍前面备好的料,慢就慢在反复翻料上。
这两类活脾气完全不同。DeepSeek 干脆把它们拆开,放到不同机器上:备菜用常见的 8 卡机器,出菜用 64 到 128 张卡的超节点,两边卡数需求大致 1 比 1。这种分离式部署,是提升整体吞吐的结构性前提。
最省钱的一招:KV 缓存的"小本本"
现在很多人让 AI 当智能体干活,每调用一次工具,都要把系统提示、工具说明、之前每一轮的对话和结果整个重新发一遍。这就像一位熟客每加一道菜,都要把前面点过的几十道统统念一遍。
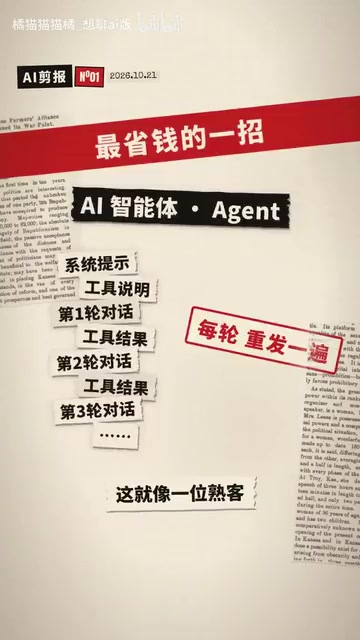
DeepSeek 的办法是:念过的,后厨记在小本本上,下回只算新加的那一节。这个小本本就是 KV 缓存。
效果有多夸张?平均每个请求输入 77000 token,其中 96% 能直接命中缓存,不用重算。同一张卡,不算缓存每秒处理 6 万 token,算上缓存是 150 万 token,整整差了 25 倍。
前提是开头必须从第一个字起一模一样,中间改一个字,后面都得重算。因此缓存有效期按场景区分:
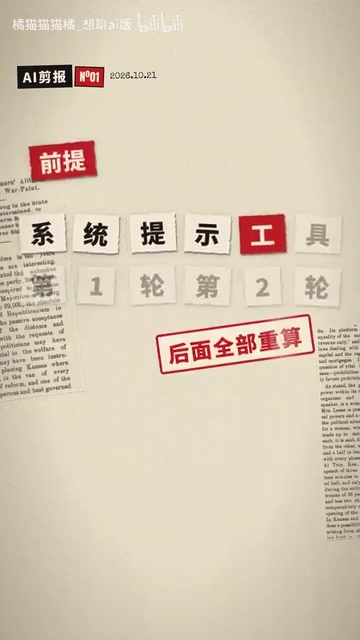
聊天场景的小本本留 7 天,智能体场景留 3 天。这个细节说明缓存策略不是拍脑袋,而是按复用频率和成本算过账的。
KV 缓存(Key-Value Cache)是大模型推理中的一项核心内存优化技术。Transformer 模型在生成每个 token 时,需要对之前所有 token 计算注意力(attention),其中 Key 和 Value 矩阵的计算结果只依赖历史上下文、与当前新 token 无关,因此可以缓存下来复用。若不缓存,每生成一个新字都要把前面几万个 token 的 K、V 重算一遍,计算量随上下文长度呈平方级增长。KV 缓存把这部分结果存进显存,新 token 只需计算自己的 Query 并与缓存做一次注意力即可。代价是显存占用:缓存大小正比于上下文长度、层数和注意力头维度,长上下文场景下可能吃掉数十 GB 显存,这也是为何缓存有效期、淘汰策略和前缀匹配(prefix caching)成为推理系统设计的关键权衡点。
出菜阶段:猜字、验算与专家排班
出菜这头,DeepSeek 也在抢时间。常规做法是算一步出一个字,他们用的 DeepSpark 则是先一口气猜出后面还会出什么,再一起验算;猜对了就一次出好几个字。系统还会掂量每个猜测靠不靠谱,太悬的干脆不验,把算力留给别的请求。光这一下,线上吞吐就多了 6%。
一套组合拳下来,出菜阶段每张卡每秒能生成 14000 个 token。
还有一个值得注意的细节:V4.1 Flash 里有 384 位"专科厨师",也就是专家,每个 token 只请其中几位。DeepSeek 把他们分到 64 张卡上,每张卡 6 位,再加一位热门大厨的分身。调度上,每 1000 步看一次谁最忙,每 10000 步重新排一次班,最后最忙的那张卡只比平均水平多忙 9%。
负载均衡做到这个粒度,意味着算力浪费被压得很低。这和技术细节一样重要,甚至更能解释那 155 万亿 token 的吞吐是怎么来的。
投机解码(Speculative Decoding)是加速自回归生成的常用手段。常规解码每次前向只产出一个 token,受限于显存带宽而算力闲置。投机解码先用一个小而快的草稿模型(或模型自身的轻量头)连续猜出多个候选 token,再用目标大模型对这串候选做一次并行前向,一次性验证哪些被接受。数学上可证明,只要接受规则满足特定条件,输出分布与原模型完全一致,因此是无损加速。猜对越多,单次前向产出的 token 越多,吞吐提升越明显;猜测命中率低时收益下降,所以系统需要动态判断候选的可信度。这与文中 DeepSpark 先猜后验、太悬的不验的做法一致,也是当前 vLLM、TensorRT-LLM 等主流框架普遍支持的优化方向。
混合专家模型(MoE,Mixture of Experts)把前馈层拆成多个并行的"专家"子网络,每个 token 经门控网络(router)只激活其中少数几个,从而在参数量巨大的同时保持单次计算量可控。V4.1 Flash 的 384 位专家、每 token 只请几位,正是这一结构。难点在于专家并行(Expert Parallelism):不同专家分布在不同 GPU 上,token 需要跨卡路由,容易造成某些卡过热、某些卡闲置的负载不均。业界常用做法包括容量因子限制、token 丢弃与重排、以及定期根据实际路由统计重新分配专家所在设备。文中每 1000 步监测、每 10000 步重排班,就是缓解 MoE 负载倾斜、把最忙卡与均值差距压到 9% 的工程手段。
普通开发者能直接用吗?
先别急。开源这一版只支持英伟达 SM100 和华为昇腾 950,而且只能离线推理。想搭完整的线上服务,缓存系统、负载均衡这些还得自己补。官方也给了建议:想跑得高效,起步就是 64 张卡备菜加 6 个 token——这显然不是个人开发者能随手试的规模。
另外要澄清一个容易误读的数字:那 38 美元是 DeepSeek 自己的收入,不是你用它的价格。
文中提到的 SM100 是英伟达 Blackwell 架构数据中心 GPU 的计算能力代号(如 B200 系列),相比上一代 Hopper(SM90)在 FP4/FP8 算力与显存带宽上有大幅提升;昇腾 950 则是华为昇腾系列的新一代 AI 芯片。框架只适配这两类硬件,意味着其内核高度依赖特定的算子库、通信原语与显存层次,移植到其他 GPU 需要重写大量底层代码。离线推理指不对接实时请求队列,只做批量任务处理,因此不包含在线服务必需的请求调度、动态批处理(continuous batching)、缓存淘汰、故障转移等组件。这也解释了为何官方建议的起步规模高达 64 卡量级:分离式部署与专家并行本身就以多机多卡为前提设计,小规模运行反而难以体现其吞吐优势。
这次开源的真正价值
以前我们只能吃到端上来的菜,现在 DeepSeek 把后厨怎么排班、怎么省料写成了说明书摊开。每天 155 万亿个 token 是怎么接下来的,全世界都能照着学。
学的人多了,做 AI 服务的成本就可能往下走,最后省钱的是用的人。当然,到底能省多少,取决于各家的硬件和工程能力,套用别人的排班表不等于自己的厨房也能跑出同样的效率。
对行业来说,DeepInfer 的意义不在于多了一个框架,而在于推理优化的经验从"每家自己摸索"变成了"可以公开讨论"。这或许比任何单一模型发布都更能推动 AI 服务价格下行。
相关推荐

前端转AI Agent开发:一线架构师解析职业路径与红利
一线AI架构师解析前端转AI Agent开发的行业变化与落地路径:纯前端岗位为何消失、Agent+全栈为何成为招聘主流,以及Agent开发工程师、FDE、远程接单三条转型路线和对应学习策略。

AI Agent开发课程怎么选?五条避坑指南
机械转行开发者踩坑两年总结的AI Agent开发课程筛选清单:完整交付链路、可写进简历的项目、真实开发视角、更新频率、陪跑反馈五个维度,附具体判断方法和避坑要点。

扣子(Coze)智能体搭建入门:零代码开发AI Agent实战指南
扣子(Coze)是字节跳动推出的一站式AI应用开发平台,支持零代码拖拽搭建AI智能体。本文基于B站教程梳理扣子的核心概念、三大优势、国内版与国际版差异,以及智能体与应用的区别,帮助初学者快速入门AI Agent开发。