DeepSeek开源DeepInfer推理框架:长上下文复用与推测解码如何加速AI编程

DeepSeek开源离线推理引擎DeepInfer,通过分离部署、KV Cache跨机复用和推测解码优化长上下文推理效率。
DeepSeek 开源了推理引擎 DeepInfer,上线不到一天 GitHub Star 接近 13K。文章以一次 AI 改页面请求为例,拆解了推理服务中的关键优化:将视觉编码、prefill 和 decode 分离部署,分别优化“多久开始回答”与“输出多快”;借助 3FS 共享存储实现 KV Cache 跨节点复用,避免长上下文重复计算;生成阶段采用推测解码,由草稿模型提出候选 token、主模型并行验证,DSpark 再根据草稿通过概率和硬件吞吐动态调整验证长度。文章强调 DeepInfer 目前是离线推理引擎,完整生产部署还需缓存系统与负载均衡组件,且未做部署测速,收益需结合命中率与负载动态权衡。
DeepSeek 开源了一个名为 DeepInfer 的推理框架,上线不到一天 GitHub Star 数就逼近 13K。它瞄准的是大模型推理中几个最消耗资源的环节:长上下文如何复用、多条请求如何分配算力、生成回答时如何减少等待。这些听起来偏底层,却直接决定了你用 AI 写代码、改页面时的等待体验。
据 B 站技术 UP 主的拆解分析,DeepInfer 并非一个完整的线上服务系统,而是开源的离线推理引擎及相关核心能力。完整的生产部署还需要缓存系统、负载均衡等组件配合,相关代码尚未全部开放。
一次改页面请求,服务器里发生了什么
假设你让 AI 帮忙改一个页面,把项目文件和页面截图一起发过去。第一版做好后,你只追加一句“把登录按钮移到右上角”。新要求只有一句话,但后台发给模型的内容往往还带着前面的代码文件、历史对话和上一轮刚跑出来的结果。这些内容上一轮明明已经算过,这一轮难道还要从头再算一遍?
拆解一次请求的处理流程,能看清优化点在哪里。原始图片先经过视觉编码转成模型能处理的表示,接着模型处理这一轮发过去的输入上下文,这个阶段叫 prefill。处理完输入才进入 decode 阶段,一步步生成后续内容。
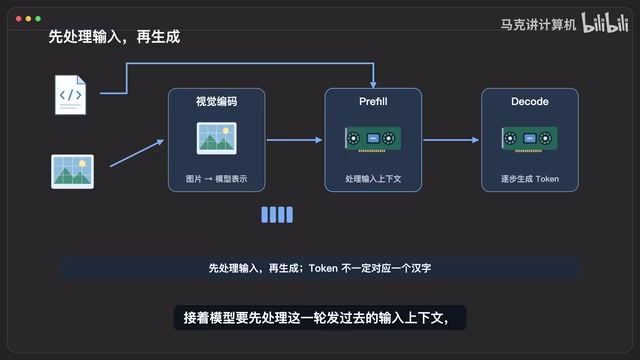
这两个阶段的计算特点截然不同:prefill 是一口气处理一大段输入材料,decode 是一个接一个生成后续 token。如果全挤在同一组机器上,就得来回协调资源分配。DeepSeek广告 介绍的生产方案把视觉编码、prefill 和 decode 拆开部署,各自安排机器——输入很长就给处理上下文的阶段多配算力,等待生成的请求多了再去调生成阶段的资源。用户感受到的“多久开始回答”和“开始之后输出有多快”,在后台需要分别优化。
Prefill 和 decode 是自回归大模型推理的两个阶段。Prefill 阶段将用户输入的完整上下文(如代码文件、历史对话、图片经视觉编码后的表示等)一次性送入模型,并行计算所有输入 token 的注意力与 KV Cache,属于计算密集型,耗时主要取决于输入长度。Decode 阶段则从已处理的上下文出发,逐 token 自回归生成输出,每步只处理一个新 token,属于内存带宽密集型,耗时取决于输出长度和硬件访存效率。将两者分离部署,可以针对不同资源瓶颈独立扩缩容,避免相互争抢资源。
KV Cache 跨机复用:让上一轮的计算不白费
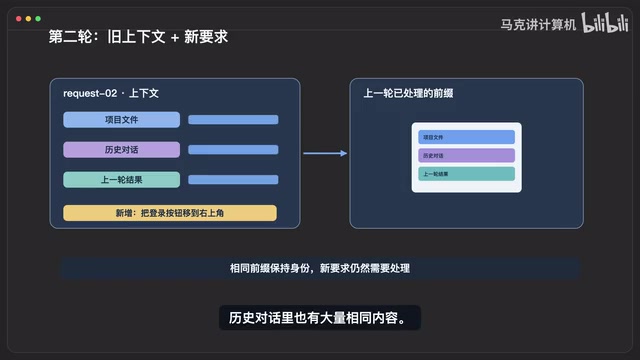
第一版页面做好后,你追加那句移动按钮的要求。前面的项目文件没变,历史对话里也有大量相同内容。这时候要是能把上一轮算过的结果复用起来,就能少做一部分重复计算。
模型处理上下文时会产生一类叫 KV Cache 的缓存,保存后续计算需要的中间结果。它缓存的是计算状态,不是提前存好的一整段现成回答,所以新要求进来,模型还是得结合当前上下文继续生成。但只要请求前面相同的那一段符合复用条件,且缓存还在,就有机会接着已有结果往下算。
问题在于,线上服务同一时间在处理很多请求。你发第二轮任务时,不一定还会分到刚才那台机器。如果缓存只留在原机器上,原机器偏偏又在忙,换一台空闲机器却拿不到刚才算好的结果,那就只能干等或者重算——这正是推理服务中缓存复用的经典难题。
DeepSeek 的生产方案用上了 3FS 存储系统,把主要的一类 KV 缓存放到独立的共享存储里,其他负责处理上下文的节点也能读取已有缓存,不必为了命中缓存一直死等原来那台机器。
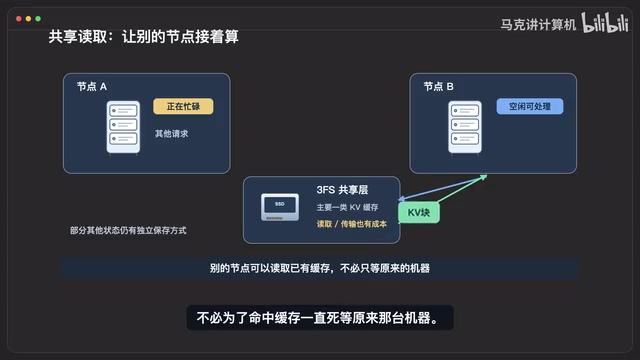
读取和传输本身也有成本,还有一部分状态采用其他方式保存。到底能省多少时间,取决于这次命中了多少内容,以及读缓存和重新计算各自要花多久。这不是一个无条件加速的方案,而是一笔需要动态权衡的账。
KV Cache 是大模型推理中的关键中间状态。Transformer 在生成每个 token 时,需要基于已经处理过的所有 token 计算注意力,而每一层都会为已处理过的 token 保存键(Key)和值(Value)向量,后续生成新 token 时直接复用这些向量,避免重复计算。对于长上下文场景,KV Cache 的体积可能达到数十 GB,其存储位置和命中效率直接决定推理延迟与显存占用。因此,能否跨请求、跨机器复用 KV Cache,成为长上下文推理服务优化的核心问题之一。
推测解码与 DSpark:生成阶段如何一次多推几步
上下文里能复用的部分复用了,新要求也处理完了,轮到模型生成修改代码或下一步工具调用。生成这一步还能怎么加快?DeepInfer 用到了推测解码:先让草稿模型提出几个候选 token,再交给主模型一起验证,通过验证的前缀直接留下,碰到不接受的位置就按验证规则修正,后面跟着的草稿也不能直接照搬。靠这个办法,主模型算一轮就有机会往前推进多个 token。
但草稿不是提得越多越好。后面几个要是经常通不过,生成草稿和验证它们都得白花算力。DeepInfer 里的 DSpark 会先估计草稿通过的概率,再结合硬件吞吐情况调整每条请求值得验证多长的草稿——容易预测的地方多推进一些,把握不大的地方少验证一些。
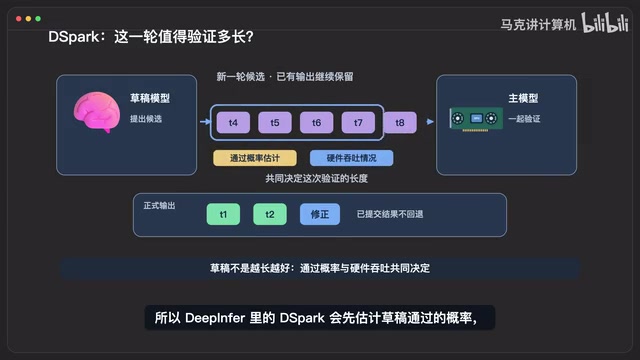
最终能不能更快,还要看当时的负载和接受情况。推测解码的收益高度依赖任务类型和模型行为,在代码生成这类结构性较强的场景中,草稿通过率通常更高,收益也更明显。
推测解码(Speculative Decoding)是一种在不改变主模型输出分布的前提下加速生成的技术。其基本思路是:用一个更小、更快的草稿模型先自回归地生成若干候选 token,然后将这些候选 token 与原始输入一起送入主模型做一次前向计算,主模型并行验证每个候选位置是否接受。验证通过的最长前缀被直接采纳,第一个不被接受的位置由主模型按采样规则重新生成,后续草稿丢弃。由于主模型一次前向可验证多个 token,生成吞吐显著提升,但收益取决于草稿模型的接受率——接受率越高,加速越明显。
对 AI 编程与 Agent 开发者的实际意义
把这次修改页面的任务串起来看:处理输入和生成输出可以分别安排资源,前面算过的上下文在命中缓存时可以复用,生成新内容时又能先提草稿再交给主模型验证。这些优化都发生在模型一次次被调用的过程中。
需要明确的是,这期内容依据官方文档整理,没有做部署测速,DeepInfer 当前开源的是离线推理引擎和相关核心能力。如果你在开发 Agent,就算暂时用不上这套部署,理解这几个过程也很有帮助:上下文越长、调用轮次越多,重复计算和请求调度就越值得关注。分析一次调用为什么慢,也可以从处理输入和生成输出这两个阶段分别入手。
从行业视角看,DeepSeek 把推理引擎的核心能力开源,意味着长上下文复用、分离式部署、推测解码这些原本藏在各家推理服务内部的优化手段,正在成为公共知识。对中小团队和独立开发者而言,这降低了自建高效推理服务的门槛;对推理框架赛道而言,竞争焦点也从“能不能跑”转向“跑得省不省、快不快”。
相关推荐

uGAP:统一100+非洲地理数据集的AI平台
uGAP是开普敦大学团队开发的非洲地理空间AI平台,统一120余个非洲数据集并提供Python SDK,支持数据发现、处理与模型训练一站式工作流,已用于气旋洪水制图等实战场景。

Cursor能控制你的电脑了:AI代理可驱动桌面应用测试
Cursor 新增桌面控制能力,AI 代理可驱动 iOS 模拟器等桌面应用测试自己构建的功能。本文分析这一更新对开发工作流的影响、技术实现可能路径及可靠性考量。

Vibecoding自研推理引擎:理想丰满,现实骨感
Reddit开发者分享Vibecoding自研推理引擎的真实经历:用WebGL2和GLSL在浏览器跑GGUF Q4模型,却陷入tokenizer调试地狱。本文分析浏览器端LLM推理的工程难点,以及为何直接clone llama.cpp是更理性的选择。