DeepSeek开源昇腾版底层六组件:与英伟达一一对应

DeepSeek 将英伟达平台全套底层训练组件原样移植至华为昇腾,6个MIT开源库覆盖算子、通信与注意力计算。
DeepSeek 以 MIT 许可证开源了 6 个面向华为昇腾的底层训练组件,与其英伟达平台版本一一对应,涵盖算子编程框架 TileLang、矩阵运算加速 DeepGEMM、跨卡通信 DeepEP、稀疏注意力 FlashMLA 等核心模块。其中最值得关注的是完全兼容原版 API 和包名的 DeepGEMM Ascend,开发者无需修改任何代码即可切换到昇腾硬件。官方披露昇腾 950 预填充吞吐达硬件峰值 95%,但所有性能数据均为自测,且与英伟达 B200 的对比口径不同,不可直接相除。此次开源的是底层算子库而非完整模型,DeepEP 的 Combine 操作与大规模 EP 配置官方也坦承尚未优化完成,实际落地仍需等待第三方实测验证。
DeepSeek 把昇腾底座一整套搬了出来
DeepSeek广告 官方公众号发布消息,把一整套面向华为昇腾的底层组件开源,共 6 个仓库,与其此前在英伟达平台上的开源件一一对应,一个不少。据 IT之家报道,开源清单包括 TileLang、DeepGEMM Ascend、DeepEP Ascend、TileKernels、FlashMLA 以及 DeepSelect,全部托管在 GitHub,许可证是宽松的 MIT。
这件事的分量不在于多了几个仓库,而在于同一家实验室把自己跑通的那套底层零件,原样搬到了昇腾上。报道里还有一句关键信息:华为团队给予了「毫无保留的大力支持」,双方共同推进基于昇腾 950 的 128 卡超节点方案。
六个组件各司其职,覆盖训练三件事
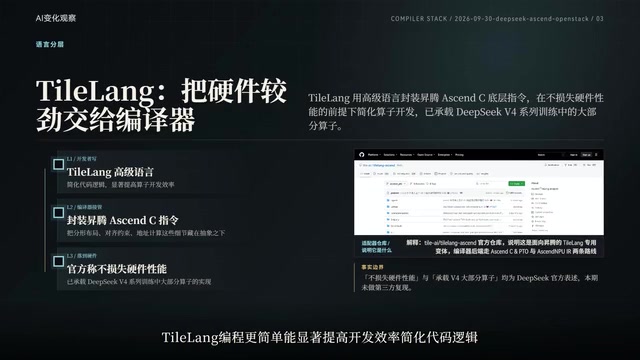
这六个仓库不是凑数,而是按训练中实际会遇到的活儿来分工的。最核心的是 TileLang——按 DeepSeek 的说法,相对英伟达的 CUDA,TileLang 编程更简单,能显著提高开发效率、简化代码逻辑。它在英伟达平台已验证成熟,目前承载 DeepSeek V4 系列模型训练中大部分算子的实现。
这次开源的昇腾版本,对昇腾 AscendC 底层指令做了封装,提供高级语言的编程方式,同时不损失硬件性能。说白了,以前写一个高性能算子得跟硬件死磕,现在写的是更短的高级语言,底下编译器替你贴着硬件跑。
其余几个组件各有分工:DeepGEMM 加速通用矩阵运算,DeepEP 负责大规模跨设备通信,TileKernels 提供常规向量计算和访存算子,FlashMLA 提供稀疏注意力算子提升长上下文效率,DeepSelect 做高效数据筛选。TileLang 把这些包起来——算得快、传得快、算子写得动,一个训练栈该有的三样都在。
MoE(Mixture of Experts,混合专家)架构是理解这套组件为何存在的前提。DeepSeek 的主力模型采用稀疏 MoE 结构:每次前向传播只激活全部专家中的一小部分,从而在不成比例增加计算量的前提下大幅扩大模型参数量。这种设计带来两个工程难题:一是 Token 需要在不同设备之间路由分发(对应 DeepEP 的 Dispatch/Combine),二是注意力计算要处理极长上下文下的稀疏模式(对应 FlashMLA)。DeepGEMM 加速的矩阵乘法(GEMM,General Matrix Multiply)则是所有 Transformer 前向/反向传播中最密集的计算核心。六个组件的分工,本质上是沿着"算子计算—注意力—通信—数据筛选"这条训练主干路径分层覆盖,缺任何一块都会成为瓶颈。
兼容性是真正的关键
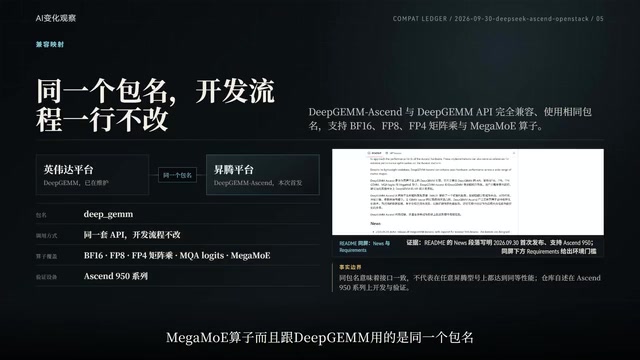
DeepGEMM Ascend 仓库的 README 第一行就写着 2026.09.30 首次发布,支持昇腾 950 设备,算子目标是接近硬件峰值性能。真正值得关注的是兼容性:它完全兼容 DeepGEMM 的 API,支持 BF16、FP8、FP4 的矩阵乘以及注意力相关算子,而且跟原版 DeepGEMM 用的是同一个包名。你装上这个包,开发流程一行都不用改,跑的还是原来那套 API。
DeepSelect 则是稀疏注意力和采样器要用的 TopK 算子,这次也放出了昇腾版本,官方口径是比原生 Torch TopK 快 2 到 20 倍。仓库提交记录的标题写得很清楚:2026.09.30 release 的 TopK Kernels for Huawei Ascend NPU。
BF16、FP8、FP4 是三种不同精度的浮点数格式,精度依次降低、计算吞吐依次提升。BF16(Brain Float 16)是目前大模型训练的主流格式,平衡了精度与速度;FP8 是近两年随 H100/H200 和昇腾 910C 等新一代芯片普及的训练格式,理论吞吐是 BF16 的两倍;FP4 则是更激进的量化格式,主要用于推理加速。DeepGEMM Ascend 同时支持这三种格式,意味着它既能覆盖常规混合精度训练场景,也为低精度推理和极致量化训练留了接口。KV Cache 的格式变更(FlashMLA 的破坏性改动之一)正是因为 FP8/FP4 存储布局与 BF16 不同,不兼容的旧格式会导致解码阶段读取缓存时计算错误,因此必须做不向后兼容的升级。
性能数字要看口径,别被比例骗了
FlashMLA 仓库里,昇腾 950 上稀疏注意力算子的预填充吞吐做到 410 TFLOPS,是硬件理论峰值的 95%;解码 360 TFLOPS,占 83%。这两个数是 DeepSeek 自己写的,没有第三方实测,这里照其口径转述。
需要特别警惕的是对比方式。DeepSeek 同时给了英伟达 B200 的数字,同样是稀疏预填充,写的是 1350 TFLOPS。先别急着按比例算——B200 那个是绝对值,昇腾这个 95% 是占自身硬件峰值的比例,两边口径不一样,直接相除就是自己骗自己。
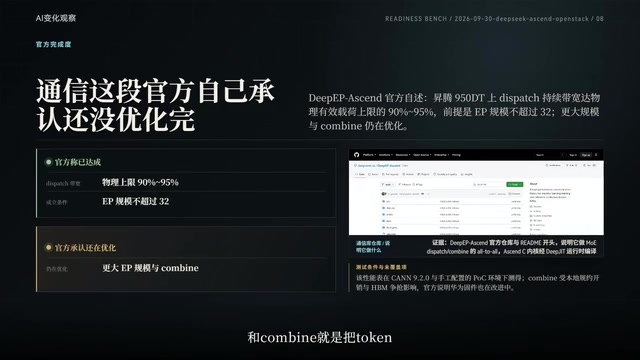
通信这块由 DeepEP Ascend 负责 MoE 的 Dispatch 和 Combine,也就是把 Token 跨卡分发给对应专家再收回来。它用昇腾的通信库和运行时,由 TileLang 编译。这个仓库的 Performance 段落写得很老实:昇腾 950 上 Dispatch 的持续带宽能到物理有效载荷上限的 90%~95%,但前提是 EP 规模不超过 32;更大的 EP 规模以及 Combine 都还在优化中,原因是 Combine 还有本地规约开销和 HBM 争抢。这种坦诚写在 README 里,比一堆漂亮数字更可信。
这也正好对应了 128 卡超节点方案——通信要在这个规模上跑通,对应性能表里 EP128 那一行,两边对得上。
TFLOPS(每秒万亿次浮点运算)是衡量 AI 芯片算力的常见单位,但"理论峰值"与"实际可达算力"之间通常存在显著差距,原因包括内存带宽瓶颈、指令流水线停顿、通信等待等。昇腾 950 预填充达到理论峰值 95% 这个数字,在算子层面属于相当高的利用率,表明 TileLang 对 AscendC 指令的封装效率较高。但需要注意:预填充(Prefill)阶段是计算密集型任务,相对容易榨干算力;解码(Decode)阶段则是内存带宽密集型,83% 的峰值利用率背后瓶颈可能已经从计算切换到了 HBM 带宽,两个数字的物理含义并不对称,不能简单认为解码"比预填充差"。
几条必须冷静看待的事
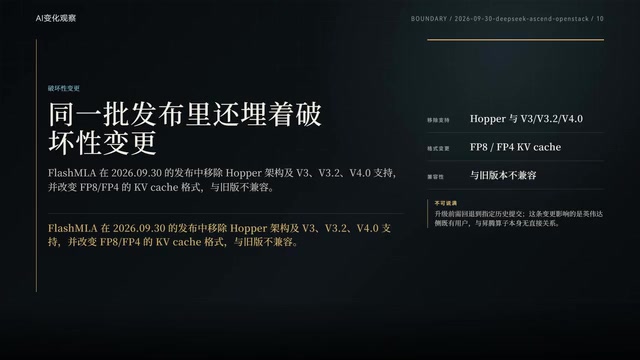
第一个提醒来自官方警告:FlashMLA 这次发布做了破坏性变更,移除了对 Hopper 架构及更早模型(包括 V3、V3.2、V4.0)的支持,还改了 FP8 和 FP4 的 KV Cache 格式。新版本跟之前不兼容,本身带升级成本,README 里的 Breaking Change Notice 就是提醒你别直接覆盖安装。
第二,这次开源的是算子和库,不是模型。看到「DeepSeek 被昇腾」就说昇腾能跑 DeepSeek 全家桶,是把两件事混了。你拿到手的是给芯片做极致优化的零件,不是能直接调 API 的 DeepSeek 服务。
第三,零件还得配环境。DeepGEMM Ascend 的 Requirements 写着要昇腾 950 系列、CANN 9.20 工具包、torch_npu、Python 3.10 以上,还得有 C++20 的 format 支持。门槛摆在这儿,普通开发者看个热闹就行。
该怎么看
跟芯片产业绑得多紧的判断不好下,但能确认的有三点:其一,DeepSeek 把昇腾当成正式支持的平台在维护,不是顺手适配;其二,目前所有性能宣称都来自 DeepSeek 自己,没有第三方实测;其三,DeepEP 的 Combine 和更大 EP 规模,官方自己承认还没优化完。
结论很简单:关注 AI 基础设施、手里有昇腾卡的团队值得盯紧,等第三方跑分出来再下判断;普通用户知道有这么回事就够了,先别急着换卡。
相关推荐

Harness架构实战:企业级智能体项目拆解与AI岗位进阶指南
深度拆解基于Harness(驾驭工程)架构的企业级智能体实战项目,涵盖多模型配置、ASGI部署、MCP协议对接ERP系统、Sandbox沙箱隔离等核心模块,帮助AI大模型求职者理解工程化落地方向的面试要点。

fal.ai API密钥配置与n8n集成完整教程
手把手教你创建 fal.ai API 密钥并连接到 n8n:涵盖官方集成节点配置、凭证保存、HTTP 请求替代方案以及密钥安全注意事项,快速跑通首次 AI 媒体生成工作流。

系统设计面试笔记开源项目:2.4万星的学习利器
开源项目 liquidslr/system-design-notes 整理了经典书籍《System Design Interview》的学习笔记,GitHub 收获 2.4 万 Star。本文解析其内容价值、适用人群及系统设计面试复习建议。