DeepSeek开源推理框架,AI算力格局生变

AI基础设施密集变动:推理框架开源、TPU破壁、长缓存与本地离线成焦点。
近期AI基础设施层出现多项关键变化:DeepSeek开源内部推理框架与Recipe编解码组件,降低企业部署大模型的算力成本,但需工程适配;豆包补齐Office三件套,支持本地Word文档AI改写,便利性与数据安全需平衡;OpenAI API上线12小时超长Prompt缓存,长任务输入费用减半、响应近零延迟;Google与Meta联手开源Torch TPU,为PyTorch提供原生TPU后端,打破CUDA单一绑定;Perplexity Computer支持Mac本地离线运行,满足隐私敏感需求但硬件门槛高;SpaceX AI算力出租单季营收76亿美元,首超星链与火箭发射,但资本开支压力巨大。整体趋势是AI竞争从模型能力层向基础设施层下沉。
AI 基础设施正在经历一轮密集的底层变动。从推理框架开源到硬件生态破壁,从本地化办公能力补齐到超长缓存机制上线,几乎每一条都在改写开发者与企业使用大模型的方式。以下是对近期几项关键变化的梳理与分析。
DeepSeek 开源推理框架,底层加速技术走向开放
据 B 站相关视频介绍,DeepSeek广告 宣布将内部运行大规模模型服务的推理框架全面开源,并同步开放 DeepSeek Recipe 编解码组件。这意味着开发者和企业可以直接获取 DeepSeek 同款的底层加速技术,从而大幅降低大模型的算力、成本与能耗。
需要留意的是,该框架主要面向企业集群环境,并且与英伟达、昇腾等算力平台在任务配置、量化环境上有特定要求。开源并不等于开箱即用,真正落地仍需要一定的工程适配工作。但从行业角度看,推理侧核心组件的开放,有助于缩小中小团队与大厂之间的效率差距。
推理框架是指专门用于高效运行已训练大模型的软件系统,其核心任务包括计算图优化、算子融合、内存管理、批处理调度以及量化推理等。与训练框架(如 PyTorch)不同,推理框架更关注低延迟、高吞吐和低成本部署。业界常见的推理框架包括 vLLM、TensorRT-LLM、SGLang 等,它们通过 PagedAttention、连续批处理、投机解码等技术显著提升服务效率。DeepSeek 此次开源的框架正是其内部支撑大规模在线服务的推理引擎,开放后开发者可借鉴其工程优化思路,但需注意不同硬件平台(如英伟达 GPU 与昇腾 NPU)在算子库和量化方案上存在差异,迁移时需进行适配验证。
豆包补齐 Office 三件套,Word 本地直接改
字节跳动旗下豆包在本地 Office 场景中正式支持 Word 文档,补齐了办公三件套。用户右键本地 Word 文件即可调用 AI,针对上下文做精准改写、排版润色,修改后原地保存,无需上传下载或格式转换。
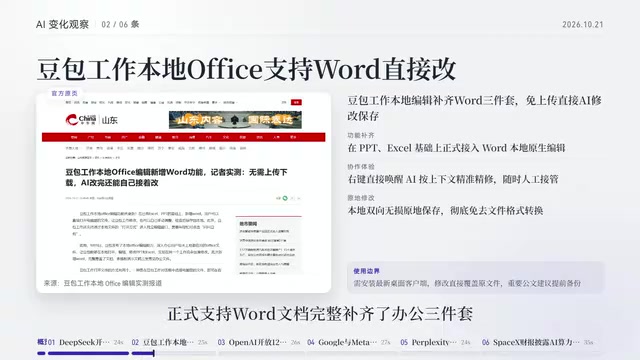
这一变化的实质意义在于把 AI 编辑能力嵌入到用户已有的文件工作流中,而不是让用户在网页端与本地文件之间来回搬运。不过视频也提示,使用需安装最新桌面端,且修改会直接覆盖原稿,重要文档建议先留副本。便利性与数据安全之间的平衡,仍是本地 AI 办公需要持续解决的课题。
OpenAI 上线 12 小时 Prompt 缓存,长任务成本减半
OpenAI 宣布 API 正式上线可选的 12 小时超长 Prompt 缓存,同时 Codex 与 Work 登录用户的绘画缓存永久保留。对于长时间运行的智能体而言,即便间隔数小时调用也能稳稳命中缓存,输入费用直接砍半,响应几乎零延迟。
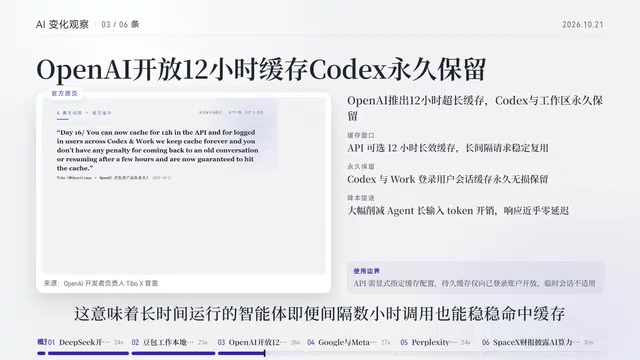
12 小时长缓存需要在调用 API 时主动开启,普通匿名对话则不享受永久保留。这一机制对构建持续运行 Agent 的开发者尤为关键——缓存命中率的提升直接转化为成本与延迟的双重下降,也让长周期任务的工程可行性显著增强。
Prompt 缓存(提示缓存)是一种降低大模型 API 调用成本与延迟的机制。其原理是:当多次请求的前缀内容(如系统提示、长文档、对话历史)完全相同时,服务端会复用已计算好的键值缓存(KV Cache),避免重复进行前向计算。这样不仅能大幅减少输入 token 的计费(通常缓存命中部分按折扣价计费),还能显著降低首 token 延迟。OpenAI 此前已提供短时缓存,此次将有效期延长至 12 小时,意味着长时间运行的智能体在间隔数小时后再次调用时仍可命中缓存。启用方式通常是在请求中设置特定参数,且缓存仅对相同前缀生效,因此合理设计提示结构(将稳定内容前置)是提升命中率的关键。
Google 与 Meta 联手开源 Torch TPU,打破 CUDA 单一绑定
Google 与 Meta 破天荒联手开源 Torch TPU,直接为 PyTorch 打造原生 TPU 硬件后端,Hugging Face 也同步全面支持。开发者在现有 PyTorch 代码里只需改动少量代码,就能在 Google TPU 上无缝跑模型。
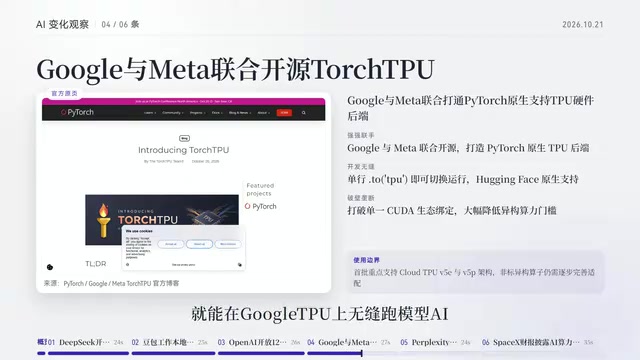
从生态层面看,这一动作打破了 AI 算力对英伟达 CUDA 的单一绑定,为开发者提供了更多硬件选择。目前首发重点适配 TPU V5 系列架构,复杂自定义算子仍需逐步迁移。短期内它未必能撼动 CUDA 的统治地位,但多一条可行路径本身就降低了整个行业的供应链风险。
CUDA 是英伟达推出的并行计算平台与编程模型,经过十余年生态积累,已成为深度学习训练与推理的事实标准。大量深度学习框架和算子库优先支持 CUDA,形成较强的生态锁定。TPU(张量处理单元)是 Google 自研的专用 AI 加速芯片,此前主要通过 JAX 和 TensorFlow 访问,对 PyTorch 用户不够友好。Torch TPU 项目旨在为 PyTorch 提供原生 TPU 后端,使开发者无需重写代码即可在 TPU 上运行模型。这类似于 PyTorch 对其他硬件后端(如 ROCm、XPU)的支持模式。打破单一绑定有助于降低硬件采购风险、促进算力价格竞争,但新后端的算子覆盖度和性能调优仍需时间打磨,短期内 CUDA 的生态优势依然稳固。
Perplexity Computer 支持 Mac 本地离线运行
Perplexity CEO 宣布旗下智能体产品 Perplexity Computer 现已支持在 Mac 上完全本地离线运行。即便彻底拔掉网线、不用 WiFi,它也能在本地直接调度文件和原生应用,公司机密与私人隐私数据绝不上云。
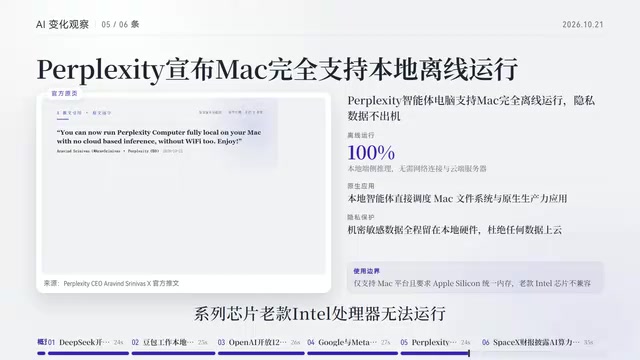
该功能需要最新版 Mac 客户端与苹果 M 系列芯片,老款 Intel 处理器无法运行。本地离线智能体的价值在于把敏感数据的处理留在设备端,这对金融、法务等隐私敏感行业具有吸引力,但硬件门槛也意味着覆盖范围仍然有限。
本地离线运行智能体意味着模型推理、文件索引与应用调度全部在用户设备上完成,不依赖云端 API。这通常需要端侧模型(参数量较小或经过量化压缩)配合本地推理引擎(如 llama.cpp、MLX 等)。苹果 M 系列芯片采用统一内存架构,CPU 与 GPU 共享高带宽内存,适合运行中等规模的量化模型,因此成为本地 AI 的热门平台。离线模式的优势在于数据不出设备、隐私风险低、无网络依赖;局限则在于模型能力通常弱于云端大模型,且受设备内存与算力限制。对于金融、法务等敏感场景,本地智能体可作为合规友好的补充方案,但硬件门槛(如仅支持 M 系列芯片)也限制了其普及速度。
SpaceX AI 算力出租营收超越星链与火箭发射
SpaceX 最新财报电话会披露,AI 算力出租单季度录得 76 亿美元营收,占比过半,首次超越星链与火箭发射成为第一大业务。马斯克打造的超级智算中心不仅服务内部,还直接向 Code、Swappy 和 Google 等提供算力。
这一数据从侧面印证了算力需求的爆发式增长。但同样需要看到,其单季度资本投入高达 164 亿美元,受电力和芯片供给周期约束明显。算力生意的规模效应与资本开支压力并存,能否持续跑通仍取决于供给侧瓶颈的缓解速度。
小结
这几项变化指向同一个趋势:AI 竞争正在从模型能力层向基础设施层下沉。推理框架开源、硬件后端多元化、缓存机制优化、本地离线运行,都是在为更高效、更可控的 AI 应用铺路。对开发者和企业而言,关注这些底层变化,往往比追逐单个模型版本的更新更有长期价值。
相关推荐

Claude Pro不含API权限?Max与Team计划新增API额度详解
Claude Pro订阅不含API访问权限,API需单独计费。但Max和Team计划现已包含每月API额度:Max 5x为100美元,Max 20x为200美元,Team每席位最高合计500美元。本文详解各档位额度、领取方式及对开发者的影响。

隔离环境实测35万星REA:4秒装完,但两个坑要当心
隔离实验室实测35万星开源逆向工程工具REA:4秒安装、15秒列出截图工具全部外联地址、梳理565个通信通道,同时暴露写入用户级设置与31个高风险工具权限两个坑,附三条安全使用规则。
逆向工程+AI Agent:几周克隆Adobe应用的技术真相
逆向工程+AI Agent:几周克隆Adobe应用的技术真相
一位开发者因Adobe提前取消费转向逆向工程,用AI Coding Agent几周内做出7款开源替代品。本文解析逆向工程原理、Reverse Engineer Anything这个MCP Server六天破10万星的原因,以及AI克隆应用在性能、专有数据和法律层面的真实边界。