DeepSeek开源推理框架:单卡年入33万美金背后的算力生意经

DeepSeek开源推理框架,亮出单卡38美金/小时的推理成本底牌,压缩行业溢价。
DeepSeek 于 10 月 20 日开源推理框架,配套文档罕见给出单卡 38 美金/小时的保底收入价,8 卡机器年收入约 266 万美金、折合人民币 1800 多万,成本约 350 万人民币。文章拆解了其技术核心:读写分离(Prefill 用 8 卡机器、Decode 用 64 或 128 卡大机器,可跨机房)、10 万 TB 分布式 KV 缓存池(智能体记忆留 3 天、聊天留 7 天)、小模型猜字使验证量减三成、吞吐提升 4% 到 7%,以及保证外部部署与官方 API 行为一致的接口兼容仓库。开源让推理黑箱被打开,卖推理服务的厂商溢价空间受挤压,AI 应用价格有望进一步下探。战略上,开源兼具为训练腾算力、应对美国联邦机构清除令、向投资人释放“手里还有更好牌”的信号三重意图。
DeepSeek 开源了一套推理框架,配套文档里白纸黑字写着一笔账:一张 B300 显卡跑满一年,收入 38 美金/小时 × 24 小时 × 365 天 ≈ 33 万美金。8 张卡凑一台机器,年收入 266 万美金,折合人民币 1800 多万。消息一出,B站UP主“梦梦”算完账后调侃“这钱不是我不想挣,是我先得有 8 张 B300”。玩笑归玩笑,这套框架真正值得琢磨的,是它掀开了推理服务成本结构的一角,以及 DeepSeek 在算力、生态和资本三条线上的战略意图。
一张卡年入 33 万美金:这笔账怎么算的
DeepSeek广告 在 10 月 20 日开源推理框架时,配套的技术问答里罕见地给出了“保底价”:一张卡一小时最低收入 38 美金。云厂商通常只报总营收,模型公司只报每百万 token 多少钱,没人把单卡每小时产出摆上台面。DeepSeek 不仅说了,还标了一个“兜底价”——意思是别拿峰值价来算,最低也能收到这个数。
按这个口径,8 卡机器一年收入 266 万美金,成本约 350 万人民币,半年回本听起来“谈谈的没问题”。更直观的对比来自处理能力:一个集群一天处理 155 万亿 token,相当于 4000 多万人聊一整年的量,它一天干完。
这套账并非凭空而来。2025 年 2 月 DeepSeek 发布的推理系统说明中曾算过成本:平均 226.75 个节点在跑,按 2 美金/卡/小时租,一天成本 8.7 万美金;按 R1 当时的价格收,一天收入 56.2 万美金,成本利润率 545%。去年算的是“我花了多少钱”,今年报的是“我收多少钱”——中间隔着的,就是一张卡能干多少活、能产多少钱。
技术拆解:读写分离、KV缓存池与猜字加速
这套框架最核心的改动,是把“读”和“写”拆开了。用户发一句话,模型先得把问题读完,这一步吃带宽;读完再一个字一个字往外蹦,这一步吃显存。两件事挤在一台机器上,两头都不痛快。DeepSeek 的解法是:读的时候用普通 8 卡机器,写的时候用 64 或 128 卡的大机器,最小适配是 64 张读、64 张写,共 128 张卡,读写甚至能放在不同机房,中间拿光纤连着。代价是光纤万一被施工挖断,够忙活一晚上;好处是首字延迟变快、出字变稳——用户刷短视频两秒没动静就滑走,AI 首字母慢了,用户同样会走。
第二件事是 KV 缓存。聊天时前面说的话模型得记得住,但记忆既花存储也花算力。一份合同贴进去,第二天再问同一份合同,只要记得住就不用把几万字重读一遍。DeepSeek 用分布式文件系统搭了一个容量 10 万 TB 的池子,给智能体跑的记忆留三天,给人聊天的留七天——老对话有长尾记忆,一小撮内容会被反复拿出来看,丢了命中率就下降,留久点是在给用户省成本。
第三是“猜字”:让小模型先猜几个候选,大模型再从里面挑一个比较有把握的,每一步验证的量减少三成,吞吐量涨 4% 到 7%。
另外还开源了一个管接口转换的小仓库,作用是让别人家部署的 DeepSeek 接口行为跟官方 API 一模一样。这解决了此前“官网顺手、别处部署又慢又蠢还流口水”的痛点。
Prefill 与 Decode 的计算特性差异是理解读写分离的前提。Prefill 阶段模型一次性并行处理整段输入,矩阵运算密集、算力利用率高,但需要瞬间搬运大量权重和中间激活,属于带宽瓶颈;Decode 阶段每步只生成一个 token,却要反复读取全部模型权重和 KV 缓存,属于显存带宽瓶颈,GPU 算力大量闲置。两类负载混跑会互相抢占资源,Prefill 的长请求还会拖慢同批 Decode 的首字延迟。业界常见的 Chunked Prefill、PD 分离(Prefill-Decode Disaggregation)都是为此设计,DeepSeek 的方案属于后者的大规模工程化落地。
KV 缓存指自回归推理时缓存每一层注意力机制中的 Key 和 Value 张量,使已处理过的上下文不必重复计算。以 70B 级模型、长上下文场景为例,单个请求的 KV 缓存可达数 GB,并发一高,显存迅速被占满,直接限制可服务的用户数。因此 KV 缓存既是显存成本,也是命中率资产:缓存命中即可跳过对应前缀的 Prefill 计算。业界的 Prefix Caching、PagedAttention 等手段都围绕它做优化,而 DeepSeek 把缓存下沉到分布式存储池、按场景设定保留时长,本质是在存储成本与重算成本之间做权衡。
同行反应:黑箱子被打开,推理溢价站不住了
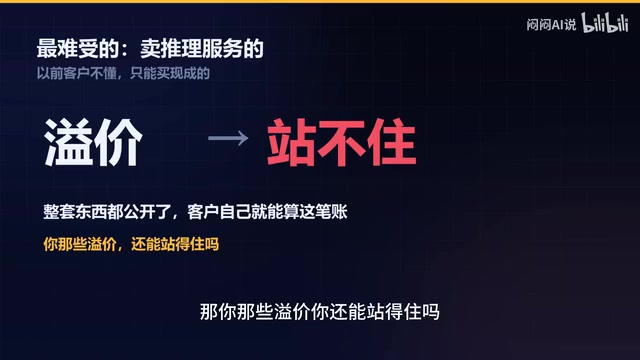
框架以前是黑箱子,你知道它慢,但不知道慢在哪。现在代码往这一摆,差哪就一行一行对着看。最难受的是卖推理服务的厂商——以前客户不懂,只能买现成的;现在整套东西公开,客户自己就能算一笔账。
UP主“梦梦”的判断是:AI 服务还会进一步降价。推理成本是国内几家打的最狠的一场仗,谁成本低谁就敢压价,手机助手、修图、翻译软件的价格都压在这一层。这次开源意味着后续软件很可能进一步降价。
战略意图:腾算力、做生意、给投资人看牌
开源背后有三层考虑。
第一,给自己腾算力。 那个管接口的小仓库解决了“外部部署体验不一致”的问题,用户不再往官网挤,官网的卡就能挪去训练下一代模型和搞 AGI。国内算力吃紧,几头抢卡的局面下,把服务摊子往外一扔,是实打实的减负。
第二,一笔生意账。 10 月 19 日美国国土安全部下令联邦民事机构清除 DeepSeek 产品,连第三方工具也要清,联邦合同不允许再签;紧接着 10 月 20 日这套框架就开源了。两件事挨着,官方没说明因果,但UP主的观点很直接:你封你的,我开源我的,你能管住机构采购,管不住一行一行代码往下下载。
第三,给投资人看的战略信号。 6 月 DeepSeek 完成首轮外部融资,规模 500 多亿,估值 500 亿美金,梁文峰自己掏了 200 亿占四成;10 月又传出第二轮融资规模加到 1000 亿,中金正在做科创版上市辅导;9 月还挖了一个 CFO 进去。钱有了、人有了、通道有了,这个节骨眼上把“吃饭的引擎”开源,图的是让人看见:这套东西我能给出去,手里就有更好的,下一代模型和 AGI 我还能做。梁文峰持股八成多,公司值多少钱跟他个人身家绑在一起,投资人看的是明天还有没有牌。
**投机解码(Speculative Decoding)**是“猜字”环节对应的学术名称:用一个小的草稿模型先自回归生成若干候选 token,再由大模型一次前向并行验证,接受的 token 直接采用,被拒的从第一个错误位置重新采样。由于验证是并行计算,大模型实际前向次数减少,而输出分布与纯大模型采样在数学上保持一致(贪心或按修正后的接受概率采样)。其收益取决于草稿模型的接受率与两模型开销比,常见提速在 1.5 至 3 倍之间,DeepSeek 报告中验证量减少三成、吞吐提升 4% 至 7%,属于相对保守的工程收益。
编辑观点
单卡 38 美金/小时的“保底价”是这套框架最值得关注的信号——它把推理生意的成本底牌亮给了所有人,也把竞争从“卖服务”推向“拼效率”。读写分离和 KV 缓存池不是炫技,是实打实地在首字延迟和长对话成本上做优化,这些工程细节最终会传导到终端软件的价格上。至于开源时机与封杀令的先后,官方没有说明关联,但一个可观察的事实是:代码一旦公开,封锁机构采购容易,封锁技术扩散很难。对普通用户来说,这场算力生意经的终局,大概率是更便宜的 AI 服务。
相关推荐

零成本搭建AI超级员工系统:智能体自动工作流全解析
深度拆解B站演示的AI超级员工系统:Agent智能体编排、数字人口播、地图与企业获客、24小时智能客服及法务模块全覆盖。分析零成本开户背后的商业逻辑与合规风险,帮助创业者判断这套AI数字员工系统的真实投产比。

Chatbot与AI Agent的本质区别:从对话到执行的跨越
Chatbot和AI Agent有什么区别?本文基于Learn Tech频道的MCP系列讲解,用订机票、笔记摘要等实例说明:Chatbot只给答案,Agent通过思考-行动-观察循环真正完成任务,并拆解模型、工具、记忆、目标四大部件及MCP的桥梁作用,同时讨论Agent的适用边界与权限风险。

免费GitHub仓库:342小时AI课程,从数学到MCP服务器
一个免费GitHub仓库提供342小时AI课程,包含523节课、20个阶段,覆盖数学基础到Agent构建和MCP服务器。支持目标驱动学习,每节课产出可留存的prompt、skill或agent,已有近10万人开始学习。