DeepSeek开源推理引擎DeepInfer:AI成本战与国运之争

美国禁令公开次日,DeepSeek开源生产级推理引擎DeepInfer,把竞争从模型能力推向成本。
文章讲述2026年10月美国对DeepSeek发布政府系统禁令后,DeepSeek次日即在GitHub开源其生产推理引擎DeepInfer(Apache 2.0)。DeepInfer源自vLLM并融合SGLang、TensorRT-LLM思路,通过前缀缓存、DeepSpark草稿验证、SWA有界重放和CPU-GPU流水调度,将单卡预填充吞吐提升25倍,并使长上下文成本与长度脱钩。它同时把英伟达SM100与华为昇腾950列为一等公民,为全球AI基础设施提供绕开出口管制的第三条道路。但KV缓存、分离部署和跨实例负载均衡仍未开源,且仅支持单一模型、性能均为企业自测,标准之战才刚刚开始。
从禁令到开源:24小时的戏剧性转折
2026年10月19日,美国国土安全部公开了一道命令,要求所有民用联邦机构从信息系统中清除DeepSeek广告的一切产品,以及任何基于DeepSeek技术构建的第三方服务。这道命令早在7月底就已生效,只是到这一天才被摆上台面。
然而,禁令公开的第二天,10月20日中午12点09分,GitHub上出现了一个名为DeepInfer的新仓库,首个提交说明仅有两个词:Initial Commit。这个采用Apache 2.0许可证的项目不是模型,而是推理框架——DeepSeek在线上服务大规模用户时实际使用的引擎。
一道行政命令可以阻断产品进入政府网络,却阻断不了代码的流通。制裁针对的是产品流通,开源释放的是知识流通。前者可以被签字终止,后者一旦发出便再也收不回去。
模型是图纸,推理框架才是产线
要理解这件事的分量,需要先厘清模型与推理框架的关系。模型是图纸,权重是配方,而推理框架是产线。图纸决定你能造什么,产线决定造一件要花多少钱。同一个模型,换一套引擎,单位成本可以差出好几倍。过去三年,开源社区拿到的都是图纸,真正的产线一直锁在机房里。
DeepInfer并非凭空出世。它的LLM类文件头明确标注:“Derived from vLLM, Modified by DeepSeek”。该项目最初构建在vLLM之上,也参考了SGLang和TensorRT-LLM。而FlashMLA、DeepGEMM、DeepEP这些算子库,都是DeepSeek过去两年逐个单独开源的。社区提供了地基,DeepSeek把整栋楼还了回来。
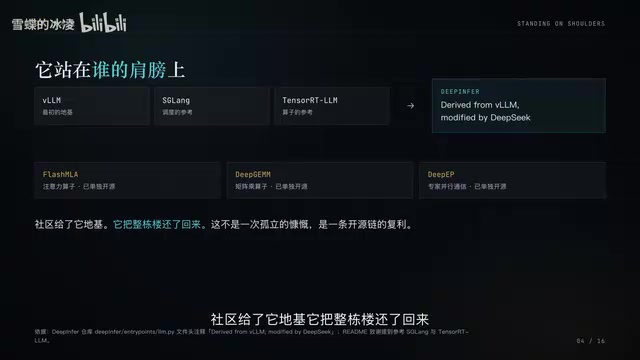
这不是一次孤立的慷慨,而是一条开源链的复利。据官方公布的部署问答,单个集群每天处理155万个Token,低峰时段每张显卡每小时大约产生38美元收入。这是历史上第一次,一家前沿实验室把自己吃饭的家伙完整地拿了出来。
vLLM 是加州大学伯克利分校团队于 2023 年开源的高吞吐 LLM 推理与服务引擎,核心创新是 PagedAttention——把 KV 缓存像操作系统虚拟内存那样分页管理,大幅减少显存碎片,从而显著提升并发吞吐。它迅速成为开源社区部署大模型的事实标准,大量商业服务也基于它二次开发。DeepInfer 标注“Derived from vLLM”,意味着它继承了这套成熟的调度与内存管理骨架,再叠加 DeepSeek 自己的算子与调度优化。理解这一点很重要:DeepSeek 并非从零发明推理引擎,而是站在社区地基上,把生产环境打磨出的改进回馈给社区,这正是文中“开源链的复利”的具体体现。
SGLang 是另一款高性能推理框架,以 RadixAttention 实现高效前缀缓存与结构化生成见长;TensorRT-LLM 则是英伟达官方的推理优化库,深度绑定其 GPU 与编译优化。DeepInfer 参考这三者,说明它吸收了前缀缓存、图编译等主流技术路线,再针对自身流量特征做取舍。
性能跃升:缓存命中与调度优化
DeepInfer解决的核心问题是大模型推理的成本结构。推理分两步:预填充(读取上下文)和解码(逐字生成)。贵的地方在于,很多问题的前半段是相同的。
DeepInfer的做法是把这部分记忆留住。在DeepSeek自身的流量中,96%的输入命中了前缀缓存。结果是单卡预填充吞吐从每秒6万Token跃升至150万Token,提升25倍。
它还优化了两段时间。第一个叫DeepSpark,与北京大学合作开发——让小模型先猜五个词,再由主模型判断哪些值得验证。每个批次需要验证的草稿从5个降到3.2至4.4个,生产环境吞吐提升4%至7%。第二个叫SWA有界重放:原本重建缓存需要重算最后2560个词,现在只重算最后128个。总预填充计算量几乎减半,长上下文的成本与长度脱钩。
第三个问题是一万张卡如何像一个大脑般协同。解码每一步CPU都要排下一批请求,过去GPU只能空等。DeepInfer让CPU在GPU跑当前批次时就排好下一批,默认开启。专家副本每万步重排一次。
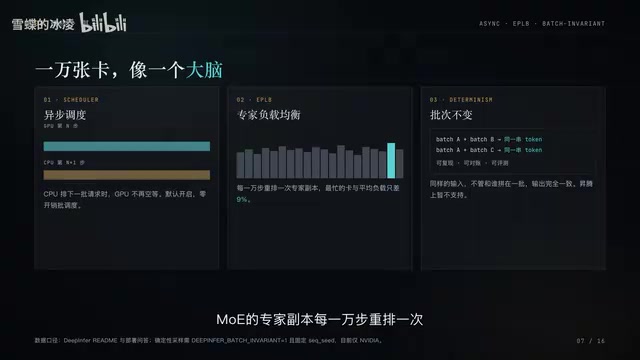
负载最不均衡的卡与平均负载只差9%。更关键的是,同样的输入无论与谁拼在同一批次,输出完全一致——这叫批次不变性,可以复现,也可以对账。
前缀缓存(Prefix Caching) 的原理是:大模型推理时,相同的前文会计算出相同的 Key/Value 向量。如果把多轮对话或系统提示词对应的 KV 缓存保留下来,后续请求只需计算新增部分,省去重复的预填充。DeepSeek 流量中 96% 的输入命中前缀缓存,正是因为大量请求共享系统提示、少样本示例或历史对话。缓存命中率越高,单位 Token 的算力开销越低。配合 KV 缓存的分页与复用,才能把预填充吞吐从每秒 6 万 Token 推到 150 万 Token。这也解释了为何 DeepSeek 把 KV 缓存系统列为未开源的核心组件——缓存命中率直接决定成本,是运营层面的关键资产。
草稿模型(Speculative Decoding) 的思路是:用一个小而快的模型先猜出若干候选词,再由大模型并行验证,接受正确的部分。DeepSpark 在此基础上做改进,减少每批需验证的草稿数量,从而在几乎不损失质量的前提下提升吞吐。
开放的是标准,留下的是运营
DeepInfer并未完全开源。一个完整的推理服务需要三样东西:KV缓存系统、预填充与解码的分离部署、跨实例的负载均衡。这三样此次均未开源。
DeepSeek在部署问答中写明:缓存使用3FS存储,10+2纠删码,约100PiB固态盘;智能体流量保留3天,聊天记录保留7天;高效部署的最小单元是64张卡做预填充、64张卡做解码。这不是给个人开发者的礼物。
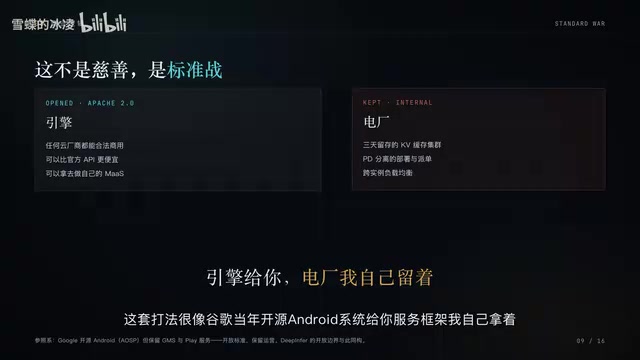
Apache 2.0意味着任何云厂商都可以合法使用这套引擎开展业务,甚至可能比DeepSeek官方还便宜。但真正决定成本的那一半仍留在自家机房。这套打法酷似谷歌当年开源Android——系统给你,服务框架我自己拿着。开放的是标准,留下的是运营。引擎给你,电厂我自己留着。
硬件双轨:英伟达与昇腾并列一等公民
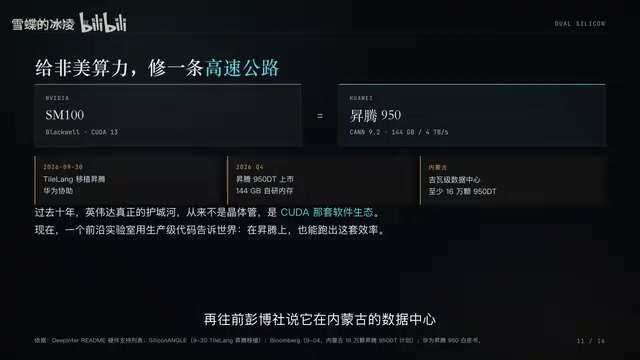
DeepInfer支持两种芯片:英伟达SM100和华为昇腾950,不是顺便兼容,而是并列的一等公民。过去十年,英伟达真正的护城河从来不是晶体管,而是CUDA那套软件生态。现在一个前沿实验室用生产级代码告诉世界,在昇腾上也能跑出这套效率。
往前看,9月30日DeepSeek将TileLang移植到昇腾,与华为团队共同完成。更早之前,彭博社报道其在内蒙古的数据中心将部署至少16万颗昇腾950DT。这条路第一次被公开成了文档。
美国的管制逻辑是:没有先进芯片,就训练不出前沿模型,就服务不了大规模用户。DeepSeek的回答是:用十分之一的算力训出同级模型,把服务成本打到最低,再把方法公开。当效率可以开源,稀缺就不再是护城河。推理成本本质上是电费,而中国的发电量按马斯克的说法可能是美国的三倍。DeepSeek在公告中写的是“降低算力成本,减少能源消耗”,翻译过来便是:把能源优势变成智能供给优势。
CUDA 是英伟达自 2006 年起构建的并行计算平台与编程模型,包含编译器、数学库、调试与性能分析工具,以及庞大的开发者生态。过去十余年,绝大多数深度学习框架和算子都优先适配 CUDA,形成“换芯片就要重写底层”的迁移壁垒。DeepInfer 把华为昇腾 950 与英伟达 SM100 并列为“一等公民”,意味着其算子库、调度逻辑和性能优化在昇腾上同样经过生产级打磨,而非仅做“能跑”的兼容。这需要重写大量底层 Kernel,并借助 TileLang 这类领域专用语言降低跨芯片移植成本。对行业而言,这证明非 CUDA 路线可以承载前沿模型的规模化服务,从而削弱 CUDA 生态的锁定效应。
全球AI主权:第三条道路
这套方案的意义不止于中美。对欧洲、中东、东南亚和全球南方而言,过去要跑前沿模型只有两条路:买美国的云,或买美国的芯片。现在多了第三条:拿开源权重,配开源引擎,装在本国机房,用本国的电。
出口管制的前提是对方必须使用你的基础设施。当模型、引擎、芯片形成闭环,这个前提就被绕开了。AI主权从一句口号变成了可以照着搭的工程方案。
1856年贝塞麦转炉让钢铁价格在20年内跌去大半,钢铁便宜了才有铁路、摩天楼和后来的战争形态。今天被公开的不是一段代码,而是一种工业知识——如何让智能变得便宜。当智能价格跌到电费量级,应用会爆炸,国家间的能力对比也会重排。
冷静看待:尚未胜利的标准战
不宜过度神话。此次DeepInfer仅支持一个模型DeepSeek V4.1 Flash Upper;使用的卡不在支持列表内;确定性采样在昇腾上会直接断言失败;开源版FlashMLA少了一处汇编优化,解码慢5%至10%;所有性能数字均为企业自测,没有第三方实测。
标准还没有赢,它只是刚刚被发到桌上。这件事真正重要的地方不是又一个开源模型,而是开源第一次从能力走到了成本。护城河不是模型,也不是芯片,而是把智能做得便宜的能力。这一次,这种能力被部分公开了。接下来的问题不是谁的模型最强,而是当智能变成电费,谁能用得起,谁会用得最多。
批次不变性(Batch Invariance) 指同一请求无论与哪些其他请求拼在同一批次中处理,输出结果完全一致。在常规推理中,批处理会改变浮点运算的归约顺序,导致输出出现细微差异,给复现和对账带来困难。DeepInfer 声称实现批次不变性,意味着服务方可以稳定复现任何一次输出,便于审计、计费和故障排查。这是企业级部署非常看重的工程属性,也是其调度设计区别于普通开源框架的地方。不过该特性目前仅在企业自测中给出,尚待第三方独立验证。
相关推荐

PPO算法破解移动沙发难题,重建Gerver最优解
开发者利用PPO强化学习算法成功重建移动沙发问题的Gerver最优解,展示了AI在几何优化难题中的潜力。文章详细介绍了问题背景、方法、结果及局限性。

PPO算法破解移动沙发难题,重建经典Gerver沙发
探索PPO算法如何通过强化学习重建移动沙发问题的经典解Gerver沙发,展示AI在几何优化和数学发现中的潜力与局限。

Qwen4-27B 意外曝光:vLLM PR 泄露新模型线索
Reddit 社区发现 vLLM XPU 仓库 PR 疑似泄露 Qwen4-27B 线索,涉及 KV cache 规格与 Intel 平台适配,本文梳理 PR 信息、社区反应及对开发者的参考价值。