DeepSeek联手华为开源AI算力栈:TileLang如何撬动CUDA帝国

DeepSeek联合华为以硬件中立语言TileLang开源AI全栈,剑指英伟达CUDA生态护城河。
DeepSeek与华为联合将基于昇腾算力的AI全栈基础设施开源,核心突破是硬件中立编程语言TileLang——同一份代码既可编译为英伟达PTX指令,也可生成昇腾底层指令,同时将Flash Attention等关键算子的代码量压缩约80%。这一举措的真正意义在于策略转向:此前国产芯片走"CUDA兼容翻译"路线,天然处于追赶状态且性能折损严重;TileLang则绕开CUDA的底层规则,试图从更高抽象层面建立新的行业标准。华为同步开放昇腾底层指令集,DeepSeek开源六大底层套件,双方以"算法团队懂模型、硬件厂商懂芯片"的深度协同填补过去的隔阂。商业逻辑上,这是一次复制Linux开放生态模式的阳谋——用免费工具链聚拢全球开发者,让昇腾硬件和云服务成为最终受益者。能否真正撼动CUDA近20年的生态惯性,仍需时间和第三方实践验证。
一次没有发布会的开源,为何让硅谷紧张
过去24小时,全球AI开发者聚集的GitHub上出现了一个迅速冲上趋势榜的开源项目。没有盛大的发布会,没有黄仁勋标志性的皮衣,只有几行简洁的README和六个底层软件模块的源码文件。中国开源AI团队DeepSeek广告联合华为,宣布将基于国产华为昇腾算力架构的AI算力全栈基础设施面向全球开发者开源。
乍一看,这很容易被当作又一次例行的国产适配宣传。但真正读懂源码的程序员会意识到,这并非简单的生态示好——DeepSeek与华为的目标,直指英伟达耕耘近20年所建立的算力护城河:CUDA生态。
背景数据同样值得关注:此时DeepSeek年化收入据称突破10亿美元,估值向5000亿元人民币方向冲刺,并计划在内蒙古数据中心部署超过16万块华为昇腾AI加速芯片。有模型、有算力、有现金流,却选择把最核心的底层软件免费开放,这背后的逻辑才是真正的看点。
真正的壁垒不是GPU,而是CUDA
长期以来存在一个误区:以为对华芯片限制的最强底牌是那几块高端GPU硬件。但硬件只是冰山一角,水面之下那套捆绑了全球数百万程序员的CUDA软件生态,才是更难撼动的部分。
把时间拨回2004年,斯坦福博士生伊恩·巴克做了一个名为Brook的项目,试图让显卡承担通用并行计算的任务。黄仁勋看中了这个方向,在2006年将巴克招入英伟达,推出了CUDA。
为了推广CUDA,老黄做了一场豪赌:要求英伟达出厂的每张显卡都在硬件层面嵌入CUDA模块,这直接推高了成本、压低了利润,股价一度大跌。从2006到2012年AlexNet引爆深度学习革命之前,英伟达连续多年每年投入数亿美元维护CUDA生态。
关键在于,英伟达在硬件与软件之间自研了一层名为PTX的"黑盒"。全球无数实验室十几年写下的代码全部绑定在CUDA的API之上,这带来一个残酷现实:即便国产芯片硬件性能接近,换掉英伟达也意味着几十万行底层代码要全部重写。
翻译官路线为何注定吃亏
此前国产芯片普遍走"CUDA兼容层"的翻译官路线,把CUDA指令翻译成国产指令。这种打法天然处于下风:你是在英伟达定义的规则里作战,对方只要更新底层映射,你的翻译器就可能瘫痪,硬件性能还要白白折损30%到50%。只要还顺着CUDA的逻辑走,就永远是带着枷锁的追赶者。
CUDA(Compute Unified Device Architecture,统一计算设备架构)本质上是一套让开发者将GPU当作通用并行计算处理器使用的编程模型,包含编译器、运行时库、数学加速库(如cuDNN、cuBLAS)等数十个组件。PTX(Parallel Thread Execution)则是英伟达设计的一种虚拟指令集架构,充当高级代码与实际GPU硬件指令之间的中间层。这个设计极具战略价值:英伟达可以在不破坏既有代码兼容性的前提下迭代硬件微架构,同时对竞争对手完全封闭PTX到实际硅片的映射关系。经过近20年积累,CUDA生态已涵盖深度学习框架(PyTorch、TensorFlow)、科学计算、图形渲染、量化金融等几乎所有高性能计算领域,全球活跃CUDA开发者估计超过400万,这种锁定效应远非单纯的硬件性能差距可比。
TileLang:从底层撕咬转向升维换轨
面对这座高墙,DeepSeek与华为选择不在CUDA底层API里纠缠,而是"升维换轨"。突破口叫TileLang——一个最初由北京大学计算机学院团队领衔、DeepSeek与华为深度参与的开源编程语言。
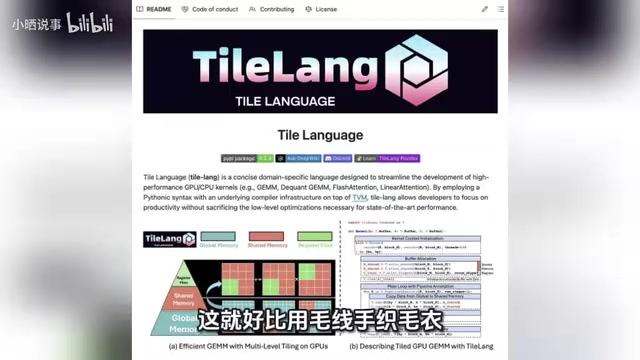
它做的事情可以用一个比喻理解:传统CUDA编程像手工织毛衣,程序员要手写几百行极致复杂的底层代码,精准控制每个线程去显存的哪个地址取数据,错一处整个程序就崩溃。而TileLang让程序员用接近数学公式的Python风格声明计算意图,线程调度、显存映射全部交给编译器处理。
效果相当直观:代码量下降约80%。过去在CUDA C++底层需要手写500多行的Flash Attention关键算子,在TileLang里据称只需约80行即可完成,且运行效率逼近硬件物理极限。
更关键的是它的硬件中立性——同一份TileLang代码,编译器既能生成英伟达的PTX指令,也能直接生成华为昇腾的底层指令。程序员不必为换芯片重学一门语言,这实际上削弱了CUDA作为迁移壁垒的作用。
Flash Attention是理解TileLang价值的关键参照系。它由斯坦福博士生Tri Dao于2022年提出,通过精细控制GPU高速片上内存(SRAM)与低速显存(HBM)之间的数据搬运顺序,将Transformer注意力机制的显存占用从O(N²)降至线性,同时大幅提升实际运算速度。其CUDA实现之所以需要数百行高度优化的底层代码,正是因为要在寄存器、共享内存、L2缓存之间手动编排数据流。这类"算子"(Kernel)是大模型训练与推理的性能瓶颈核心,也是各家算力平台兼容性的最高门槛——任何一款芯片若无法高效运行Flash Attention,在LLM场景下几乎没有实用价值。TileLang将此类算子的编写门槛大幅拉低,意味着更多研究团队能为非英伟达平台贡献高质量实现。
软硬协同:一整套开源"军火库"
如果说TileLang是斩断锁链的利刃,那么这次释放的则是一整套配套工具。以往芯片厂商不清楚大模型需要什么算子,大模型团队也不懂芯片寄存器如何调度,双方像隔空打靶。这一次,算法实验室与硬件巨头做了一次深度协同。
华为方面开放了昇腾芯片最底层的指令集与接口,相当于把部分底层技术细节公开;DeepSeek方面则将研发V4系列大模型时打磨出的六大底层套件全部开源,包括分布式通信库、显存管理、Flash MLA等,并用TileLang重写优化。
在性能层面,双方基于昇腾硬件打通了128卡单层交换的网络拓扑,并称可扩展至更大规模集群。素材中提到,在特定部署策略下,针对DeepSeek V4.1 Flash模型,当单Token延迟控制在约10毫秒时,单卡输出吞吐量可达数千Token/秒级别。内蒙古规划的16万块昇腾芯片集群,正是这套全栈基础设施的实战检验场。
说明:上述性能数字来自单一视频来源的转述,存在语音识别误差,具体指标需以官方开源文档为准。
阳谋逻辑:AI算力界的"Linux时刻"
一个自然的疑问是:DeepSeek靠API一年据称能赚10亿美元,华为卖芯片也是大生意,为何要把耗费心血的底层软件免费开源?
答案接近开源世界反复上演的逻辑——用开放生态对抗封闭生态。正如当年Linux以免费开放蚕食服务器市场,这套策略的核心不是靠软件本身盈利,而是通过降低迁移门槛、聚拢全球开发者,让国产算力栈成为一个值得投入的平台。当生态足够大,硬件销售、云服务、模型API等环节自然获益。
对开发者而言,真正的价值在于"可选项"的出现:过去绑定CUDA几乎是唯一选择,如果一套硬件中立、代码量更少的工具链能稳定可用,迁移成本将显著下降。这是否能真正撼动CUDA的地位,仍取决于生态成熟度、工具稳定性与真实场景下的性能表现,需要时间与更多第三方验证。
Linux的历史提供了一个有力的先例:1991年Linus Torvalds以免费开源的方式发布Linux内核,彼时商业Unix系统拥有成熟生态与企业客户基础,局面看似无法撼动。然而到2010年代,Linux已主导服务器、超算、移动端(Android)等几乎所有计算场景,而受益最大的反而是Red Hat、IBM、谷歌、亚马逊等围绕Linux构建商业服务的公司。这一模式的关键机制在于:开源降低了个人开发者的试用成本,大量贡献者反过来加速了生态成熟,形成正反馈循环。DeepSeek与华为的开源逻辑与此高度一致——昇腾硬件和云服务才是最终的商业变现点,软件栈开源是获取全球开发者信任与贡献的入场券。当然,Linux的成功历经约十年才形成规模效应,硬件中立工具链能否复制这一路径,在AI算力格局快速演变的背景下仍存在较大不确定性。
结语
这次开源能否如视频所言"暴击英伟达",现在下定论为时过早。CUDA近20年积累的生态惯性极强,单靠一门语言和一套套件难以在短期内翻盘。但方向本身值得关注:从"翻译兼容"转向"升维换轨",从硬件追赶转向软件生态开放,这代表国产算力竞争思路的一次切换。对全球开发者来说,多一个开放、硬件中立的选择,本身就是有意义的进展。
相关推荐

Harness架构实战:企业级智能体项目拆解与AI岗位进阶指南
深度拆解基于Harness(驾驭工程)架构的企业级智能体实战项目,涵盖多模型配置、ASGI部署、MCP协议对接ERP系统、Sandbox沙箱隔离等核心模块,帮助AI大模型求职者理解工程化落地方向的面试要点。

fal.ai API密钥配置与n8n集成完整教程
手把手教你创建 fal.ai API 密钥并连接到 n8n:涵盖官方集成节点配置、凭证保存、HTTP 请求替代方案以及密钥安全注意事项,快速跑通首次 AI 媒体生成工作流。

系统设计面试笔记开源项目:2.4万星的学习利器
开源项目 liquidslr/system-design-notes 整理了经典书籍《System Design Interview》的学习笔记,GitHub 收获 2.4 万 Star。本文解析其内容价值、适用人群及系统设计面试复习建议。