DeepSeek如何把AI推理账单砍到1/150:四步压缩KV缓存
DeepSeek新模型通过四步架构重构将缓存成本压缩437倍,以极低定价挑战编程Agent场景的主流大模型
本文拆解了DeepSeek最新模型如何将编程Agent场景中最贵的开销——重复读取上下文缓存——的单价压到近乎归零。核心是四步架构创新:将40层网络劈成编码器/解码器两半,让读取prompt的计算量减半;同时从缓存条目大小、序列长度、保留层数三个维度联合压缩,使每token显存占用从389,000字节降至890字节;再引入分层收敛的索引器控制哪些键被读取;最后将近200GB的n-gram查找表搬离GPU放入系统内存。四步机制均为近似,DeepSeek官方坦承存在边界退化风险。最终结论是:该模型在成本上具有压倒性优势(同等任务可节省约97%费用),但在科学类硬问题上落后闭源前沿模型约20分,适合上下文密集的Agentic工作流,不适合替代专家级推理场景。
运行一个编程Agent时,账单里最贵的往往不是它写出来的代码,而是每一轮对话都被重复发送的上下文。你在为「重读自己已经发过的内容」付费。在美国主流大模型上核算,这一项开销大约占到总费用的三分之二。而DeepSeek最新发布的模型,把这项开销的单价压到了每百万token仅三毫美分(0.003美分)。
这不是打折促销,而是他们重构了注意力机制,直到这项开销几乎消失。本文将拆解海外博主的技术分析,看清DeepSeek用四步做到这件事的完整路径,以及它在哪里会出问题。
一个437倍的数字
所有变化都围绕一个指标:每个上下文token在显存里占用的字节数。
在DeepSeek的第一代模型上,一个token要占用389,000字节;而本月发布的新模型,同样一个token只占890字节。同一家公司,跨越四代架构,缩小了437倍。
更反直觉的是:新模型的参数量几乎是它所复现能力的旧模型的两倍。更大、更便宜、更快、更强——按常理这四项里总要牺牲一项,但它似乎全占了。这款552亿(原文表述为552 billion)参数级别的模型,权重公开、采用MIT许可证发布。
从基准测试看,它在Agentic编程任务上与Claude Opus级别持平,但在最难的终端类基准上落后约20分。真正的看点不在跑分,而在账单。
账单里的钱都花在哪
一位开发者晒出了自己单次长时间编程任务的token日志:中等规模代码库,447轮对话。整个过程中,Agent只发送了约100万token的新鲜输入,却从缓存里读回了约3650万token——同一份上下文,一轮又一轮地返回,重复了36次。
按GPT级别模型定价,这个会话约收费55美元,其中三分之二是缓存读取那一行。把同样的日志跑在DeepSeek新模型上,只收费36美分。差距一目了然。
模型读你的prompt时,保留的不是词本身,而是每一层对每个词的「理解」,这就是键值缓存(KV Cache)。可以把它想象成桌上的笔记,让你不必反复重读整本书。笔记占空间,也需要计算来写。所以「读prompt」这一项开销里,藏着两笔成本:读取和存储。DeepSeek同时对这两者下了手。
键值缓存(KV Cache)的工作原理值得稍作展开。Transformer模型在处理每个token时,会为每一层计算出一组「键」(Key)和「值」(Value)向量,这些向量编码了该token在当前层的语义信息。当模型需要生成下一个token时,必须用新token的「查询」(Query)向量,去和序列中所有历史token的键向量做相似度计算,再加权读取对应的值。如果每次生成都重新计算所有历史token的键值,计算量会随上下文长度平方级增长。KV Cache的作用就是把已经算好的键值存在显存里,下次直接读取,省去重复计算。代价是显存占用随对话长度线性增长——在一个拥有数十层、每层都有完整键值矩阵的大模型里,几十万token的上下文可以轻松占满一张高端GPU的全部显存。这正是DeepSeek四步压缩策略要攻克的核心瓶颈。
第一步:把网络劈成两半
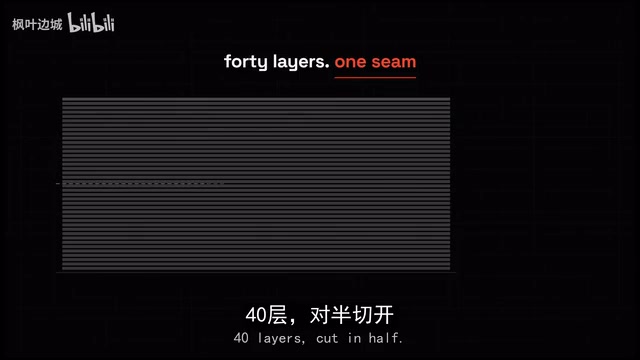
40层网络被从中间切开。底部20层是编码器(encoder),顶部20层是解码器(decoder),中间只有一道接缝。
当prompt到达时,只有编码器的20层会真正跑遍全部内容。解码器的顶部20层根本不读你的prompt——它们的全局键值不是从各自的隐藏状态计算,而是从编码器最终隐藏状态,通过每层一个独立权重矩阵一次性投影出来。一趟计算,20份副本,不做二次读取。
结果就是:读一个prompt的成本,从「跑一整个网络」降到「跑半个网络」。报告将prefill复杂度写作 n×L/2,称其「近乎减半」。
生成token则是另一回事——每个生成的token必须真实穿过全部40层,所以decode激活160亿参数,而prefill只激活80亿。每层还保留自己128 token宽的滑动窗口,配合「有界重放」(bounded replay)机制,只重放最后一个窗口并近似重建,避免了成千上万token的重复计算。
「编码器-解码器」划分在这里的含义与经典Transformer(如BERT是纯编码器、GPT是纯解码器)略有不同,需要澄清。DeepSeek这里的「编码器」指网络底部专门负责理解输入(prefill阶段)的层,「解码器」指顶部负责逐token生成(decode阶段)的层——这是一种混合架构,而非两个独立模型的拼接。Prefill阶段指模型一次性读取整个输入prompt并建立初始表示,通常可以并行计算;decode阶段则是逐步生成每个输出token,必须串行进行。两个阶段的计算特性截然不同:prefill是计算密集型(一次处理大量token),decode是访存密集型(每步只产出一个token但要访问全部历史缓存)。将网络在这两个阶段上差异化处理,正是「劈成两半」能降低prefill成本而不影响decode质量的根本原因。
第二步:从三个维度压缩缓存
缓存能缩小的地方只有三处,报告全部点到了:单条目的大小、序列方向上条目的数量、以及保留缓存的层数。以往每个技术都只挑其中一个下手,这次三个一起动,效果相乘。
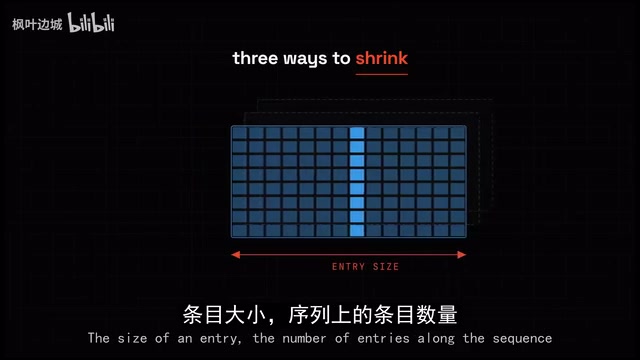
条目大小先减:64个查询头共享一个latent,整层只有一个键值头。序列维度其次:编码器里每两个相邻token压缩成一个缓存条目,数量减半——因为代码库转储里,相邻token本就不独立。
最重的活在层数维度:跑遍发布的配置会发现,40层里只有4层真正保留缓存,其余36层什么都不存。这不是论文里的说法,而是他们代码中注意力类的注释里写明的。其余36层各自获得一种「借用模式」:重索引层用自己的查询给共享键重新打分并编成新的候选清单;复用层甚至连打分都省了,直接沿用上一层的清单。两种模式都不写一个字节缓存。
最后是精度:存活的缓存以4比特存储,每16个通道共用一个8比特scale,在旋转位置编码之后量化,相比上代再砍一半。四项叠加,就得到那个标志性数字——每token 890字节。
第三步:谁来决定读哪些键
只有4层保留全部键,其余36层读别人的笔记——这就带来一个关键问题:必须有个机制来挑选每个查询实际读取哪些条目,否则这个模型在长上下文上会比跑分显示的差得多。
这个活交给一个32头的小型旁路注意力,DeepSeek称之为「索引器」(indexer),它给候选打分并保留前512个。但它也制造了新瓶颈:给每个可见条目打分,成本随上下文长度线性增长,而且每个索引层都要重来一次。
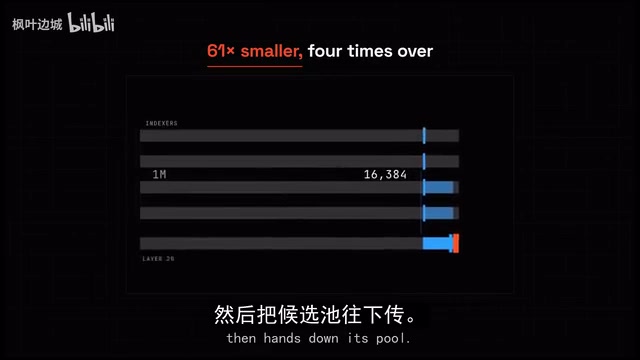
解决方案是分层收敛:解码器第一个full模式层(第20层)扫描全部可见上下文一次,再以8个位置为一块做第二遍,保留每块最大值,最终保留前2048块——约1.6万个候选位置,然后把这个池子往上传。此后每个更深的索引层只在这1.6万里打分,而不是百万,成本随深度趋于恒定。
代价也很明确:这个池子是「第20层的一家之言」。如果某个更深层需要的条目没进第20层的候选块,它下面的层就再也拿不回来了。瓶颈是被移动了,而不是消失了。
第四步:把记忆搬下显卡
还有一个模块被搬走了。第1层和第14层坐着两个模块,它们根本不是矩阵乘法,而是查找表,DeepSeek称之为n-gram。
模型对每个token的前2、前3、前4个token分别哈希,每种走8个哈希头,24个哈希各索引约1600万行的表,表的大小取不同质数以避免碰撞对齐。所有这些表加起来达1960亿参数,超过模型权重的三分之一,却没有一个在做乘法。每个token只触碰其中24行,所以参数规模巨大而单token的工作量只是一次查表。
由于寻址是确定性的,这些表根本不必放在显卡上——它们住在主机内存里,后台传输预取即将用到的行。约200GB的表存于普通系统内存,显卡只放主干网络。这不是孤例:八月底阿里巴巴发布的一款Qwen Flash模型,也把510亿n-gram参数放进系统内存运行。两家实验室,相隔数周,做了同样的动作。
n-gram查找表在语言模型中扮演的角色类似于「硬编码的局部统计记忆」。经典n-gram模型统计文本中连续n个词共同出现的频率,用于预测下一个词——这是深度学习兴起前主流的语言建模方法。DeepSeek这里的做法是将n-gram信息以哈希索引表的形式嵌入神经网络,让模型可以直接查询局部词序模式,而无需通过注意力机制从上下文中「重新发现」这些统计规律。这种设计的优势在于:查表操作不涉及矩阵乘法,计算开销极低;表的寻址完全确定,可以在CPU侧预取,天然适合放在系统内存而非GPU显存。代价是表本身体积庞大(近200GB),且只能捕捉局部短程依赖,无法替代注意力机制对长距离语义关联的建模能力。
真实的边界与代价
这四个机制,每一个都是近似:半个网络读prompt、有界重放近似重建窗口、大多数层借用未经自己打分的键、索引器丢掉大部分上下文。DeepSeek自己的局限性章节点名了两种失效模式——稀疏注意力,以及有界重放中的近似状态重建,用他们的话说「在未测试的边界情况下仍可能导致能力退化」。部署章节更直白:重放的前缀状态是近似的,所以相同的prompt、不同的缓存命中位置,会得出略微不同的结果。这是他们自己写的句子,不是批评者的。
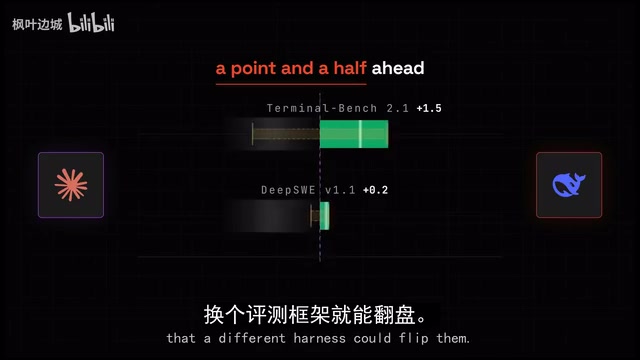
跑分层面,胜利真实但狭窄。在软件工程基准上它以0.2分领先,在某终端基准以1.5分领先——窄到换个测试框架就可能翻转。但在另一方向差距巨大:某终端基准落后20分,人类最后考试落后19.5分。DeepSeek坦承「平均分持平不代表匹配了闭源前沿系统的能力」。此外它输出「非常啰嗦」,速度约每秒200 token,写出的内容近乎中位模型的两倍。
结论:胜在成本,弱在专家能力
把权衡说清楚:这个模型赢下了「用钱买的能力」,输掉了「靠专家知识的能力」。如果你的Agent整天重读长上下文,它是不二之选,而且优势巨大——在开头那个工作负载上,它以76倍的成本差距拿下相近成绩。如果你的难题是科学形态的硬问题,就该付钱给Anthropic。
最有说服力的证据,是DeepSeek自己的动作:它把旗舰路由切进了廉价档、按廉价档定价,并让旗舰逐步退役。一个愿意用便宜模型取代自家旗舰的实验室,是真的相信这个便宜模型。而权重在Hugging Face上以MIT许可证公开,需要冻结模型的团队可以自由部署——这是任何闭源端点用户都没有的选择。
博主留下一个可证伪的判断:DeepSeek称更大版本的该架构即将到来,他预测它不会补上那20分的终端基准差距。真正悬而未决的问题是——注意力里还藏着第五重压缩,还是下一次突破必须来自注意力之外?
MIT许可证在AI模型发布语境中意味着权重可以被自由商用、修改和再发布,无需向原作者支付版权费,也不要求衍生产品开源——这与Apache 2.0许可相近,但比GPL宽松得多。对需要在生产环境中冻结模型版本的团队而言,这一点尤为关键:闭源API端点随时可能被服务商单方面升级或下线,而持有MIT权重的团队可以在自有基础设施上永久运行特定版本,不受供应商路线图约束。这也是「权重公开」与「能力公开」之间的本质区别——前者给予的是部署主权,后者仅提供技术透明度。
相关推荐

微软官宣10月7日Windows与Surface发布会:本地AI成主角
微软宣布将于10月7日在旧金山举办Windows与Surface发布会,时隔两年再度重磅亮相,核心议题聚焦本地AI如何塑造Windows的未来,或深化AI PC产品形态。

Meta 推出 WhatsApp Business MCP 服务器,让 AI 代理接管繁琐配置
Meta 推出全新 WhatsApp Business MCP 服务器,让开发者可借助 Claude、Cursor、Codex、ChatGPT 等 AI 编程代理自动处理平台配置、消息模板、测试与故障排查,大幅降低接入门槛。

Claude Code v2.1.273更新详解:修复权限漏洞与远程控制增强
Claude Code v2.1.273 版本更新详解,涵盖权限检查安全修复、远程控制会话分叉、MCP 重连、错误提示优化及 Slack 集成与代码审查改进,帮助开发者了解升级要点。