#注意力机制
共 20 篇相关文章

偏见头测量的是什么?头部归因的不可识别性
审计研究发现,大语言模型头部偏见归因方法存在不可识别性:头图与响应长度强相关,固定提示词下标签、长度与受保护群体标记共线,观察性分析无法归因,且消融头集合并未降低不公平率。

LLM内部如何编码目标?新研究揭示稀疏注意力头机制
新研究定位LLM中编码下一子目标的稀疏注意力头,验证其因果性与跨环境可塑性,并提出非循环目标寻求(NRGS)假说解释目标持续性。
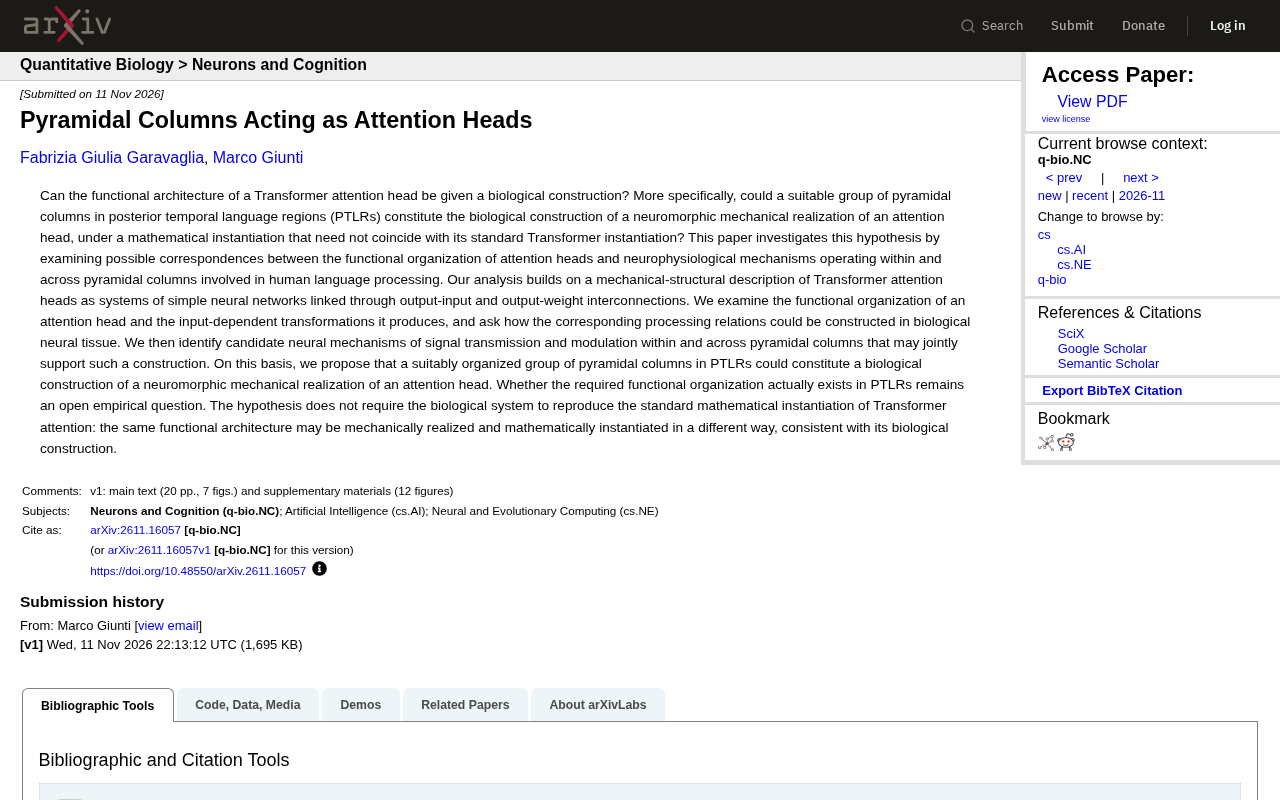
锥体柱能否充当注意力头?大脑与Transformer的跨界对话
论文探讨后颞叶语言区锥体柱能否作为Transformer注意力头的生物学实现,区分功能架构的机械实现与数学实例化,提出以锥体柱组织支撑注意力计算的新假设,并指出其仍属开放经验问题,对神经形态计算具有启示。

长上下文失效真相:干扰竞争比长度更致命
新研究发现长上下文检索失败主因是干扰项竞争而非长度。中性填充下准确率保持0.97以上,同格式竞争陈述可致损失扩大百倍,注意力质量解释58%方差。

圆锥规划为Transformer注意力提供严格认证
圆锥规划理论为Transformer注意力认证提供紧致性保证:证明困难源于查询与键的双线性交互而非softmax,指数锥矩松弛达到二阶最优紧致度,GPT-2实验验证其优于线性界传播。
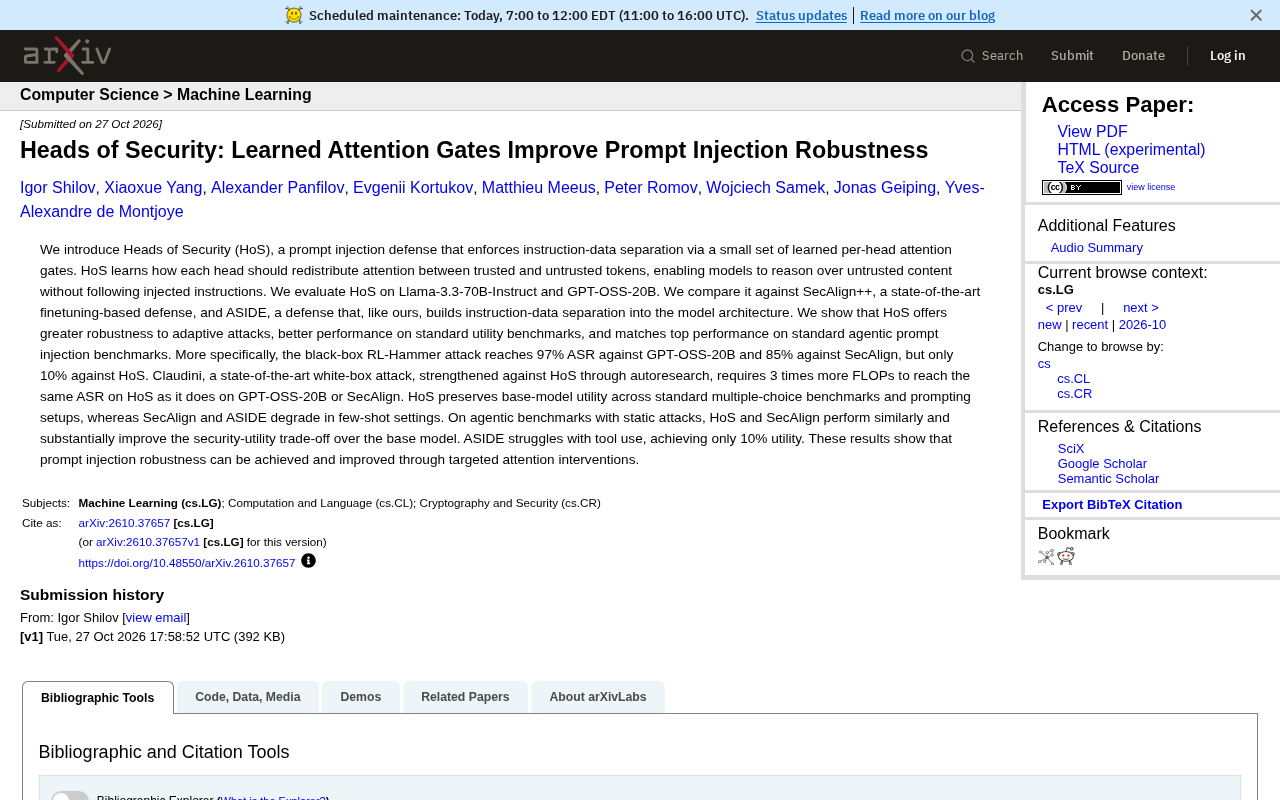
注意力门控新防御:HoS如何让提示注入攻击失手
Heads of Security (HoS) 提出可学习的逐头注意力门控防御提示注入,在 Llama-3.3-70B 和 GPT-OSS-20B 上显著降低攻击成功率,同时保持模型实用性。

高效边感知注意力网络:图生成模型的显存优化新方案
图生成模型常受限于图专用Transformer的显存和效率瓶颈。本文介绍一种高效边感知注意力网络,通过头级分数调制和轻量残差机制,借助PyTorch FlexAttention实现,在保持生成质量的同时将峰值GPU显存降低约65%,并显著提升训练与采样吞吐量。

桥栏阴影与LLM:用几何原理解释语言模型
从桥栏阴影的日常观察出发,结合Breeden论文《The Simple Mathematics of Large Language Models》,用几何投影原理解释LLM的Token嵌入、注意力机制与上下文相关表示,并探讨跨语言概念解耦差异。

从零推导Transformer:你也能凭记忆发明它
从RNN瓶颈到注意力机制,本文拆解Transformer的推导逻辑,说明为什么你可以凭记忆重新发明这一架构,并给出可复现的组件积木。

区域感知SE模块:突破图像分割的通道注意力瓶颈
论文提出区域感知SE模块,用空间引导池化替代全局平均池化,通过BASE、SPASE、MAPSE、PLEASE四种方案在图像分割任务上超越传统SE模块,兼顾计算效率与可解释性。

注意力机制的统计力学:从Hopfield模型看Transformer推理相变
研究通过现代Hopfield模型为Transformer注意力机制构建统计力学框架,揭示自由能景观中玻璃态与鲁棒推理态之间的一阶相变,并扩展至随机查询与键的注意力分析。

ILRN:无注意力循环网络用逆延迟记忆对标Transformer
ILRN是一种无注意力的循环神经网络,核心机制为逆延迟记忆(ILRM),在96和256上下文长度下与Transformer对比取得更高准确率。本文解析其架构设计、实验结果与局限性。
稀疏注意力:长上下文LLM降本之道与遗漏之殇
稀疏注意力通过全到达、滑动窗口和学习型选择器降低长上下文LLM成本,但同一提示词在不同策略下形成不同证据集。本文分析三种方案的降本逻辑、跨段落推理遗漏风险及实践权衡建议。

18B激活仅0.045美元:GLM-5.3-Flash如何靠混合注意力击败Claude
Z.ai GLM-5.3-Flash以320B总参数、18B激活、每任务0.045美元的成本在AutomationBench上以48.8分击败Claude Opus 4.8。本文解析其稀疏加线性混合注意力架构、3倍注意力计算节省与4.4倍KV缓存缩减,以及它在视觉、开源权重和基准可靠性上的真实短板。

用量子玻恩规则替代Softmax注意力:一次大胆的架构实验
一位Reddit开发者用量子玻恩规则|⟨Q,K⟩|²替代了Transformer中的Softmax注意力机制,并成功完成训练。本文解析这一激进架构实验的技术逻辑、潜在价值与局限。

Softmax注意力如何学会决策阈值:一项理论动力学研究
解析arXiv最新研究:双参数softmax注意力模型如何通过梯度预训练学习决策阈值。文章深入剖析误差分解、协调参数发散机制及单头模型局限,为理解Transformer注意力的学习动力学提供理论视角。
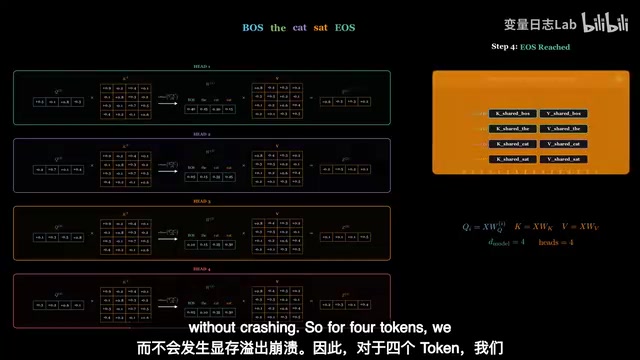
MQA与GQA详解:KV Cache如何降低大模型推理显存
深入解析 MQA 与 GQA 两种大模型推理优化技术:KV Cache 如何膨胀、MQA 如何通过共享键值削减 75% 显存、GQA 如何用组数 G 在速度与质量间取得平衡,以及它为何成为 LLaMA、Mistral 等主流模型的默认选择。
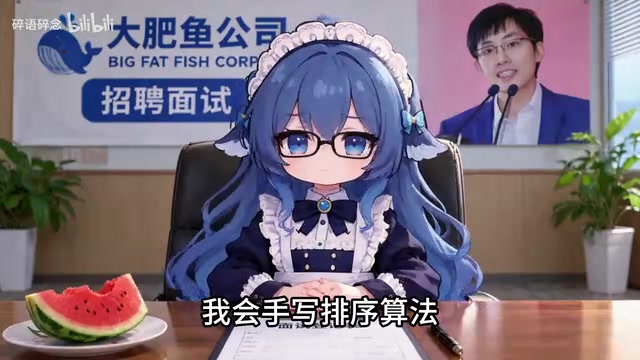
从「大肥鱼面试」段子看大模型的能力边界
B站「大肥鱼给用户做面试」段子以拟人化AI「豆宝」的形式,调侃大模型答案不稳定、拟人化命名等特征,并通俗解释了Transformer核心的注意力机制。本文借梗解析大模型能力边界与AI娱乐化传播的两面性。

