DeepSeek搜索收费调整与谷歌Gemini新模型发布
DeepSeek搜索计费改为按Token计,谷歌发新模型,OpenAI与阿里云披露新进展。
本期科技资讯聚焦计费、模型与基础设施三条线。DeepSeek 调整工具调用收费:模型自动触发的网页搜索和读取不再按次计费,检索内容进入上下文后统一按 Token 用量付费,自 18 日中午生效;独立搜索或抓取接口仍按每 1000 次成功请求 5 元计费,高频使用搜索增强的开发者需重新估算成本。谷歌发布面向复杂编程和长任务的新模型,支持 100 万 Token 上下文,API 输入每百万 Token 3 美元、输出 15 美元,并向 Ultra 用户开放可交互世界的 Project Genie。OpenAI 披露 AI 辅助芯片设计使部分单元面积缩小约 13%、综合指标最高改善 14%,并在安全说明中将 GPT 6.1 系列列为暂缓推出。阿里云 AI 云和算力服务收入超 600 亿元、同比增长 53%,Anthropic 将 IPO 定价为每股 83 美元、合计约 813 亿美元,预计 11 月 19 日登陆纳斯达克。
DeepSeek调整搜索工具调用计费,开发者账单结构变化
据B站视频资讯,DeepSeek广告 对模型侧的工具调用收费规则做出调整:当模型自行触发网页搜索和读取网页时,不再按调用次数计费,检索内容会进入上下文,统一按模型的 Token 用量付费。新规则自 18 日中午生效。
如果开发者直接调用独立的搜索或抓取接口,两项服务各按每 1000 次成功请求 5 元计费。这一变化意味着,通过模型自动触发的搜索行为,成本会被折算进 Token 消耗中,计费方式从“按次”转向“按量”。
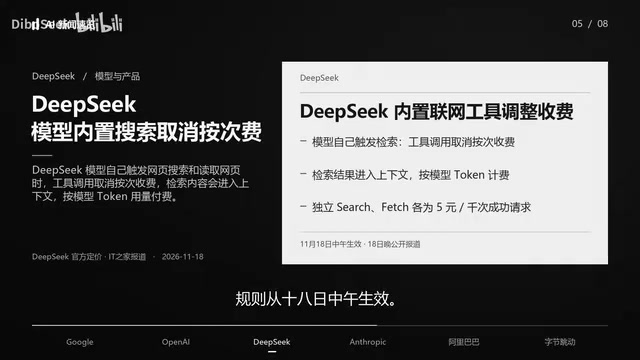
对高频使用搜索增强的开发者来说,需要重新估算调用成本。将搜索能力内嵌到模型上下文中,也让费用结构更贴近实际生成内容的规模,而非简单的请求次数。
什么是“模型侧工具调用”
Tool Calling(工具调用)指模型在推理过程中主动调用外部函数或服务(如网页搜索、代码执行、数据库查询)来获取信息,再把结果返回给模型继续生成。与开发者手动编排“先搜再问”不同,模型侧工具调用由模型自行判断何时调用、调用几次。
在按次计费模式下,每次触发搜索都产生一笔固定费用,与模型实际处理多少内容无关;改为按 Token 计费后,检索到的网页正文会作为上下文送入模型,其长度直接决定成本。因此单次搜索如果抓取到长网页,费用可能高于按次计费;反之,短检索则更便宜。开发者可通过限制返回条数、精简网页正文、设置上下文截断来控费。
谷歌发布新模型,主打复杂编程与长任务
谷歌推出了代号 Gemini Smear(音译)的新模型,重点面向复杂编程和长任务场景。官方演示中,该模型被用于构建一个网页滑雪模拟器,能够在真实山地地形上滑行不同路线。
模型支持 100 万 Token 的上下文窗口,API 定价为每百万 Token 输入 3 美元、输出 15 美元。目前 AI Studio 已开始开放,Gemini 应用也向 Pro 和 Ultra 用户推送。
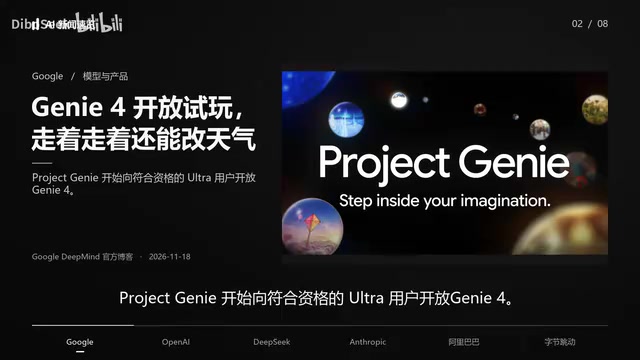
谷歌的另一项更新更像是在试玩新游戏:Project Genie 开始向符合资格的 Ultra 用户开放。借助 Gemini 4,用户可以走进一个可交互的世界,一边逛一边打字修改天气、添加角色,环境声和对话也会随场景变化。用户还能浏览社区画廊,查看其他人的创作。Pro 用户可以先加入后补名单。
上下文窗口与长任务编程
上下文窗口指模型单次请求能“看到”的 Token 总量,包括输入提示、历史对话、工具返回内容和模型输出。100 万 Token 大约相当于数十万汉字或一个中型代码仓库的规模,使模型能在一次会话中读取多个源文件、保持长链路推理,这正是“长任务”场景的基础。
但长上下文并不等于免费:输入 Token 按量计费,且上下文越长,单次请求成本越高。实际工程中通常配合上下文缓存(cache)和分段摘要来降低成本。此外,长上下文还存在“中间信息丢失”问题,即模型对位于上下文中段的内容召回较弱,因此关键指令最好放在开头或结尾。
OpenAI用AI辅助芯片设计,部分模块指标改善
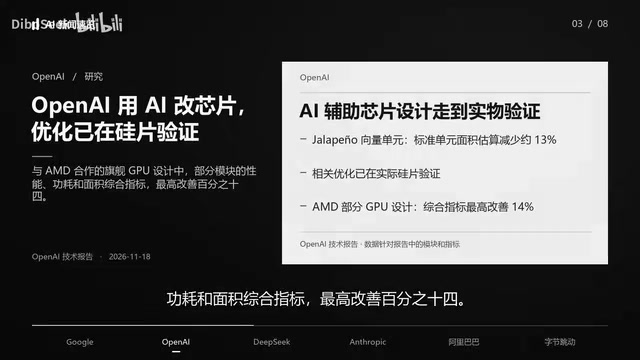
OpenAI 披露了用人工智能辅助工程师改进芯片设计的进展。团队估算,自研推理芯片的向量计算单元和标准单元面积缩小了约 13%,相关改动已在实际硅片上验证。
在与 IMD 合作的旗舰 GPU 设计中,部分模块的性能、功耗和面积综合指标最高改善 14%。这意味着 AI 正从软件层面向硬件设计环节渗透,帮助工程师在芯片布局和单元级优化上获得收益。
PPA 与标准单元、向量计算单元
芯片设计中的核心评价指标是 PPA,即性能(Performance)、功耗(Power)、面积(Area)。三者相互制约,优化其中一项往往牺牲另一项,因此常用综合指标衡量改进幅度,文中“综合指标最高改善 14%”即指 PPA 的加权结果。
标准单元是芯片设计的基础积木,如与门、触发器,其面积直接决定芯片整体尺寸和成本。向量计算单元(Vector Unit)负责并行处理多组数据,是 AI 推理芯片的关键模块,其面积和能效直接影响矩阵运算吞吐。用 AI 辅助单元级布局与尺寸优化,可在不改变架构的前提下压缩面积、降低功耗,这也是该进展被视为 AI 向硬件设计渗透的原因。
OpenAI安全说明披露暂缓模型,GPT 6.2引发讨论
视频提到,此前有 GPT 6.2 的讨论,也有人好奇更早的 6.1 Soul、6.1 Astra 去向。OpenAI 在新发布的安全说明中,将这些模型列为“曾经暂缓推出”的模型,理由是公司需要更多时间达到自身的安全标准。
说明还介绍了从训练到部署过程中,如何监控模型行为和限制其操作权限。这反映出头部模型厂商在发布节奏与安全评估之间持续权衡。
阿里云与算力服务收入增长,Anthropic推进IPO
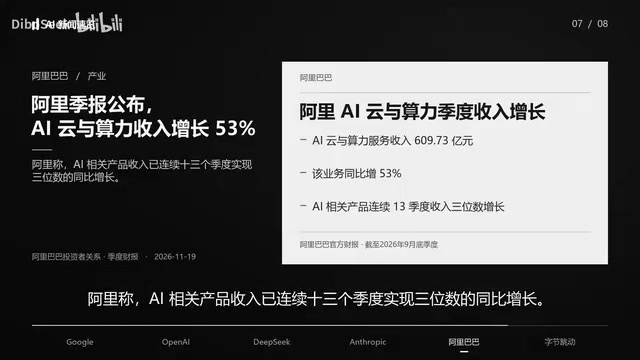
阿里巴巴公布截至 9 月底的季度业绩,AI 云和算力服务收入超过 600 亿元,同比增长 53%。阿里称,AI 相关产品收入已连续 13 个季度实现三位数同比增长。此次云和算力业务口径包括阿里云广告和平头哥。
Anthropic 将首次公开发行价定为每股 83 美元,共计 9.8 亿股,合计约 813 亿美元,其中包含老股东出售的股份。按公告,股票预计在美国当地 11 月 19 日开始在纳斯达克交易,代码为 ANT。采集时市场尚未到挂牌交易时间。
IPO 定价与“老股东出售股份”
IPO 发行价是公司与承销商根据机构认购需求确定的每股价格,乘以发行总股数即募资规模。文中 813 亿美元包含老股东出售的股份,意味着部分募集资金流向现有投资人套现,而非全部进入公司账户,这部分通常称为老股转让(secondary offering)。
上市首日交易价常与发行价出现偏离,发行价更多反映一级市场对估值的共识。对 AI 公司而言,IPO 也意味着财务披露义务增加,收入结构、算力采购成本和亏损情况将更透明,成为观察行业景气度的公开指标。
字节跳动与微软洽谈Azure采购
据 The Information 援引知情人士报道,字节跳动正与微软洽谈追加约 5 亿美元的 Azure 云服务采购,主要用于调用 OpenAI 的模型。路透随后报道,美国众议院一个委员会已要求微软就金额和用途做出说明。目前交易结果仍待确认,以上来自媒体报道。
编辑观察
这一轮信息集中在计费规则、模型能力与基础设施三个层面。DeepSeek 把搜索调用纳入 Token 计费,表明模型厂商在探索更贴近实际消耗的定价方式;谷歌新模型以长上下文和复杂任务为卖点,同时用 Project Genie 展示交互式生成体验;OpenAI 的芯片设计进展和阿里云的算力收入则说明,AI 竞争正在向硬件和云基础设施延伸。
对开发者而言,关注计费口径变化和 API 定价差异,比单纯追逐模型参数更有实际意义。多起交易和 IPO 进展仍存在不确定性,需以官方公告为准。
相关推荐

Gemini 4 Neon 实测翻盘:美国豆包如何两周五连发
谷歌两周连发五个模型,Gemini 4 Neon 实测综合榜全球第三,编程智能体榜第一,成本比 Opus 5.5 砍半。B站UP主拆解翻身三层真相:监管松绑、稀疏MoE架构与自研TPU,并给出 Carbon 促销期省钱策略与 AntiGravity 额度规则。

Hermes Agent 是什么?会随时间成长的全天候AI代理
Hermes Agent 是一款常驻在线的 always-on AI 代理,可接入 WhatsApp、Telegram、Discord 等渠道,管理清单、日历与定时任务,并强调随使用不断成长。本文解析其定位、用法及与 OpenClaw、OpenAI dots 等产品的差异。

用Claude Code打造AI动画视频:本地工具链实战
本文实战演示如何用Claude Code结合Kokoro、Remotion等本地开源工具,在几分钟内生成带旁白、动画和背景音乐的AI视频,分析工作流、效率提升与局限性。