DeepSeek为何让美国巨头慌了?拆解四大效率优势与开源护城河
DeepSeek靠四层效率叠加与薄利策略持续领先,开源设计却难以被复制。
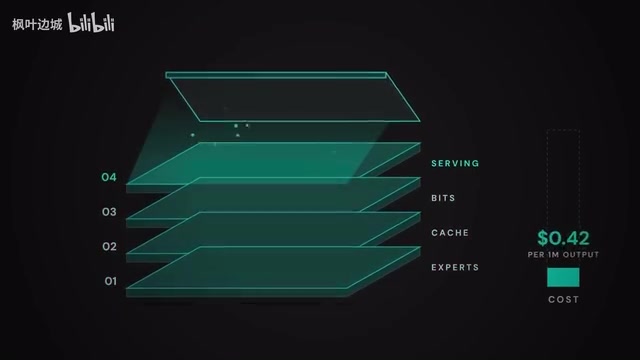
文章剖析了DeepSeek持续以极低成本推出强模型的原因:它不是靠某个单点技巧,而是四层效率优势的叠加——不对称混合专家架构(读取仅激活80亿参数、生成激活160亿参数)、极致的KV缓存压缩、8位/4位低精度存储,以及自研推理引擎DeepInfer(含投机解码与预填充捷径)。这些增益单独看都很温和,叠在一起才支撑起远低于美国闭源模型的价格。文章进一步指出,开源不等于可复制:缓存管理、负载均衡等关键工程代码并未公开,DeepInfer也只支持特定芯片。加之刻意保持薄利、用户只是通往AGI的副产品、背后有等得起的资本支持,DeepSeek的护城河不在保密,而在工程深度与成本结构。竞争焦点正从模型设计转向芯片与工程能力。
一次发布,两次震动
9月10日,DeepSeek广告发布v4.1 Flash——一个5520亿参数、性能却超过v4 Pro的模型。一个多月后的10月20日,他们又直接把推理引擎DeepInfer开源了。一个极强的模型,价格只是美国闭源模型的一小部分,而背后的资金投入远少于对方。
这种节奏反复出现:DeepSeek每发布一样东西,美国实验室就要忙着搞清楚它是怎么做到的。于是两个问题浮出水面——DeepSeek凭什么持续做到?如果模型全开源,美国实验室直接抄走、把它挤出市场不就行了?
答案不是某个单点技巧,而是四层效率优势的叠加。
四大效率杠杆:省下来的算力会复利
杠杆一:不必每次都动用整个大脑
DeepSeek的模型是混合专家(MoE)架构,拆成大量专家子网络,每个任务只激活其中一小部分。V3有6710亿参数,但每个token只激活370亿。v4.1 Flash更进一步:读输入只用80亿激活参数,写答案用160亿。
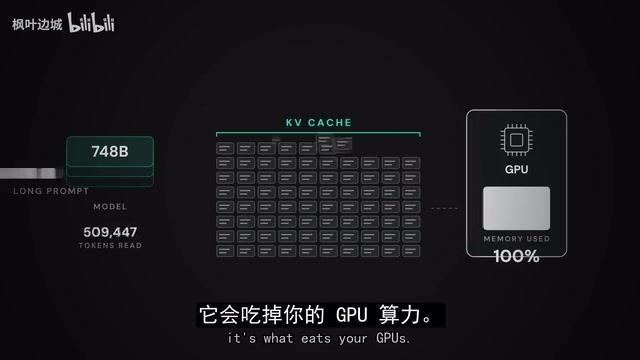
这个8和16的拆分是刻意为之——不对称的设计专为AI Agent而生。Agent每轮要读数万token的上下文,却只写几百token,让读取比生成更省,正好贴合真实工作负载的形状。有分析指出,5520亿是主模型,另有一个1960亿参数的记忆模块,合计约7480亿。
混合专家(MoE)的核心思想是将一个庞大的前馈网络拆分成多个并行的“专家”子网络,并引入一个轻量的路由网络。对每个输入token,路由器只挑选少数几个专家参与计算,其余专家保持静默。这样一来,模型总参数量可以做到数千亿甚至上万亿,但单次前向传播的实际计算量只与激活的专家数量成正比。MoE的优势在于用更大的参数容量换取更强的表达能力,同时把推理成本控制在可接受范围内;代价是训练时容易出现路由不均衡、专家利用率两极分化等问题,需要额外的负载均衡损失来约束。
杠杆二:把记忆压缩到极致
模型读长提示词时,会为看过的一切保留笔记,这就是KV缓存——在长上下文场景下,它是吃GPU的元凶。DeepSeek的做法是压缩这些笔记,然后只检索最相关的部分。
在百万token长度下,v4.1 Flash所需的计算量约为v3.2的10%,缓存内存约为7%。而v4.1 Flash又把缓存砍到高速内存的四分之一、磁盘存储的八分之一。
缓存之所以直接决定价格,是因为Agent每轮都会重发不断增长的上下文,等于反复为同一份缓存付费。DeepSeek公布的缓存命中价格为每百万token 0.3美分(非高峰时段)。有分析师算过一个读取1000万token的编程任务(大部分命中缓存):在v4.1 Flash上约21美分,而在Clod Opus 5或GPT 5.6 Sol上约11美元。这只是某位博主按标价做的估算,但足以说明节省如何层层累积。
KV缓存是Transformer推理中的一项关键机制。自回归生成时,模型每产生一个新token,都需要与之前所有token的键(Key)和值(Value)向量做注意力计算。为了避免重复计算,推理引擎会把历史token的K、V向量存下来,这就是KV缓存。它的内存占用随上下文长度线性增长,在百万token场景下可达到数十GB,直接挤占GPU显存并限制并发数。因此,压缩KV缓存、只保留或检索最相关的部分,是降低长上下文推理成本最直接的手段之一,也是各大推理引擎竞相优化的重点。
杠杆三:用更少的比特
模型内部的数字可以用高精度或低精度存储。DeepSeek把大部分缓存以8位格式存储,负责“决定看哪里”的组件则跑在4位上。精度更低,意味着内存更省、数学运算更快。
低精度量化是指用更少的比特位来表示模型权重或激活值,例如从16位浮点降到8位整数甚至4位。比特数越低,同样显存能容纳的参数和缓存就越多,内存带宽压力也越小,矩阵乘法的吞吐随之提升。难点在于精度损失:低位表示会引入舍入误差,可能拖累模型输出质量。实践中通常采用分通道缩放、异常值保留、混合精度等技巧来缓解。DeepSeek对缓存做8位存储、对路由组件做4位计算,本质上是在精度与成本之间做精细的权衡。
杠杆四:把模型跑好——DeepInfer
如果模型是菜谱,DeepInfer就是厨房。它使用投机解码——先用廉价的草稿步骤猜出后面若干个词,再由大模型校验;还有一个预填充捷径,DeepSeek称它几乎把读取提示词所需的计算减半。DeepSeek表示,其单个集群每天服务155万亿token。
每一层单独看都只是温和的增益,叠在一起,才让这个体量的模型能以这个价格出售。
投机解码是一种在不改变输出分布的前提下加速生成的推理技术。它先用一个更小、更快的草稿模型(或同一模型的轻量分支)连续猜出若干个候选token,再让目标大模型一次性并行校验这些候选。被接受的token直接保留,第一个被拒绝的位置之后重新采样。由于大模型的一次前向可以验证多个token,而草稿步骤本身很便宜,整体生成速度往往能提升一到数倍。其加速比取决于草稿的接受率:草稿越准,收益越大;草稿质量差时,开销反而增加。
开源不等于可复制:为什么对手抄不走结果
既然模型开源,大实验室直接拿去用不就行了?某种意义上,他们已经在这么做了。Meta的Llama4采用了类似DeepSeek V3的混合专家设计;OpenAI前CTO Meera Muradi创立的Thinking Machines,首个模型Inkling主要基于DeepSeek V3架构;GLM5则采用了DeepSeek的潜在注意力和稀疏注意力。
反方向同样成立:DeepInfer最初主要构建在开源引擎VLLM之上,并借鉴了SGLang和NVIDIA的TensorRT-LLM,VLLM团队曾公开致谢DeepSeek。开源是个循环,所有人都在里面。DeepSeek也借鉴对手:v4使用Muon优化器训练(来自Moonshot,在其Kimi K2上得到验证),升级的残差连接延续了字节跳动的思路,训练后蒸馏的形式则在报告中致谢Thinking Machines。
中国开源权重实验室之间,同样的部件几周内就会互相流传,而且往往注明来源——腾讯最新的模型卡就写明受DeepSeek和GLM启发。
但抄设计不等于抄结果。论文展示了模型的形状,却不会把GPU、多年经验和每个选择背后的实验一并交给你。就连DeepInfer也只是全貌的一部分。
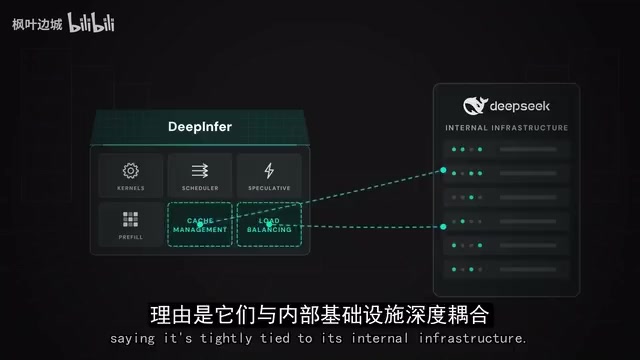
DeepSeek没有开源它的缓存管理和负载均衡代码,理由是这些与内部基础设施紧密绑定。DeepInfer只支持一个模型,且只跑在NVIDIA的Blackwell芯片和华为昇腾上,不支持更早的Hopper代际。
商业模式:为什么不靠保密也能活
既然设计可以被拿走,DeepSeek为什么没被挤出市场?因为它的生意从来不是建立在保密之上。
第一,难的不是设计,是便宜地跑起来。 创始人梁文锋说过,即使模型开源、把一切都告诉别人,进入门槛依然极高,低成本地用起来更难。部分优势恰恰在服务层——被DeepInfer扣下的缓存管理和负载均衡代码正是这里。
第二,据称它刻意保持薄利。 在一份泄露的投资人电话会记录中,梁文锋据称把API定价描述为:约10个月收回硬件成本,然后就此打住。逻辑很简单——定厚利,对手就能拿走你的开源权重来压价;薄利本身成为护城河。DeepSeek尚未确认该记录真实,且已警告用户API将大幅涨价,所以这个优势能维持多久仍是开放问题。
第三,卖给用户不是主要目标。 在同一份记录中,梁文锋据称把用户称为通往西瓜路上的芝麻,西瓜是AGI。聊天机器人和API只是研究的副产品,DeepSeek并不在产品市场上与抄袭者缠斗。
第四,背后有等得起的支持者。 DeepSeek脱胎于量化对冲基金HighFlyer,此后完成了约69亿美元的首轮外部融资。按创始人的说法,这些支持者并不要求聊天机器人快速回本。
效率公开之后,竞争转向哪里
DeepSeek持续颠覆AI行业,没有单一秘密。它堆叠了大量不炫目的效率:稀疏专家、压缩记忆、低精度数字、精简的推理引擎,然后把其中大部分公开。
正因为公开,想法开始扩散。对手已经在DeepSeek的设计上继续搭建,优势也随之从“谁有最好的设计”,转向“谁有芯片和工程能力把它跑得最便宜”。设计一旦公开,竞赛就变成谁能跑得最好。
这也解释了美国巨头的焦虑所在:他们面对的不是一个靠秘密取胜的对手,而是一个把牌摊在桌上、却依然因为工程深度和成本结构而难以追赶的对手。
相关推荐
Starlink Mini 2 发布:便携卫星上网再进化
Starlink Mini 2 在 Hacker News 引发热议,帖子获 285 点、291 条评论。本文梳理便携卫星终端的迭代方向、社区讨论焦点及实际使用场景。
PewDiePie自搜趣谈:退休、自研AI模型Ajax与Linux日常
PewDiePie发布自搜视频,回应退休传闻,透露自研AI模型Ajax已达60 tokens/s、仍处BF16训练阶段,并分享Arch Linux日常、OpenAI封禁经历与对YouTube生态的疲惫感。
PewDiePie自曝失败:两年喂乌鸦计划为何翻车?
PewDiePie分享两年失败经历:试图与日本乌鸦交朋友,从喂花生到拯救倒吊乌鸦,最终被一位日本爸爸“抢走”荣耀。视频展现了与野生动物互动的真实挑战,以及创作者坦诚失败的一面。