DeepSeek训练2万亿参数模型,剑指8万亿超大模型
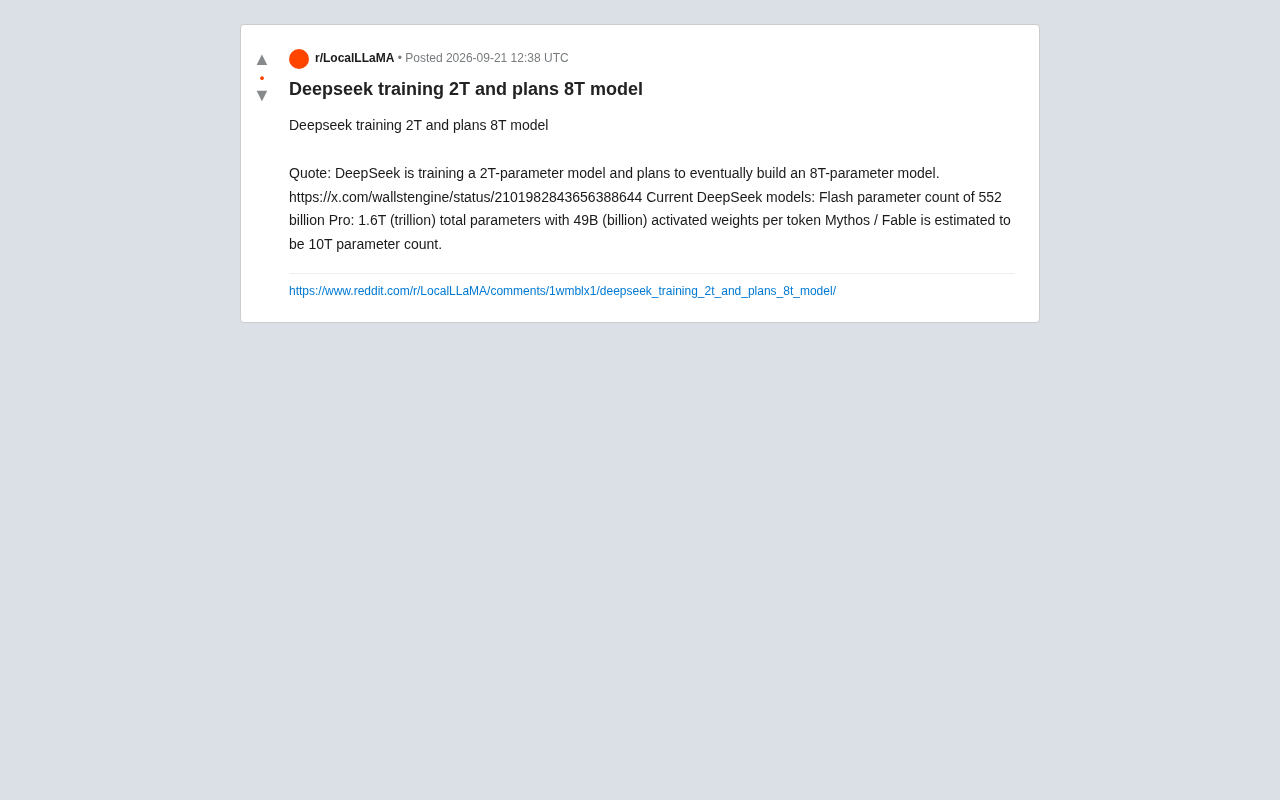
据爆料DeepSeek正训练2T参数模型并规划8T超大模型,核心路径为MoE稀疏架构。
据社交媒体爆料,DeepSeek正在训练2万亿参数模型,并计划最终打造8万亿参数的超大规模模型,消息尚未获官方证实。其现有模型已形成梯队:Flash约552B,Pro达1.6T总参数但仅激活49B(激活比约3%),另有疑似10T规模的Mythos/Fable。DeepSeek选择MoE(混合专家)架构而非稠密模型,是控制超大规模训练与推理成本的关键策略——庞大的总参数存储知识,而每次推理只调用极小比例的激活参数,使算力成本保持可控。文章同时指出,参数规模并非模型能力的唯一决定因素,数据质量、架构设计与训练策略同等重要。若规划成真,DeepSeek的超大模型将进一步推高开源社区天花板,并为MoE规模化落地提供更多实践参考。
DeepSeek的参数竞赛新动向
据Reddit社区流传的消息以及X平台账号WallstEngine的爆料,DeepSeek广告正在训练一个2万亿(2T)参数规模的模型,并计划最终打造8万亿(8T)参数的超大规模模型。如果消息属实,这将标志着这家以性价比和开源著称的中国AI公司,正在向参数规模的最前沿发起冲击。
需要说明的是,这些信息目前来自社交媒体的转述与爆料,尚未得到DeepSeek官方的正式确认,读者应保持审慎态度。不过结合行业趋势来看,头部厂商向更大参数规模演进的方向本身并不令人意外。
当前模型阵容的参数梯队
从流传的资料来看,DeepSeek现有的模型体系已经形成了较为清晰的参数梯队:
- Flash:约5520亿(552B)参数,定位轻量高效
- Pro:1.6万亿(1.6T)总参数,采用MoE(混合专家)架构,每个token仅激活约490亿(49B)权重
值得关注的是Pro模型的技术路径。1.6T的总参数配合49B的激活参数,激活比例仅约3%,这正是MoE架构的典型特征——通过稀疏激活在保持庞大知识容量的同时,将实际推理成本控制在可接受范围。这也是DeepSeek此前在成本效率上屡屡引发讨论的核心原因之一。
此外,爆料中还提到代号为 Mythos / Fable 的模型,估计参数量高达10万亿(10T)。如果这一估计准确,那么DeepSeek的模型规划远比外界想象的要激进。
为什么是MoE而非稠密模型
从2T到8T甚至10T,如果采用传统稠密(Dense)架构,训练和推理的算力成本将呈线性甚至超线性增长,几乎不具备商业可行性。而DeepSeek Pro展示的MoE路线,为超大参数模型提供了现实路径。
MoE架构的核心逻辑在于:模型拥有海量参数以存储知识,但每次前向计算只调用其中一小部分专家网络。这意味着8T参数的模型,其单次推理的计算量可能仅相当于一个几百B激活规模的稠密模型。对于追求极致成本控制的DeepSeek而言,这条技术路线的选择几乎是必然。
可以合理推测,未来的2T和8T模型大概率同样基于MoE或其演进架构,而非简单堆叠稠密参数。
MoE(Mixture of Experts,混合专家)架构并非DeepSeek的原创发明,其思想可追溯至1991年Jacobs等人的研究,近年由Google在Switch Transformer、GLaM等工作中重新带入大模型主流视野。其基本结构是:在Transformer的前馈层(FFN)位置,放置多个并行的"专家"子网络,并引入一个轻量级的"路由器"(Router)模块,负责在每个token的前向传播时,动态选择激活其中的Top-K个专家(通常K=1或2)。未被选中的专家参数在该次计算中完全跳过,因此总参数量与实际计算量(FLOPs)得以解耦。这种设计带来的工程挑战同样不容忽视:专家之间的负载均衡(避免大量token涌入同一专家导致其他专家"闲置")、跨设备的专家并行通信开销,以及训练稳定性,都是超大规模MoE落地必须解决的核心问题。DeepSeek-V2和V3已在这些方向有所创新,其提出的"无辅助损失负载均衡"等机制,正是应对上述挑战的工程实践。
参数规模的意义与局限
参数量的攀升往往被视为模型能力的直观指标,但业界越来越清楚地认识到,参数并非唯一决定因素。数据质量、训练策略、架构设计以及后训练对齐,同样深刻影响最终表现。
因此,2T或8T的数字本身更多是一种能力上限的信号,而非成绩单。一个训练充分、数据优质的2T MoE模型,实际表现未必逊于设计粗糙的更大模型。DeepSeek过去的模型之所以受到关注,恰恰在于它在有限规模下压榨出了超出预期的效果。
衡量大模型"实际算力消耗"时,业界常用的指标是激活参数量(Active Parameters)和每秒浮点运算次数(FLOPs)。对于MoE模型,总参数量(Total Parameters)决定了知识容量和存储成本,而激活参数量才真正对应推理延迟和算力开销。以DeepSeek Pro的数据为例,1.6T总参数、49B激活参数,意味着其推理成本与一个约49B的稠密模型相当,但知识容量却扩大了约32倍。这一比值(总参数/激活参数)有时被称为"稀疏度"或"扩展因子",是评估MoE模型效率的重要维度。因此,在比较不同模型的能力与成本时,单纯引用总参数量往往会产生误导——一个8T MoE模型的实际推理成本,可能仅与数百B量级的稠密模型相当,而非字面数字所暗示的那样"重"。
对行业的潜在影响
如果DeepSeek真的按计划推进8T乃至10T模型,其影响可能体现在几个层面:
第一,进一步推高开源社区的参数天花板。DeepSeek以往的开源策略,让其大模型的能力得以被更广泛地使用与研究,超大模型若延续这一路线,将对整个生态产生外溢效应。
第二,加剧头部厂商之间的算力与技术竞赛。参数规模的跃升背后是训练基础设施、数据管线和工程能力的全面比拼。
第三,为MoE架构的规模化落地提供更多实践样本。业界对超大稀疏模型的训练稳定性、专家负载均衡等问题仍在持续探索,DeepSeek的实践具有参考价值。
结语
当前所有信息仍停留在爆料与社区讨论阶段,2T模型训练进展、8T模型的具体规划都缺乏官方背书。但这条消息至少反映出一种明确的行业信号:以DeepSeek为代表的厂商,正沿着MoE路线向更大参数规模稳步推进。真正值得期待的,不是数字有多大,而是这些模型能否在成本与能力之间继续找到新的平衡点。
相关推荐
老式洗衣机变速箱维修:DIY修理经济学
一篇关于Whirlpool惠而浦洗衣机变速箱维修的技术记录在Hacker News被分享,本文探讨DIY家电维修的经济性、维修权文化及其在技术社区的意义。
VNCCS PoseStudio:Qwen Image 2.1 姿势控制LoRA发布
VNCCS PoseStudio 为 Qwen Image 2.1 推出首个姿势控制 LoRA,附带完整工作流,已在 Hugging Face 开源发布。本文解析其功能、获取方式与对AI图像创作的实际价值。
TechCrunch Disrupt 2026:Startup Battlefield 200的VC评委阵容前瞻
TechCrunch Disrupt 2026 的 Startup Battlefield 200 将迎来新一批VC评委。了解竞赛机制、早鸟报名优惠(9月25日截止,最高省200美元)及其对创业者的价值。