DeepSeek真是当年的OpenAI吗?五件事对比拆解

DeepSeek像2015年OpenAI的初心,但方向盘握在一个人手里。
文章将DeepSeek与2015年成立时的OpenAI在五个维度逐项对比:资金来源、开源程度、商业化路径、控制权结构和算力投入。结论是DeepSeek只对了一半——它像当年OpenAI那份“不以赚钱为目的、公开研究成果”的公告,却不像其方向盘:OpenAI的控制权在非盈利基金会手中,DeepSeek的投票权则集中于梁文峰管理的合伙企业。OpenAI旗舰模型始终闭源、收入超200亿美元并试水广告;DeepSeek以MIT协议开放权重、API薄利收费且仍在亏损。作者认为真正的考验在上市之后:当股东要求回报、16万颗芯片需要回本时,最强模型是否还放在门口,才能判断DeepSeek是否真是当年的OpenAI。
一句话结论:像的是初心,不像的是方向盘
OpenAI 2015年成立时在公告里写得很清楚:不以赚钱为目的,鼓励研究员把成果公开,论文、代码都分享给全世界。今天呢?最强的模型锁在自家服务器里,ChatGPT里开始试广告。反倒是名字里没有“Open”的DeepSeek广告,最强模型谁都能下载。连奥特曼自己都说过,在开源这件事上他个人觉得OpenAI站在了历史错误的一边。
那DeepSeek真成了当年的OpenAI吗?B站UP主Fred(“不看热闹看门道”)拆成五件事逐项对比——钱、开源、商业化、控制权、算力。我的判断是:只对了一半。像的是2015年那份公告,不像的是方向盘。
第一件事:钱从哪来,决定了你听谁的
OpenAI 2015年由马斯克、奥特曼等人承诺捐10亿美元。可承诺不等于到账——OpenAI后来自己披露,马斯克实际捐了不到4500万,其他人加起来9000多万。做大模型一张卡一度电都是钱,靠捐款根本扛不住。于是2019年,OpenAI在研究所下面挂了一家能赚钱的公司,同一年微软投了10亿美元。
DeepSeek 2023年由梁文峰成立,钱不找风投,是他自己的量化基金幻方出的;算力也不找外部,幻方几年前就花10亿建好了算力集群。梁文峰说过,风投想尽快商业化,可他们要优先做研究,所以很难从风投那里拿钱。不急着对投资人交代,先对研究交代——这确实像极了2015年那份公告。
第二件事:东西放不放出来
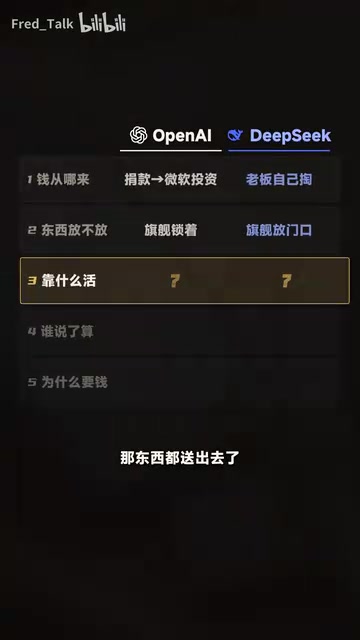
OpenAI钱一进来,东西就开始收了。2019年的GPT-2说怕被滥用,先放小版本,几个月后才放完整版;到了GPT-3干脆只给接口不给下载。去年8月,OpenAI在GPT-2之后第一次开放语言模型权重,可最强的旗舰到今天还锁着。
DeepSeek这边,R1和最新的V4.1权重用MIT协议,谁都能下载、修改、拿去商用,论文公开,推理框架也开源。只有训练数据两家都没放。说白了,一个把旗舰锁在产品里,一个把旗舰放在了门口。
MIT 协议是一种极为宽松的开源许可证,允许任何人自由使用、复制、修改、合并、发布、分发、再授权甚至销售软件副本,唯一要求是保留版权声明和许可声明。对模型权重而言,采用 MIT 协议意味着企业可以将其直接集成进商业产品而无需公开自有代码或支付授权费,这与 GPL 等“传染性”许可证形成鲜明对比。DeepSeek 选择 MIT 而非自定义限制性协议,实质上是把“能不能商用”的决策权完全交给了下游用户,这也是其开源姿态被认为比许多“开放权重但限制商用”的模型更彻底的原因。
第三件事:靠什么活,先做大还是先做深
你用ChatGPT,订阅每月20美元起,免费版在美国还开始试广告。DeepSeek的APP免费、没有广告,主要靠接口收钱。梁文峰说他们的价格只是在成本之上稍微有点利润。
规模差距摆在那里:OpenAI到去年底一年收入超过200亿美元;DeepSeek据报道今年前7个月营收大约4.75亿人民币,还在亏钱。一个先把生意做大,一个先把研究做深。
API 按 token 计费是大模型商业化最主流的模式:开发者调用模型接口时,按输入和输出的文本量(token 数)付费,价格通常以每百万 token 为单位标价。这种模式的优势是随用随付、门槛低,适合中小开发者和企业集成;劣势是单价透明、竞争激烈,难以形成订阅制那样的稳定现金流。DeepSeek 选择“成本之上稍微有点利润”的定价,意味着它把 API 当作覆盖算力开销的手段而非利润中心,这与 OpenAI 依靠 ChatGPT 订阅和广告构建高毛利收入结构的路径有本质区别。
第四件事(最关键):谁说了算
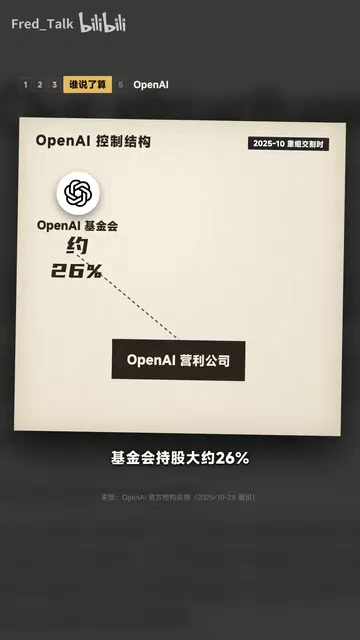
2023年10月17日,ChatGPT上线还不到一年,OpenAI董事会突然宣布奥特曼离开CEO的位置——创始人被自己的董事会请下了车。董事会凭什么能开掉他?因为管着这家公司的一直是那个非盈利部分。风波闹了十几天,奥特曼回来了。2025年重组后,基金会持股约26%,微软约27%,可任免公司董事的权利在基金会手里。所以OpenAI的方向盘从来不在一个人手里。
再看DeepSeek。今年6月,这家说过“很难从风投拿钱”的公司第一次融资就融了大约510亿,10月又传出一轮大约1000亿。这是不是在走OpenAI的老路?关键不在钱多钱少,而在钱进来以后谁说了算。第一轮里梁文峰自己出了约200亿,腾讯约100亿,可除了国家人工智能产业投资基金,其他投资人的钱都放进了梁文峰管理的合伙企业,没有投票权。钱进来了,投票权没跟着进来。
非盈利基金会控股是一种特殊的公司治理结构:由非盈利实体持有营利子公司的控制权,营利部分可以向投资人分配利润,但最终决策权保留在基金会手中。OpenAI 2019 年设立营利性子公司时采用的就是这种“ capped-profit ”模式,投资人回报设有上限,方向由非盈利董事会掌握。2025 年重组后,基金会持股约 26% 却仍握有董事任免权,正是这种结构的体现。它的设计初衷是防止资本短期回报压力扭曲研究使命,但代价是治理冲突频发——2023 年奥特曼被解职风波就是这种张力的一次集中爆发。
第五件事:算力,以及上市这道门槛
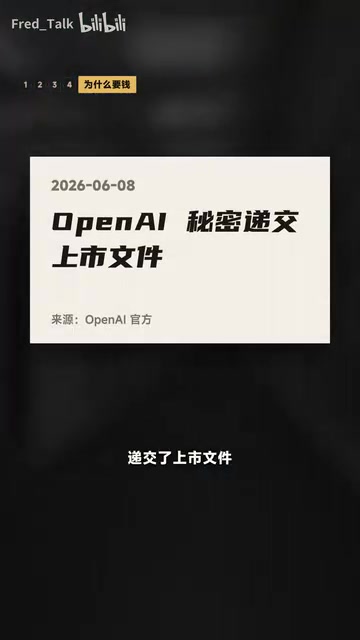
为什么两家都要这么多钱?答案是算力。奥特曼在博客里写过,做AI的投入会指数级往上涨。OpenAI今年3月一轮就拿到1220亿美元的承诺资本,星际之门打算4年投入首5000亿美元建数据中心。DeepSeek这边据彭博报道,计划部署至少16万颗华为昇腾950芯片——素材原文写作“生腾”,应为昇腾。于是两家都走到了上市门口:OpenAI今年6月秘密递交上市文件,9月奥特曼又说今年不上;DeepSeek也被曝请了中信证券筹备上市。
这里是我的猜测:DeepSeek真正的考验不在今天,在上市以后。OpenAI开得最多的时候,恰恰是它还没什么钱、没有投资人的时候。钱越来越大门就一扇扇关上了。DeepSeek上市以后有了股东,16万颗卡也要回本,到那时候最强的模型还放不放在门口,才看得出它到底像不像当年的OpenAI。
而方向盘握在一个人手里,好处是开不开它一个人说了算,风险也是——开不开只有它一个人说了算。
华为昇腾 950是华为昇腾系列 AI 加速芯片的一款型号,属于国产算力替代方案,主要用于大规模模型训练和推理。在美国对高端 GPU 出口管制的背景下,昇腾芯片被视为英伟达产品的国产替代选项之一,但其软件生态(CANN)与英伟达的 CUDA 相比成熟度仍有差距,迁移和调优成本较高。DeepSeek 计划部署至少 16 万颗昇腾 950,既是算力规模的扩张,也意味着其技术栈需要深度适配国产芯片,这会影响训练效率、模型迭代速度以及长期算力成本结构。
名字叫Open不算数,方向盘在谁手里才算数
回到开头那句:DeepSeek才是真正的OpenAI吗?我觉得只对了一半。像的是2015年的那份公告——不急着赚钱,把东西放出来;不一样的是方向盘:OpenAI的方向盘在一个基金会手里,DeepSeek的方向盘在梁文峰一个人手里。
所以真正值得盯的问题不是今天开源不开源,而是上市之后、股东要回报之后,最强的模型还会不会放在门口。
相关推荐

GPT-6 Astra读权重绝技:仅限小网络,实用靠写代码
GPT-6 Astra能直接读网络权重,但无工具设置仅限约17万权重的小网络。修复QUEN 3.5 0.8b推理循环靠写Python和50批练习,实测识别游戏耗时近一小时。本文梳理能力边界与两个安全提醒。

GPT-6 Astra 改写 Qwen 权重:7.9% 到 48.1%,是学会了数学还是学会了停?
MIT研究者用GPT-6 Astra直接编辑Qwen权重,数学得分从7.9%升至48.1%,全程无训练。但独立复现显示,提升主要来自修复循环、让模型学会终止作答,而非新增数学能力。

Qwen 3.8 27B 真能读懂神经网络权重?16GB 实测揭秘
MIT 研究声称大模型能直接读取神经网络权重并识别训练游戏。我们在 16GB 显卡上实测 Qwen 3.8 27B,发现信号真实存在,但“原生读取”说法不成立,25 行 Python 脚本即可秒级还原答案。