DGX Spark 对决 Mac Studio M5 Ultra:本地跑AI该选谁?
Mac Studio M5 Ultra与DGX Spark本地跑大模型:带宽、生态与内存容量的三维取舍
本文通过对比 Mac Studio(M5 Ultra,最高512GB统一内存,1.2TB/s带宽)与 NVIDIA DGX Spark(GB10芯片,128GB,273GB/s带宽),分析两者在本地AI推理场景下的真实差异。核心结论是:硬件规格之外,AI推理的Pre-Fill与Decode两阶段特性、MoE模型架构、多机扩展方式以及软件生态,才是决定体验的关键变量。NVIDIA凭借CUDA生态和算力在处理高并发、新模型适配上更具优势;Mac Studio则以超大统一内存、极高带宽和macOS全能体验胜出,尤其适合长上下文、超大量化模型以及兼顾日常生产力的用户。两者面向的是不同诉求的玩家,并无绝对优劣之分。
苹果最新的 Mac Studio 带来了不小的惊喜——M5 Ultra 版本最高支持 512GB 统一内存,内存带宽直接冲到 1.2TB/s。另一边,NVIDIA 有一台专门给 AI 玩家准备的小型超级计算机 DGX Spark。当我们不是拿它们剪视频、办公,而是专门用来跑本地大模型时,到底哪一台更值得入手?这篇文章基于 B站UP主的实测分析,帮你理清两者的真实差异。
两台机器的硬件底牌
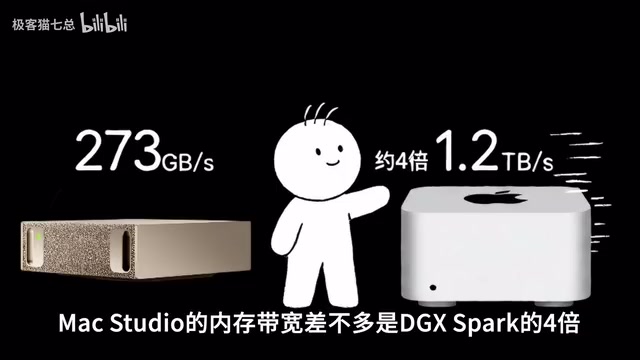
DGX Spark 搭载的是 GB10 Grace Blackwell 超级芯片,配置 20 核 Arm CPU、Blackwell 架构 GPU、128GB LPDDR5X 统一内存,内存带宽为 273GB/s。此外它还带有 ConnectX-7 高速接口,最高可达 200Gbps,为多机互联埋下伏笔。
而 M5 Ultra 版本的 Mac Studio 最高配备 80 核 GPU、最高 512GB 统一内存,内存带宽达到 1.2TB/s。单从数字上看,Mac Studio 的内存带宽几乎是 DGX Spark 的 4 倍。
但看到这里先别急着下结论——内存带宽只是故事的一半。
为什么带宽不是唯一答案:Pre-Fill 与 Decode
要理解两台机器的真实差距,得先搞清楚 AI 推理的两个阶段。
Pre-Fill 阶段,是把你输入的一大段文字先“吃”进去。比如一次塞进 1 万 Token,这个阶段计算量大,更吃矩阵计算能力,正是 NVIDIA 擅长的领域。Blackwell 的 Tensor Core 加上 CUDA、TensorRT-LLM 这套软件栈,就是专门为此打造的。
Decode 阶段,则是我们真正看到 AI 一个字一个字往外蹦的过程。特别是单用户、Batch Size 较小时,模型每生成一个 Token 都要反复从统一内存里读取权重,这时候内存带宽就变得至关重要。理论上,Mac Studio 恐怖的 1.2TB/s 带宽在 Decode 阶段拥有巨大优势。
不过要提醒的是,理论带宽能不能转化成实际的 Token 输出速度,还得看 GPU 架构和软件优化的配合,纸面数字并不能直接画等号。
KV Cache 是理解带宽瓶颈的另一个关键概念。在 Decode 阶段,模型每生成一个新 Token,都需要参考此前所有 Token 的注意力中间结果(Key 和 Value 矩阵)。这些中间结果会被缓存下来以避免重复计算,即 KV Cache。随着对话轮次增多或上下文窗口拉长,KV Cache 会持续膨胀,甚至在长文本场景下占用几 GB 到几十 GB 的内存。这意味着内存带宽不仅要服务于反复读取模型权重,还要承载日益增长的 KV Cache 读写——这正是高带宽机器在长上下文推理中优势更为突出的原因。
Batch Size 同样影响瓶颈所在。当同时服务多个用户(大 Batch)时,计算密度上升,GPU 的矩阵运算单元利用率提高,算力成为瓶颈;而单用户交互(小 Batch 或 Batch Size=1)时,计算量不足以填满算力,内存带宽便成为限制 Token 生成速度的主要因素。
MoE 模型改变了游戏规则
现在越来越多模型采用 MoE(混合专家)架构,情况就更复杂了。以此前测试的 Qwen 3.5 122B A10B 为例,122B 是总参数,但激活参数只有 10B。
这也解释了为什么一台 128GB 的 DGX Spark 或 128GB 的 Mac,都已经能挑战 100B 级别的模型。一些优化得当的 MoE 模型,甚至能在 DGX Spark 上跑出相当不错的速度。
但不管用什么模型,第一道门槛永远是——装不装得进去。按 4bit 量化粗算,平均每个参数约需 0.5 字节,光权重就已经是几十甚至上百 GB。再加上量化信息、运行时缓存,以及随上下文变长而膨胀的 KV Cache,128GB 到底够不够,绝不是简单拿参数乘 0.5 就能算清的。
这正是 M5 Ultra 真正的杀手锏——最高 512GB 统一内存。苹果官方已确认 512GB 版本会在 10 月底上市,届时本地能跑的模型规模会再上一个档次。喜欢折腾超大模型的玩家,Mac Studio 确实很有吸引力。
MoE(Mixture of Experts,混合专家)架构的核心思想是:将一个大模型拆分成若干个"专家"子网络,每次推理时由一个轻量级的"路由器"决定激活哪几个专家来处理当前输入,而非让所有参数都参与计算。以 Qwen 3 235B A22B 为例,235B 是全部专家的参数总量,但每次前向传播只激活约 22B 的参数。这带来两个直接好处:推理时的实际计算量大幅降低(接近同等激活参数的稠密模型),同时模型的"知识容量"却接近总参数规模的稠密模型。代价是:所有专家的权重仍需常驻内存,因此对内存容量的需求并未随激活比例下降,这也是为什么 MoE 模型虽然跑得快,却依然对大内存有强烈需求。
多机扩展:统一内存 vs 分布式
那一台 Spark 内存不够怎么办?答案很简单:再买一台。两台 DGX Spark 就是 256GB 总内存,看起来和 256GB 的 Mac Studio 差不多,但千万别把它们当成一回事。
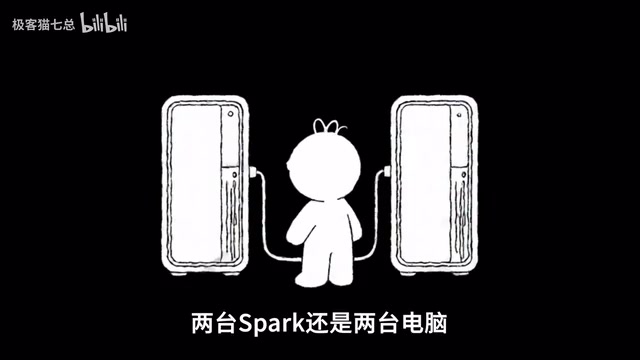
两台 Spark 本质上还是两台电脑,模型需要通过 Tensor Parallel 切分,节点之间不断交换数据。NVIDIA 提供了 Spark 集群方案,让多台机器协同跑单台装不下的模型。好处是可以持续往上堆——一台不够两台、三台;缺点也很明显:网络、系统、容器、分布式环境全都要自己管理。
而 Mac Studio 的 256GB 或 512GB 是一整块统一内存,模型直接往里塞。对不想折腾的玩家来说,这种“省心”是实打实的体验优势。
Tensor Parallel(张量并行) 是大模型分布式推理的常用策略之一,其核心做法是将模型的权重矩阵按行或列切分,分散到多张显卡或多台机器上,各自计算部分结果后通过高速互联汇总。这意味着每一个推理步骤都需要跨节点的 AllReduce 通信,延迟和带宽直接影响整体速度。DGX Spark 配备的 ConnectX-7 支持最高 200Gbps 的 NVLink-C2C 或 InfiniBand 互联,在 NVIDIA 自家集群方案中通信开销相对可控;但与单机统一内存相比,跨机通信的延迟仍是数量级的差距。这也是为什么两台 128GB Spark 组成的 256GB 分布式集群,在实际吞吐上并不等同于一台原生 256GB 统一内存机器的根本原因。
真正拉开差距的是软硬件生态
如果让人来选,两者真正的分水岭其实不在硬件,而在生态。
DGX Spark 最大的优势并不只是 FLOPS,而是 Blackwell 硬件 + CUDA + 整个 NVIDIA AI 软件生态。很多 AI 项目刚发布时,CUDA 往往是优先适配的平台。你想折腾新模型、新推理框架(vLLM 等),甚至自己改 Kernel,NVIDIA 基本都是第一顺位。
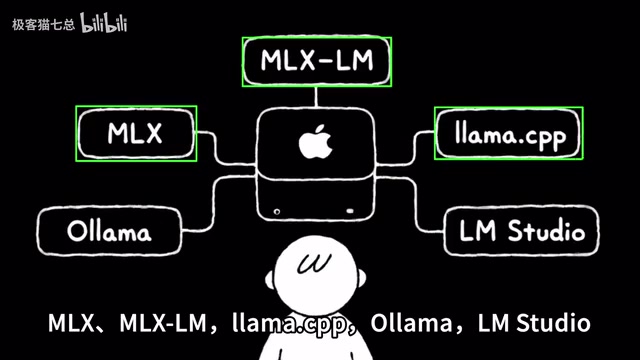
Mac Studio 也并非不能玩。MLX、Ollama、LM Studio 等工具让 Mac 本地 AI 已经相当好用,加上 macOS 的省心优势——白天剪视频、晚上跑模型、顺便开浏览器写代码,它始终是一台正常的电脑,不用当服务器伺候。
到底该怎么选?
这两台机器都不是给普通办公用户准备的。选择的关键在于你的使用场景:
- 如果你是 AI 开发者,每天研究新模型,需要 CUDA、TensorRT-LLM、vLLM 服务、Linux 环境,甚至以后想组多机集群,那么 DGX Spark 更合适。
- 如果你更看重超大统一内存、高带宽、长上下文,想本地跑更大规模的量化模型,同时还要剪视频、修图、办公、写代码,那么 Mac Studio(尤其是 512GB 的 M5 Ultra) 非常有吸引力。它的 1.2TB/s 带宽配上 512GB 内存,是目前桌面本地 AI 里相当夸张的一台机器。
当然,如果两个都想要,那就不用纠结了——钱包会替你做决定。
相关推荐
GLM 反向代理工具实测:免登录调用背后的技术与风险
GLM 反向代理工具宣称可免登录白嫖 AI 大模型能力,本文实测解析其接口调用原理、防封逻辑,并从稳定性、合规与安全角度提示这类工具的潜在风险。
Opus 5.5 一键生成动画短片:$3.21 API 费用背后的自主创作实验
一位 Reddit 用户用 Opus 5.5 通过单条提示词自主生成手绘风格动画短片,OpenRouter API 花费仅 3.21 美元,调用 8 个 API 完成脚本、图像、配音到动画全流程。本文解析其成本结构与 AI Agent 自主编排能力。
Bessemer募资57.5亿美元加码AI:豪赌AI原生公司高增长
老牌风投Bessemer募集57.5亿美元新基金全力押注AI,称AI原生公司增长速度超过历史上任何技术。本文解析这笔巨额资金背后的行业逻辑与潜在风险。