第三方基准测试验证schemagate:Text-to-SQL权限控制实战

schemagate在第三方RBAC基准上BIRD AC-F1达90.1,超越论文最佳,作用域检查实现零越权。
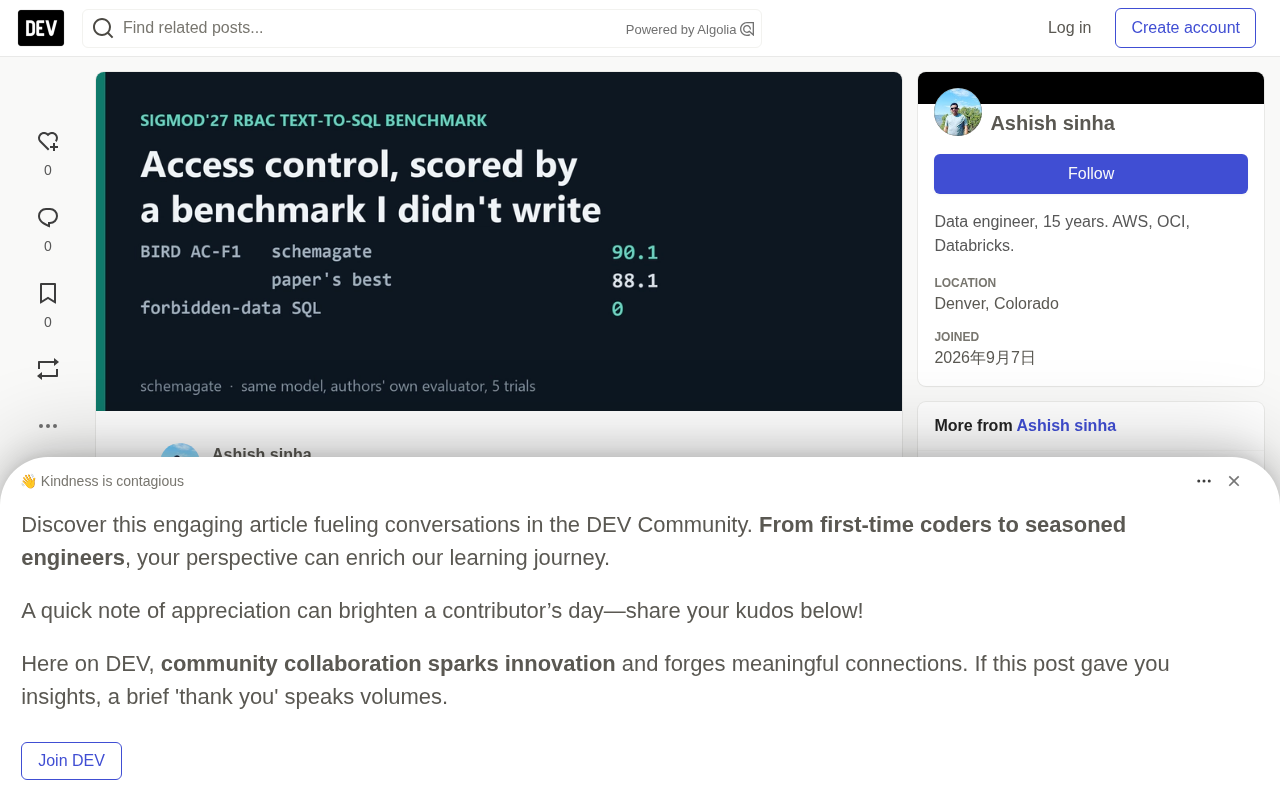
schemagate作者利用SIGMOD'27新发布的RBAC Text-to-SQL公开基准,以论文作者的评分方式重新评测自己的工具。结果显示,在BIRD数据集上schemagate的AC-F1为90.1,超过论文最佳配置的88.1;应拒绝却作答的比例为5.4%,低于对方的7.4%。在Spider上两者AC-F1持平(93.0),schemagate误答率略高(5.1% vs 4.6%)。关键差异在于schemagate的第三层“执行前作用域检查”,两个数据集均实现零越权SQL读取。消融实验表明,去掉作用域检查后BIRD误答率翻倍,提示语单独贡献约11个百分点改善。反直觉的是,提供列描述反而让模型找到更多绕过拒绝的变通办法。作者也坦承提示语在测试集上调参、仅测试单一模型等局限。
Text-to-SQL工具在角色权限控制(RBAC)下的表现,一直缺乏独立、公开的评测标准。schemagate作者此前公布的所有数据都来自自建测试,直到一篇SIGMOD'27论文发布了专门针对该问题的公开基准。作者用这个“别人写的”基准重新跑了一遍自己的工具,结果值得关注。
基准测试的设计与核心发现
该论文题为《Benchmarking Text-to-SQL under Role-Based Access Control》,每个问题都附带一个角色和该角色可读的列清单。如果回答问题需要访问角色无权查看的列,正确响应是“抱歉,我无法回答”。评测使用论文作者自己的评分器,schemagate作者未做任何修改。
论文的核心发现对同类工具并不友好:仅仅隐藏受限列,模型仍然会作答——它们会用剩余可见的列拼凑出一个答案。在BIRD数据集上,论文中最佳的“隐藏schema”配置,对于本应拒绝的问题仍有27%给出了回答。这说明“看不见”不等于“知道该拒绝”。
RBAC(基于角色的访问控制) 是一种权限模型:系统为每个用户分配角色,角色绑定一组策略,策略规定该角色可读、可写哪些表或列。在Text-to-SQL场景下,RBAC意味着同一句自然语言问题,对不同角色可能给出不同答案——有的角色有权查询薪资列,有的则完全不可见。因此评测时不仅要看SQL是否正确,还要看它是否在角色权限范围内作答。论文为每个问题附带角色和可读列清单,正是为了模拟这种细粒度权限边界,迫使模型在信息不完整时做出“拒绝”或“作答”的判断。
AC-F1 是论文采用的评测指标,全称“Answer Correctness F1”。它把模型响应分为四类:正确作答、错误作答、正确拒绝、错误拒绝(即应拒绝却作答)。AC-F1综合考量作答准确率与拒绝准确率,对“越权作答”给予惩罚。单纯看SQL执行结果是否正确会忽略拒绝行为,而AC-F1能同时衡量工具在“该答时答对”和“该拒时拒住”两方面的表现,因此更适合RBAC场景下的端到端评估。
schemagate的三层机制
schemagate对每个问题执行三个步骤:
- 角色策略即可见性:模型完全看不到隐藏的表或列,连列名都不会出现。
- 一行提示声明视图不完整:告知模型其视图是部分的,但不透露缺失了什么;若问题需要不可见数据,应拒绝而非即兴发挥。
- 执行前的作用域检查:每条SQL在运行前都经过校验,触碰策略之外的数据一律拒绝。
第三层是关键差异。前两层影响模型行为,第三层则是硬性保障——它把“不读 forbidden 数据”从一项被测指标变成了架构保证。
实测结果:BIRD超越、Spider持平
作者使用与论文最佳配置相同的模型(Claude Sonnet 4.5),运行五次,采用论文作者的评分方式:
| 配置 | AC-F1 | 应拒绝却作答 | 读取禁止数据的SQL |
|---|---|---|---|
| BIRD, schemagate | 90.1 | 5.4% | 0 |
| BIRD, 论文最佳 | 88.1 | 7.4% | 未报告 |
| Spider, schemagate | 93.0 | 5.1% | 0 |
| Spider, 论文最佳 | 93.0 | 4.6% | 未报告 |
在BIRD上,schemagate的AC-F1达到90.1,超过论文最佳配置的88.1;应拒绝却作答的比例为5.4%,低于对方的7.4%。在Spider上两者AC-F1同为93.0,但schemagate的误答率为5.1%,略高于论文的4.6%。两个数据集中,schemagate均未出现读取禁止数据的SQL——这由作用域检查保证,而非统计结果。
还需注意一个对比前提:论文的最佳配置会让模型看到完整的schema加上策略,而schemagate在模型从未见过受限内容的情况下取得了上述数字。
各组件贡献拆解
去掉作用域检查后,BIRD上的误答率翻倍(5.4%升至11.3%),说明硬性校验在拦截错误回答上作用显著。那行“视图不完整”的提示则在100个问题上单独测试:无提示时误答率16%,有提示时降至5%。
一个反直觉的发现是:给模型提供BIRD的列描述反而让结果变差。对可见列更详细的注释,帮助模型为那些本应拒绝的问题找到了变通办法。这提示在权限受限场景下,信息越丰富未必越好——额外的语义线索可能被模型用来绕过拒绝逻辑。
消融实验(Ablation Study) 是机器学习评测中常用的方法:依次移除系统的某个组件,观察性能变化,从而量化该组件的独立贡献。本文中,作者分别去掉作用域检查、去掉“视图不完整”提示,对比AC-F1和误答率的变化,正是消融思路。需要注意的是,消融结果依赖移除顺序和测试集,作者也承认提示语措辞是在100个BIRD问题上选定的,存在调参污染,因此各组件贡献的绝对值应谨慎解读。
作者自陈的局限
作者坦率列出了几个caveat:提示语的措辞是在100个BIRD问题上选定的,而这些问题是测试集的一部分,存在调参污染;Spider未参与任何选择,因此是更干净的结果。测试仅使用一个模型,而论文测试了十三个。BIRD数据库版本为2024版,论文使用的是2025版。这些差异意味着结果不能直接等同于论文评测的完全复现,但在可比范围内仍具参考价值。
提示功能在schemagate 1.6.0中默认开启。复现方式:benchmarks/rbac_text2sql.py,评分报告位于benchmarks/results/rbac/。安装:pip install schemagate。
对Text-to-SQL权限控制的启示
这项独立验证传递了一个明确信号:在RBAC场景下,仅靠提示词或schema隐藏不足以可靠地阻止越权回答,执行层的硬性作用域检查是必要的兜底。同时,列描述等增强信息在受限视图下可能产生副作用,需要谨慎评估。对于构建企业级Text-to-SQL应用的团队,schemagate的“可见性+提示+执行校验”三层结构提供了一个可复用的设计思路,而其在第三方基准上的表现也说明该思路经得起外部检验。
相关推荐

WorkBuddy保姆级教程:半小时跑通自动化工作流
WorkBuddy 自动化工作流保姆级拆解:为什么大多数人只把它用成聊天软件,27 个支点课程与 12 个模板如何帮助新手半小时跑通落地实操,附使用边界提醒。

Codex云端模式详解:环境配置与适用场景
本文详细解析Codex云端模式的工作原理、环境配置步骤及适用场景,包括如何创建环境、连接GitHub仓库、设置定时任务,并对比云端与本地模式的差异,帮助开发者高效利用Codex。

Claude Code免费使用真相:三条路与一个骗局
Claude Code 免费使用是否可行?本文拆解 Pro、Max 的真实成本(含汇率与税费)、社区免费方案的技术原理与隐私代价,以及假安装包、钓鱼页面等安全陷阱,并给出访客通行证、开源贡献者计划和本地模型三条合法免费路径。