低显存本地大模型对决:Bonsai 2量化版为何胜出
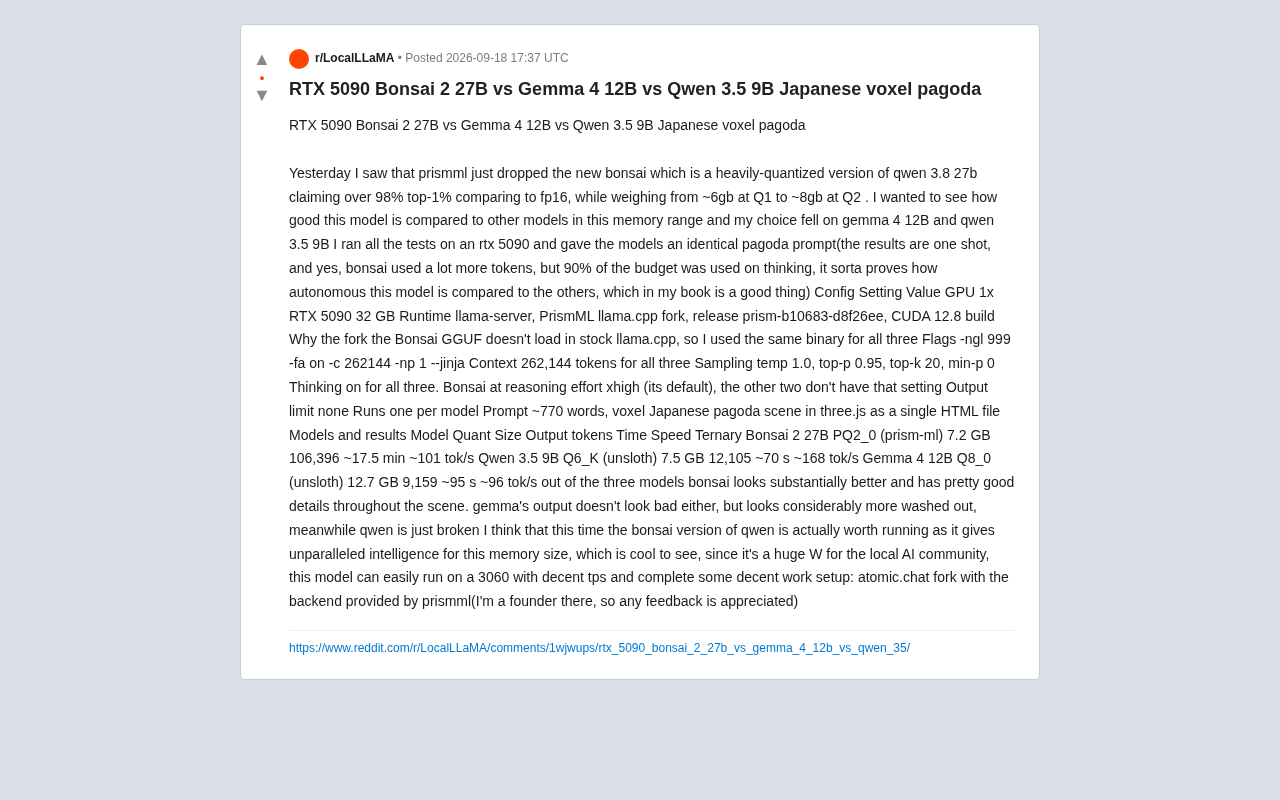
RTX 5090上横评三模型:Bonsai 2用7.2GB三元量化塞下27B参数,代码质量领先但耗时超17分钟
一位Reddit用户(同时是PrismML工具链创始人)在RTX 5090上对比了三个显存占用相近的本地模型:三元量化版Bonsai 2 27B(7.2GB)、Qwen 3.5 9B Q6_K(7.5GB)和Gemma 4 12B Q8_0(12.7GB),任务是用three.js一次性生成日式体素宝塔的HTML渲染场景。结果显示Bonsai在画面细节上明显优于另外两者,Gemma 4表现尚可,Qwen 3.5则直接崩溃。代价是Bonsai消耗了超10万tokens、耗时17.5分钟,约90%花在思考阶段。Bonsai的核心卖点在于极端压缩:三元量化将每个权重限制在三个离散值,理论存储需求约1.58比特,使27B级能力可在RTX 3060等12GB显存显卡上运行。但评测存在利益倾向、样本量仅一次、且需专用llama.cpp分支,结论须审慎对待。
一次针对小显存场景的三模型横评
一位 Reddit 用户在 RTX 5090 上做了一组颇具参考价值的本地模型对比。测试的核心是 PrismML 新发布的 Bonsai 2,这是一个基于 Qwen 3.8 27B 的重度量化版本,官方声称在 Top-1 指标上能保留超过 98% 的 FP16 表现,而模型体积却压缩到 Q1 约 6GB、Q2 约 8GB 的水平。作者想验证:在同一显存区间内,这个量化模型能否打败原生的中小尺寸模型。
对比对象选择了 Gemma 4 12B 与 Qwen 3.5 9B。三个模型被要求用 three.js 在单个 HTML 文件里渲染一个日式体素宝塔(voxel pagoda)场景,提示词约 770 字,全部为一次性(one-shot)输出。
测试环境与参数配置
为了保证公平,作者尽量统一了运行环境。三个模型都跑在同一台配备 1x RTX 5090 32GB 的机器上,使用的是 PrismML 的 llama.cpp 分支(release prism-b10683-d8f26ee,CUDA 12.8 构建)。之所以要用这个分支,是因为 Bonsai 的 GGUF 无法在原版 llama.cpp 中加载,于是作者干脆用同一个二进制文件跑完三个模型,避免运行时差异带来的干扰。
关键参数方面:-ngl 999(全部层放显卡)、-fa on(flash attention)、-c 262144(上下文 26 万 tokens)、-np 1、--jinja。采样设置为 temp 1.0、top-p 0.95、top-k 20、min-p 0,三个模型均开启思考(thinking)模式。其中 Bonsai 使用了其默认的 xhigh 推理强度,另外两个模型没有对应设置。输出不设上限,每个模型各跑一次。
三种不同的量化路线
值得留意的是三个模型的量化格式差异明显:
- Ternary Bonsai 2 27B:PQ2_0(prism-ml 三元量化),7.2GB
- Qwen 3.5 9B:Q6_K(unsloth),7.5GB
- Gemma 4 12B:Q8_0(unsloth),12.7GB
换句话说,Bonsai 用 7.2GB 的体积塞进了一个 27B 参数的模型,这正是它的核心卖点——通过极端量化把大模型压进小显存。
**三元量化(Ternary Quantization)**是一种极端的模型压缩方式,将神经网络权重限制在三个离散值(通常为 -1、0、+1)上,而非传统 FP16 的 65536 个浮点值或 INT8 的 256 个整数值。这意味着每个权重理论上只需约 1.58 比特来存储,相比 FP16 的 16 比特压缩比高达 10 倍以上。PrismML 的 PQ2_0 格式正是基于此原理,通过对 Qwen 3 27B 的参数做三元化处理,把一个通常需要 14-16GB 空间的模型压缩至 7.2GB。
相比之下,Q6_K 和 Q8_0 属于传统的线性量化(每个权重分别用约 6 位和 8 位表示),压缩力度温和得多,精度损失也相对可控。三元量化之所以罕见,是因为精度损失在理论上极难控制——Bonsai 声称的「Top-1 指标保留超过 98%」若属实,则意味着其背后必然使用了额外的训练补偿技术(如量化感知训练),而非简单的权重截断。
结果:速度与质量的取舍
从原始数据看,三者表现差异很大:
| 模型 | 量化 | 体积 | 输出 tokens | 耗时 | 速度 |
|---|---|---|---|---|---|
| Bonsai 2 27B | PQ2_0 | 7.2GB | 106,396 | ~17.5 分钟 | ~101 tok/s |
| Qwen 3.5 9B | Q6_K | 7.5GB | 12,105 | ~70 秒 | ~168 tok/s |
| Gemma 4 12B | Q8_0 | 12.7GB | 9,159 | ~95 秒 | ~96 tok/s |
Bonsai 消耗了远超其他两者的 token 量(超过 10 万),耗时长达 17.5 分钟。作者特别解释道,这些 token 中约 90% 都花在了「思考」阶段。他把这看作是模型自主性强的证据——愿意自己反复推演,而不是草草给出答案。这个观点见仁见智,长思考既可能意味着更充分的规划,也可能意味着效率低下,读者需要结合自己的使用场景判断。
输出质量的主观评价
在最终画面效果上,作者给出了明确排序:Bonsai 的宝塔场景细节明显更丰富,整体质量领先;Gemma 4 的输出也不算差,但画面偏「褪色」、缺乏层次;Qwen 3.5 9B 则被形容为「直接崩了」(broken)。
需要指出,这属于单次、单人主观评测,样本量仅为一次运行,不同随机种子和采样波动都可能改变结论。因此结果更适合作为方向性参考,而非严格的基准测试。
表格中的速度差异有一个底层原因值得理解:模型推理速度(tokens/s)受内存带宽而非算力主导。RTX 5090 的显存带宽极高,但 Bonsai 在相同带宽下的速度反而低于 Qwen 3.5 9B(101 vs 168 tok/s),主要原因有两个:一是 27B 参数量远多于 9B,每生成一个 token 需要读取更多权重数据;二是三元量化的解码路径在 GPU 上的优化成熟度尚不及传统 GGUF 量化格式,存在额外的计算开销。Gemma 4 12B 速度最慢(96 tok/s)则主要因为其 Q8_0 格式体积最大(12.7GB),内存带宽消耗最高。因此「更小体积=更快速度」的直觉在此不完全成立,模型架构和量化格式的 GPU 优化程度同样关键。
对本地 AI 社区意味着什么
如果 Bonsai 的表现能够稳定复现,它的意义确实不小。作者的判断是:这个 Qwen 的量化版本这次「值得一跑」,因为它在相同显存占用下提供了同级别里罕见的智能水平。更关键的一点是——7.2GB 的体积意味着它可以在一张 RTX 3060 上以尚可的 tps 运行并完成有意义的任务。
对于预算有限、只能用消费级显卡跑本地模型的用户来说,能把接近 27B 级别的能力塞进 12GB 甚至 8GB 显存,是一个实实在在的进步。这也是当下本地大模型领域的一个重要趋势:不再单纯堆参数,而是通过更激进的量化技术,让大模型「下沉」到更普及的硬件上。
需要保持的谨慎态度
有一点必须透明说明:发帖者本人是 PrismML 与相关工具链(atomic.chat 分支)的创始人之一。这意味着评测存在潜在的利益倾向,「98% Top-1 保留率」这类官方数字也需要独立第三方验证后才能采信。此外,Bonsai 需要专用的 llama.cpp 分支才能运行,生态兼容性目前仍是短板。
总体而言,这组测试展示了三元量化在压缩大模型上的潜力,也提醒我们:极端量化在换来体积优势的同时,可能以更长的推理时间为代价。对本地部署感兴趣的用户,不妨在自己的硬件上亲自跑一遍,用实际任务检验它是否真的物有所值。
「Top-1 保留率」是量化模型常用的一个基准指标,指量化后模型在分类任务中预测概率最高的类别与原始模型一致的比例。但这个指标有其局限性:它主要适用于封闭式分类场景,对代码生成、长文推理等开放式任务的代表性存疑。一个模型可以在 Top-1 指标上接近 FP16 水准,但在需要精确数值计算或多步逻辑链条的任务上出现明显退化。因此「98% Top-1 保留率」更适合理解为最优情境下的上界参考,而非对所有任务场景的通用承诺。独立的代码生成、数学推理等专项基准测试结果将更有说服力。
相关推荐
ChatGPT发明者推新型AI模型Jev,开发者为何兴奋
由ChatGPT核心研发者推出的新型AI模型Jev正引发开发者热议,主打更便宜、更快速的软件智能路径。本文解析其定位、开发者兴奋的原因及需审慎看待的信息盲点。
Cloudflare Quick Tunnels:一行命令把本地服务暴露到公网
Cloudflare Quick Tunnels 让开发者用一行 cloudflared 命令即可把本地服务暴露到公网,无需账号和域名,自带 HTTPS。本文解析其用法、应用场景、优势局限及与 ngrok 等工具的对比。
SCIM日志功能上线:直击身份供给调试痛点
SCIM目录新增Logs日志标签页,可查看IdP发送的每一次供给请求、完整payload及失败原因说明,大幅简化身份供给(provisioning)调试流程,提升企业身份集成的可观测性。