低资源语言食谱翻译新基准:ReciLoReL与ReciLex
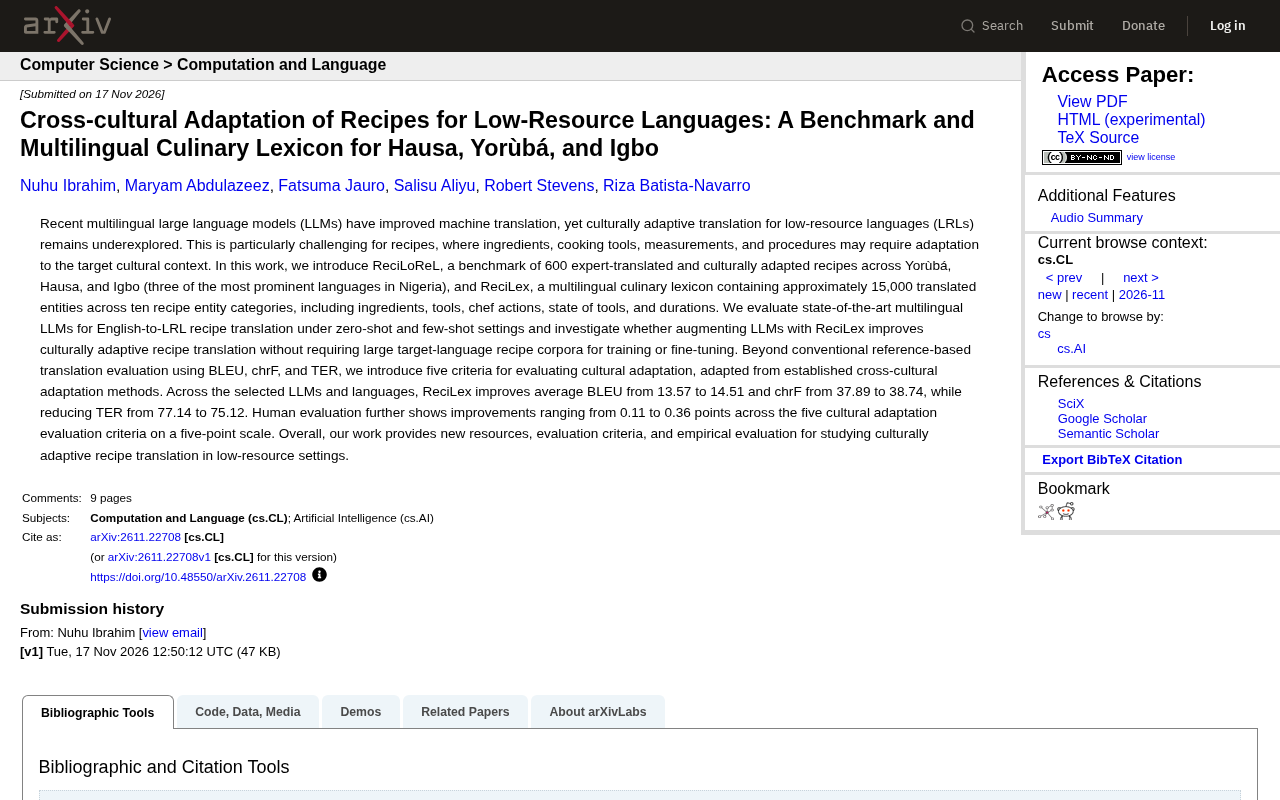
新论文发布尼日利亚三语食谱翻译基准与词典,证明词典增强可提升文化适配翻译质量。
针对豪萨语、约鲁巴语和伊博语等低资源语言在食谱翻译中缺乏文化适配资源的问题,论文提出ReciLoReL基准(600条专家翻译并文化适配的食谱)和ReciLex词典(约1.5万条烹饪实体,覆盖十个类别)。研究在BLEU、chrF、TER等自动指标之外,改编出五项文化适配评价标准并进行人工五分制评估。实验表明,仅靠词典增强、不做微调,即可将平均BLEU从13.57提升至14.51,chrF从37.89提升至38.74,TER从77.14降至75.12,五项文化适配标准提升0.11至0.36分。作者指出该路径轻量可行,但结论受限于特定语言和领域,自动指标提升幅度有限,词典增强只是起点。
当食谱翻译遇上文化差异
多语言大模型在机器翻译上进步显著,但面向低资源语言的文化适配翻译仍是一片荒地。豪萨语、约鲁巴语和伊博语是尼日利亚最主要的三种语言,却长期缺乏高质量的平行语料。食谱文本尤其棘手——食材、厨具、计量单位、操作步骤都需要在目标文化语境中重新落地。一篇新论文提出了 ReciLoReL 基准与 ReciLex 词典,试图为这一难题提供可复用的评测框架和知识资源。
ReciLoReL:600条专家翻译的食谱基准
ReciLoReL 包含 600 条食谱,全部由专家翻译并做文化适配,覆盖约鲁巴语、豪萨语和伊博语。与常见的通用领域平行语料不同,这些食谱经过刻意改写,使目标语言读者能按本地烹饪习惯理解步骤。基准的构建思路说明:低资源语言的翻译评测不能只看字面忠实度,文化可理解性同样需要被量化。
低资源语言在NLP中指缺乏大规模、高质量标注语料和计算资源的语言,通常不在主流模型训练数据中占据显著比例。豪萨语、约鲁巴语和伊博语虽然使用人口众多(合计超过1亿),但在互联网文本和公开平行语料中占比极低,因而被归为低资源语言。这类语言的机器翻译面临数据稀疏、领域覆盖不足和评估资源匮乏等挑战,文化特定内容(如食谱)的翻译质量尤其难以保证。
ReciLex:约1.5万条实体的多语言烹饪词典
ReciLex 是一个多语言烹饪词典,收录约 15,000 条翻译实体,横跨十个食谱实体类别,包括食材、工具、厨师动作、工具状态和时长等。它的作用不是替代模型训练,而是作为外部知识注入——论文的核心问题正是:在不大规模收集目标语言食谱语料、不做微调的前提下,仅靠词典增强能否提升文化适配翻译质量。
评测方法:传统指标之外的五项文化适配标准
研究沿用了 BLEU、chrF 和 TER 等基于参考译文的常规指标,同时从既有跨文化适配方法中改编出五项文化适配评价标准。这一双轨设计值得关注:自动指标衡量表层相似度,文化适配标准则考察译文是否真正符合目标文化的烹饪实践。人工评估采用五分制,对五项标准分别打分,使定性判断也有了可比较的刻度。
BLEU(Bilingual Evaluation Understudy)通过计算译文与参考译文之间n-gram的精确匹配率来衡量翻译质量,取值0-100,越高越好,但侧重字面重叠,对语序变化和文化改写不敏感。chrF基于字符级n-gram的F1分数,对形态丰富的语言更友好。TER(Translation Edit Rate)计算将译文编辑成参考译文所需的最少编辑操作数(插入、删除、替换、移位)占参考长度的比例,越低越好,反映译文的编辑成本。三者均为基于参考译文的自动指标,无法直接捕捉文化适配性,因此需要辅以人工评估。
实验结果:词典增强带来稳定提升
在所选模型和语言上,ReciLex 增强将平均 BLEU 从 13.57 提升到 14.51,chrF 从 37.89 提升到 38.74,TER 从 77.14 降至 75.12。人工评估中,五项文化适配标准上的提升幅度为 0.11 到 0.36 分(五分制)。这些数字算不上飞跃,但方向一致:不依赖大规模目标语料,仅靠结构化词典就能改善文化适配翻译。考虑到低资源语言的语料获取成本,这种轻量增强路径有现实价值。
微调(Fine-tuning)指在预训练大模型的基础上,使用特定领域或任务的数据继续训练,使模型参数适应目标场景。对于低资源语言,微调通常需要数百至数千条高质量平行语料,收集成本高昂且可能引发过拟合。本文采用的词典增强属于免训练的知识注入方法:将ReciLex中的实体翻译以检索或提示的方式提供给模型,引导其生成更符合目标文化的译文,从而绕开微调所需的数据和算力门槛。
意义与局限
这项工作贡献了三类资源:专家翻译的基准、覆盖多实体类别的烹饪词典,以及可操作的文化适配评价标准。对低资源语言 NLP 而言,它把"文化适配"从模糊的口号变成了可测量、可对比的指标。需要留意的是,研究聚焦于三种尼日利亚语言和食谱这一特定领域,结论能否迁移到其他低资源语言或文本类型,仍需后续验证。此外,自动指标的提升幅度有限,说明词典增强只是起点,而非终点。
对多语言AI开发的启示
对构建多语言应用的团队来说,ReciLex 的思路提供了一个可借鉴的范式:与其等待大规模语料,不如先整理领域实体词典,以检索或提示注入的方式增强模型。文化适配评价标准也提醒开发者,评估低资源语言输出时,BLEU 分数之外的本地化质量同样值得纳入验收流程。
相关推荐
Gemini 4 Neon实测:能平替Opus 5.5吗?三轮对比揭晓
B站UP主三轮实测对比Gemini 4 Neon、Opus 5.5和GPT-6.2 Sol,从3D建模到动画生成,分析性能与价格,探讨Gemini 4 Neon能否平替Opus 5.5。
Claude Fable 5.5曝光、GPT-6.2发布引争议,AI模型混战升级
Anthropic神秘模型Silicon 2疑为Claude Fable 5.5,OpenAI GPT-6.2 Astra与Soul发布引发社区两极评价,谷歌Gemini Neon与任务功能、微软Ignite新模型同步登场,本文梳理各模型真实优劣与行业信号。
真实珠宝大盗谈GTA6抢劫机制:踩点是核心
前珠宝大盗Larry Lawton在Lex Fridman播客中解析真实抢劫的核心——踩点与观察人的习惯,并表达对《GTA 6》抢劫机制的期待:如果只是冲进去开枪,游戏就失去了真实感。