Gemini 4 Neon实测:能平替Opus 5.5吗?三轮对比揭晓
三轮实测显示Gemini 4 Neon尚不能全面平替Opus 5.5,GPT-6.2 Sol性价比最高。
文章记录了一次针对谷歌新模型Gemini 4 Neon的三轮横向实测,对手是Opus 5.5与GPT-6.2 Sol。测试统一使用官方Harness、高思考强度、不加载Skill、MD格式输出,以控制变量。三轮任务分别为3D摩托建模、Blender迈阿密跑车曲面建模和复杂动画生成。结果显示Opus 5.5在质感、曲面处理与动画质量上整体领先,但耗时较长;GPT-6.2 Sol价格极低、速度不慢、质量稳定,综合性价比最高;Gemini 4 Neon速度有亮点、首轮价格较低,但精致度不足,第三轮因命中率仅32%导致费用飙升。结论是"平替"为时尚早,模型选型需按场景权衡。
谷歌新模型Gemini 4 Neon在AA榜单上冲至第三,甚至超越了自家旗舰Gemini 4 Pro,被不少人视为Opus 5.5的平替。B站UP主进行了一场三轮实测,对比Gemini 4 Neon、Opus 5.5和GPT-6.2 Sol的真实表现。
测试设置:统一环境下的公平较量
测试使用三位选手的官方Harness,统一开启高思考强度,不加载Skill,均使用MD格式。这种控制变量法保证了对比的公平性,能直观反映模型在复杂任务中的原生能力。
Harness 指的是模型厂商官方提供的评测/调用框架(如 Anthropic 的 Claude Code、OpenAI 的 Codex CLI 等),它封装了系统提示词、工具调用协议与文件读写方式。同一模型在不同 Harness 下表现可能差异明显,因此跨模型对比时使用各自官方 Harness 是最接近真实用户体验的方式,但也意味着无法完全消除框架层面的差异。
高思考强度 对应模型的推理预算(reasoning effort / thinking budget)设置。开启高档位后,模型会生成更长的思维链再作答,通常能提升复杂任务的成功率,代价是延迟与 token 消耗上升。统一档位可避免"一方开满推理、另一方默认模式"造成的不公平。
不加载 Skill 指禁用可插拔的技能包或工具集(如特定领域的提示词模板、外部脚本),只保留模型原生能力,从而排除外部脚手架对结果的干扰。
第一轮:3D摩托建模,Opus 5.5质感领先
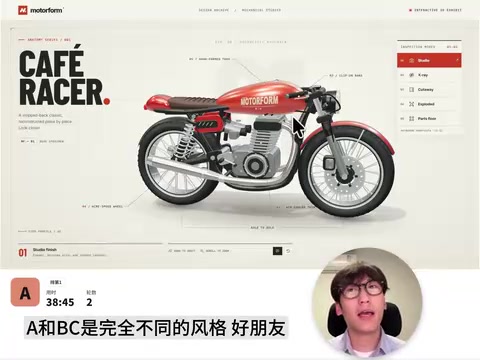
第一个任务是3D摩托建模,考验前端与建模能力。A模型(Opus 5.5)一进来质感亮眼,零件反光效果出色,四种模式切换流畅,17分钟完成。B模型(GPT-6.2 Sol)相对粗糙,部分零件逻辑混乱。C模型(Gemini 4 Neon)虽然炫酷,但零件拆解后不如A精细。
UP主最终排名:C第一(最快),A第二,B第三。但揭晓价格后,Opus 5.5为6.24元,而Gemini 4 Neon仅7元API费用,价格优势明显。不过速度上Gemini 4 Neon较慢。
第二轮:迈阿密跑车曲面建模,A模型曲面处理最佳
第二个任务是用Blender制作迈阿密跑车,曲面处理是建模难点。A模型曲面自然,拆解零件合理。B模型出现镂空和逻辑错误,零件虽多但诡异。C模型曲面有亮光,但3D模型导入后精致度下降,拆解零件不如A。
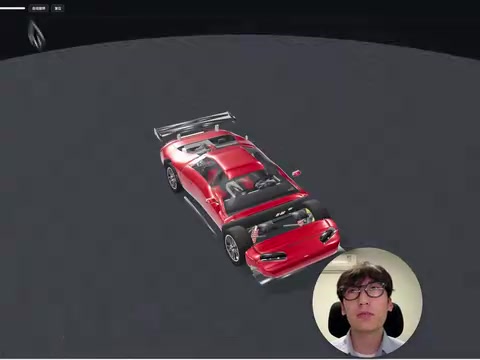
这轮UP主认为A最好,B和C难分伯仲。Gemini 4 Neon再次排名靠后,且价格虽低但速度慢。
第三轮:复杂动画生成,A质量高但C速度快
第三个任务模仿Kimi 3.1 Pro宣传视频的完整提示词,生成炫酷动画。C模型速度极快,但画面精致度不足;B模型速度也快,但暂停质量一般;A模型质感最好,但耗时较长。
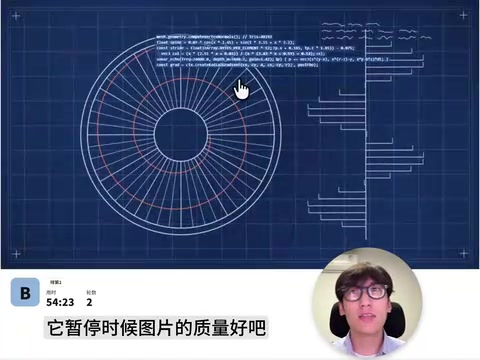
这轮Gemini 4 Neon价格异常昂贵,UP主查询发现后台命中率仅32%,导致成本飙升。UP主确定Opus 5.5的动画质量最高,但耗时最长。
文中提到的命中率,通常指 API 调用中**缓存命中(cache hit)**的比例,或请求被路由到高效推理路径的比例。主流 API 普遍提供提示词缓存机制:当请求前缀与之前调用高度重合时,可复用已计算的 KV 缓存,单价大幅降低;未命中则按全价计费。像第三轮这种长提示词、多轮改写的任务,一旦缓存频繁失效,实际费用可能数倍于预期。这也是同一模型在不同任务间价格波动巨大的主要原因,评估成本时应看命中率而非单次账单。
价格与性能分析:GPT-6.2 Sol性价比突出
三轮测试中,GPT-6.2 Sol价格极低,速度不慢,质量稳定过关,成为性价比之选。Gemini 4 Neon在部分任务中价格便宜(如第一轮7元),但第三轮因命中率低导致费用高涨。Opus 5.5质量领先,但价格和耗时较高。
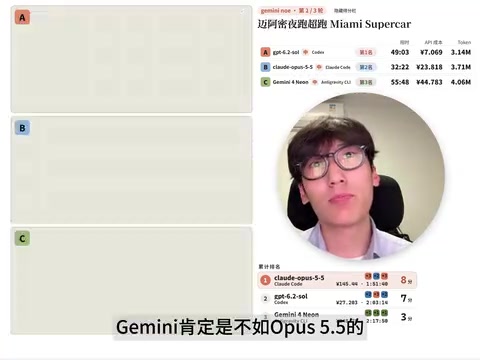
UP主总结:GPT-6.2 Sol是均衡的选择;Gemini 4 Neon目前不如Opus 5.5,但有人提到它在软件UI动效方面可能较强,有待进一步测试。
结论:平替尚早,但潜力可期
三轮实测下来,Gemini 4 Neon并未展现出全面平替Opus 5.5的实力。在3D建模、曲面处理和动画质感上,Opus 5.5仍占优。不过Gemini 4 Neon在速度上有亮点,且价格在部分场景下较低。对于需要快速生成简单任务的用户,它可能是一个备选。
UP主表示后续将测试软件UI动效和后端代码生成,以更全面评估Gemini 4 Neon的能力。同时,他引用了GPT模型负责人Tibo的建议,在MD文件中加入特定语句以提升效果,供开发者参考。
这场测试揭示了模型选型的复杂性:没有绝对的平替,只有适合场景的权衡。
AA 榜单(Artificial Analysis 排行榜)是第三方评测机构 Artificial Analysis 维护的模型综合排名,通常聚合多个公开基准(推理、代码、数学等)并加权,同时给出速度与价格维度。它的价值在于提供横向快照,但不能替代具体场景实测:榜单分数相近的模型,在 3D 建模、长动画生成这类多模态与长时序任务上可能差距悬殊。因此文中"榜单第三却实测不及"并不矛盾,恰好说明选型应以自身任务分布为准。
相关推荐
Gemini 4 Neon发布:性能超旗舰、成本降40%,谷歌RSI要成了?
谷歌Gemini 4 Neon正式发布,AA综合智能榜61分超过Carbon,Coding Agent榜第一,速度快三倍、成本降40%。两个月连发四款模型,RSI传闻再起,本文拆解榜单数据、定价策略与发布节奏背后的真实信号。
Gemini 4 Neon实测:编码第一但慢近一倍,这账怎么算
海外评测圈实测Gemini 4 Neon:编码Agent Index排名第一,单任务成本约为克劳德一半,但每任务耗时比同类中位慢将近一倍。本文拆解第三方成本、速度与能力数据,帮你判断这笔账单值不值。
Gemini 4 Neon模型实测:与Astra 6.2生成PPT对比谁更强?
Google Gemini 4 Neon模型实测:与Astra 6.2同题生成线下演讲PPT,视觉不分伯仲,Neon内容准确性和详细度胜出,能忠实转换数据源;但修改时只返回单页、UI和图片易被重绘。快速模型打平旗舰,值得一用。