点赞失效?任务型LLM如何用物理结果闭环反馈
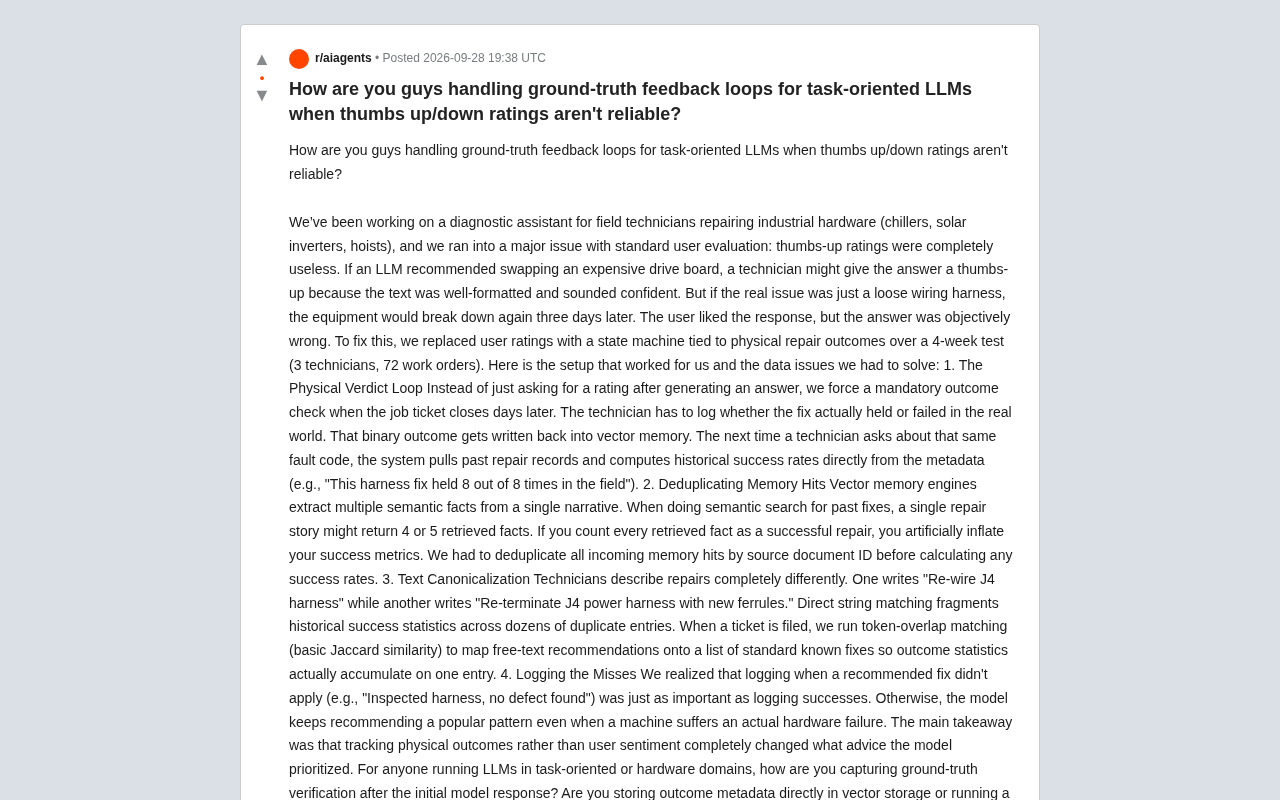
工业设备维修AI案例:用物理结果闭环替代用户点赞,才能构建可靠的任务型LLM评估体系。
一位开发者在为工业设备维修技师打造诊断助手时发现,传统的用户点赞评分在任务型场景下几乎无效——技师可能因答案格式工整而给好评,但推荐的修复方案在现场却失败了。为此,团队在72张工单的测试中设计了一套绑定物理维修结果的评估机制:工单关闭时强制回写真实成败结果,并通过向量记忆去重、Jaccard文本规范化和负样本记录三项工程手段保证统计可信度。核心结论是:当反馈信号来自真实世界的物理成败,模型学到的是"什么方案真的有效"而非"什么答案听起来专业",优先推荐的建议内容因此发生了根本性转变。这一实践对所有将LLM推向真实生产环境的团队具有普遍参考价值。
当"点赞"变成误导:任务型LLM的评估陷阱
一位Reddit开发者分享了他们为工业设备(冷水机组、太阳能逆变器、起重机)维修技师打造诊断助手时的真实教训:标准的用户点赞(thumbs up/down)机制在任务型场景下几乎毫无价值。
问题的核心在于用户满意度与答案正确性之间的错位。当LLM建议更换一块昂贵的驱动板时,技师可能因为回答格式工整、语气自信而给出好评。但如果真正的故障只是一根松动的线束,设备三天后照样罢工。用户"喜欢"了这个回答,可它在客观上是错的。
这揭示了一个被广泛忽视的评估盲区:在需要真实世界结果验证的领域,主观情绪反馈(sentiment)无法作为ground-truth。文本的说服力和事实的准确性是两条完全不同的曲线。
用物理结果替代用户情绪的四步方案
为了解决这个问题,该团队在一个为期4周、覆盖3名技师和72张工单的测试中,用一套绑定物理维修结果的状态机取代了用户评分。以下是他们跑通的完整设置,以及每个环节踩过的数据坑。
1. 物理结果闭环(The Physical Verdict Loop)
他们不再在生成答案后立即索要评分,而是在工单几天后关闭时强制触发一次结果核查。技师必须记录这次维修在现实中"扛住了"还是"又坏了",这个二元结果会被写回向量记忆。
下次有技师查询同一故障码时,系统会拉取历史维修记录,直接从元数据中计算历史成功率——例如"这个线束修复方案在现场8次中成功了8次"。这种做法把评估锚定在了可观测的物理事实上,而非语言表达。
2. 记忆命中去重(Deduplicating Memory Hits)
向量记忆引擎会从单条叙述中抽取出多个语义事实。做语义检索时,一个维修故事可能返回4到5条检索事实。如果把每条检索事实都算作一次成功维修,成功率指标就会被人为放大。
他们的解法是:在计算任何成功率之前,先按源文档ID对所有记忆命中做去重。这是一个容易被忽视但直接影响统计可信度的细节。
3. 文本规范化(Text Canonicalization)
技师描述维修的方式千差万别。一个人写"Re-wire J4 harness",另一个人写"Re-terminate J4 power harness with new ferrules"。直接字符串匹配会把同一种修复的历史成功统计碎片化成几十条重复条目。
团队在工单归档时运行了基于token重叠的匹配(基础的Jaccard相似度),把自由文本的建议映射到一份标准已知修复方案清单上,让结果统计真正累积到同一个条目上。
4. 记录"未命中"(Logging the Misses)
一个反直觉的发现是:记录"某个推荐方案不适用"(例如"检查了线束,未发现缺陷")和记录成功同样重要。
否则,即便机器遭遇了真正的硬件故障,模型仍会不断推荐那些"流行"的常见模式。负样本的缺失会让模型陷入统计偏差,把高频方案误当成高正确率方案。
为什么这套方法改变了模型的优先级
这位开发者总结的核心收获是:追踪物理结果而非用户情绪,彻底改变了模型优先推荐的建议。
这背后的逻辑值得任何做任务型或硬件领域LLM的团队深思。当反馈信号来自真实世界的成败,而不是界面上的一次点击,模型学习到的就不再是"什么答案听起来专业",而是"什么方案真的有效"。
延伸的工程问题:结果元数据存哪里?
原帖最后抛出了一个开放性讨论:对于运行在任务型或硬件领域的LLM,大家是如何在初始模型响应之后捕获ground-truth验证的?是把结果元数据直接存进向量存储,还是单独跑一个数据库来管理作业统计?
这个问题触及了检索增强系统的一个架构选择:向量存储擅长语义召回,但对结构化的成功率统计并不天然友好。把二者混在一起可能带来去重和聚合的复杂度(正如上文提到的记忆命中去重问题),而分离存储又需要额外的同步机制。
向量存储(如Pinecone、Weaviate、pgvector)的核心优势是高效的近似最近邻检索,但其数据模型并非为关系型聚合查询设计。将成功率、维修次数等结构化统计与向量元数据混存,虽然省去了跨系统同步的麻烦,但在执行"按故障码聚合成功率"这类查询时,往往需要拉取大量向量条目再在应用层汇总,效率低且难以保证一致性。另一种架构是将向量存储专用于语义召回,另起一张关系型表(PostgreSQL或SQLite均可)存储工单ID、维修动作标准码、结果标记(成功/失败)和时间戳,两张表通过工单ID关联。检索时先从向量库拿到候选文档ID,再去关系库查对应的成功率统计,职责边界清晰,聚合查询也更高效。代价是需要在工单归档时保持两套存储的写入同步。
对构建可靠反馈闭环的启示
这个案例虽然来自单一开发者的实践分享,样本规模也有限(72张工单),但它对任务型AI系统的设计有普遍的参考价值:
- 评估信号要贴近业务真值。在有客观成败标准的领域,把主观满意度当作优化目标是危险的。
- 数据卫生决定指标可信度。去重、文本规范化、负样本记录这些"脏活",直接决定了成功率统计是否真实。
- 反馈闭环需要时间延迟。真正的验证往往发生在响应之后数天,系统架构必须能承接这种异步、滞后的结果回写。
对于正在把LLM推向真实生产环境的团队来说,如何设计一条可信的ground-truth反馈回路,可能比模型本身的选择更能决定系统的长期价值。
背景补充
向量记忆引擎(Vector Memory Engine)是检索增强生成(RAG)系统的核心组件,其工作原理是将文本切分为若干语义块(chunks),分别编码为高维向量并存入向量数据库。查询时,系统将问题同样编码为向量,通过余弦相似度等指标召回最相关的块。问题在于,一段完整的维修叙述往往包含多个独立事实——"故障现象是X、检查了Y、最终替换了Z"——这些事实会被切分成多个向量块分别存储。当同一查询触发多块返回时,若不溯源到原始文档,就相当于把一次维修事件在统计上放大成了多次成功记录。按源文档ID去重的本质,是在向量的"语义碎片"与业务逻辑的"事件完整性"之间建立正确的映射关系。
Jaccard相似度是一种衡量两个集合相似程度的经典方法,计算公式为两个集合的交集大小除以并集大小,结果在0到1之间。应用于文本时,通常先将句子拆分为token(词或词根)的集合,再计算重叠比例。例如"Re-wire J4 harness"和"Re-terminate J4 power harness with new ferrules"的token集合有"J4"和"harness"两个共同词,Jaccard值约为0.2,结合阈值判断即可归为同一类修复。这种方法计算简单、无需预训练,适合词汇相对固定的工业维修领域。相比之下,如果直接用语义向量做归类,措辞不同但含义相同的描述有时反而因向量距离偏大而被分为不同条目,反而不如基于token重叠的轻量方案准确。
相关推荐

只想要一个自定义域名邮箱,为何如此艰难?
拥有一个自定义域名邮箱看似简单,实则涉及 SPF/DKIM/DMARC 配置、IP 信誉、托管服务成本等诸多难题。本文梳理自建与托管方案的权衡,并给出实用建议。

Claude意外帮用户发现燃气泄漏:AI助手的安全应用边界
一位Reddit用户借助AI助手Claude识别出家中燃气泄漏隐患,PG&E上门确认并修复。本文分析AI助手在家庭安全场景中的真实价值与使用边界,以及处理燃气泄漏的正确做法。

Gemini 4 Argon发布:谷歌重返前沿,但故事没那么简单
谷歌时隔半年发布前沿模型Gemini 4 Argon,跑分重返一线却暂不开放。本文解析其基准表现、与Sonnet 5.5的竞争,以及模型能力与产品体验之争。