Dify从0搭建AI应用全指南:五大应用与工作流详解
Dify是可视化AI应用平台,本文系统介绍其部署方式、五大应用类型、模型接入与发布路径。
Dify是一款面向企业和个人的低代码AI应用构建平台,通过可视化编排将大语言模型、外部工具与数据库整合为可交付产品。本文介绍了其三种部署方式(官方在线、源码、本地Docker),重点推荐基于Windows Docker的本地部署,因其可直接调用本机MySQL等数据库资源。平台提供五大应用类型:聊天助手、文本生成、Agent智能体,以及支持对话交互的Chatflow和面向一次性任务的Workflow,工作流以节点模块化编排为核心能力。模型接入方面建议优先选择DeepSeek、通义千问等云端模型,成本极低且效果稳定。构建完成的应用支持发布为公开Web站点、嵌入第三方网站或以API形式调用,覆盖从实验到生产的完整交付路径。
Dify是什么:低门槛的AI应用构建平台
Dify本质上是一个AI应用平台,它的核心价值在于把原本复杂的大模型开发流程封装成可视化操作,让企业级和个人级的AI应用都能快速落地。你不需要写大量胶水代码,就能把大语言模型、外部工具、数据库这些组件串联起来,搭建出可用的产品。
对于想入门AI智能体开发的人来说,Dify降低了两个层面的门槛:一是不用从零编写调用逻辑,二是提供了可视化的工作流编排。这也是这套教程强调「从0搭建20+应用」的底气所在——平台本身把重复劳动省掉了,学习者可以把精力放在应用设计上。
三种部署方式:本地Docker、源码与官方在线
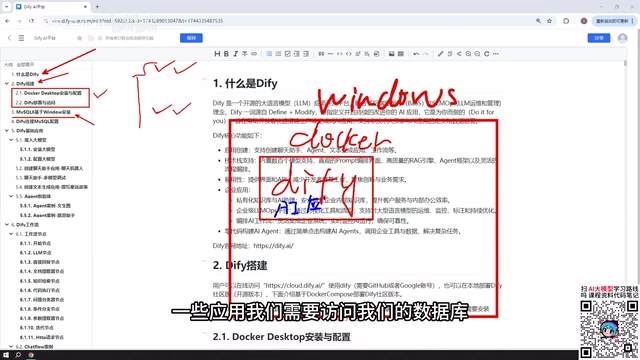
Dify的部署有三条路径,各有适用场景。教程中采用的是基于Windows Docker的本地部署方案,这也是最推荐给学习者和企业内部使用的方式。
- 官方在线页面:最省事,直接使用官方托管的Dify,界面与自建版本完全一致。但如果你的AI应用要访问本机数据库或本地环境,就需要借助内网穿透工具把本机IP暴露到公网。
- 源码部署:适合需要深度定制的开发者。
- 本地Docker部署(教程采用):在Windows上安装Docker后部署Dify,本机的MySQL或其他环境都能被Dify直接调用,生产环境下企业内部应用尤其方便。
这里有个关键的网络细节:Docker安装完成后,Dify的网络能够与Windows宿主机上的MySQL通信,也能与VMware部署的虚拟机通信。换句话说,数据库放在Windows本机、Docker容器里还是虚拟机中都可行,灵活度很高。
Docker是一种容器化技术,它把应用程序及其所有依赖打包进一个隔离的「容器」中运行,确保在任何机器上的运行结果一致。对于Dify这样由多个服务组成的复杂应用(包括Web服务、数据库、向量存储等),Docker Compose可以用一条命令同时启动所有服务,省去逐个安装配置的麻烦。Windows上需要先安装Docker Desktop,它在底层通过WSL2(Windows Subsystem for Linux 2)提供Linux运行环境。安装完成后,Dify容器内的服务能通过Docker的虚拟网络桥接访问Windows宿主机上的本地端口,这正是它能直接连通本机MySQL的技术基础。
数据库集成:为什么要装MySQL 8
教程专门安排了MySQL 8在Windows上的安装讲解,原因很实际:后续在Dify里构建的AI应用往往需要读取数据库中的数据,做数据驱动的智能交互。所以先把数据库准备好,再讲解Dify连接MySQL的配置,逻辑上是顺理成章的。
如果你已经熟悉MySQL安装,这一节可以直接跳过。MySQL的部署位置并不受限——本机安装、Docker容器或虚拟机都能与Dify打通,这也体现了本地部署方案在环境整合上的优势。连接配置是让AI应用真正「用上数据」的关键一步,不能省略。
Dify的五大核心应用类型
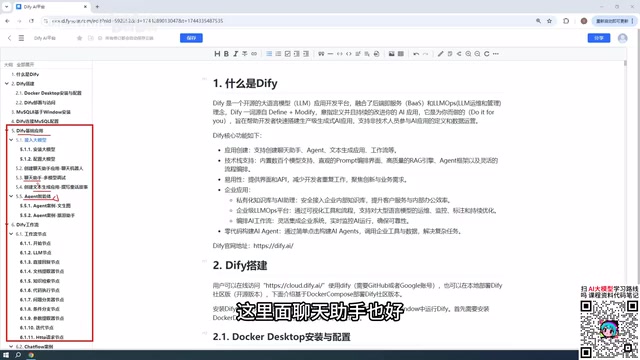
Dify在创建应用时提供五种类型,这也是整套课程的主干内容。它们覆盖了从简单对话到复杂编排的完整光谱。
三种基础应用
- 聊天助手:最基础的形态,就是与AI模型进行对话交互。
- 文本生成:让模型一次性产出内容,比如写文章、生成文档、撰写故事或小说。
- Agent智能体:与前两者最大的区别在于它能调用工具,系统性地完成用户指令。例如先爬取网页、再对内容做分析,这类多步骤任务正是智能体的强项。
工作流:Chatflow与Workflow
除了三种基础应用,工作流是Dify里更进阶也更强大的能力,它又分为两类:
- Chatflow(聊天流):支持你与工作流进行多轮对话。
- Workflow(工作流):面向一次性任务,输入后直接输出结果,不做持续对话。
两者的核心差异就在于是否支持对话式交互。工作流由一个个「节点」组成,每个节点相当于一个功能模块,把它们编排起来就构成了完整的处理流程。教程会重点讲解官网提供的大部分常用节点,并为十几个节点配备实操案例。
大模型接入:优先选择付费云端模型
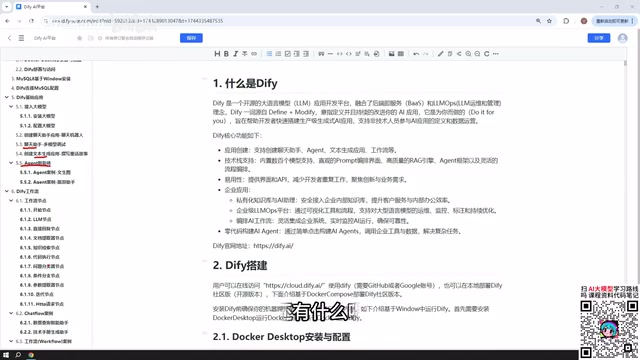
所有这些应用都要与大模型交互,所以接入模型是第一步。教程给出的建议很明确:优先使用付费的云端模型,而不是本地部署的小模型。
可选的模型包括DeepSeek、ChatGPT等付费模型,也有百度文心一言、阿里通义千问这类提供免费token的选项。免费token通常是百万级别,对学习和测试足够用。
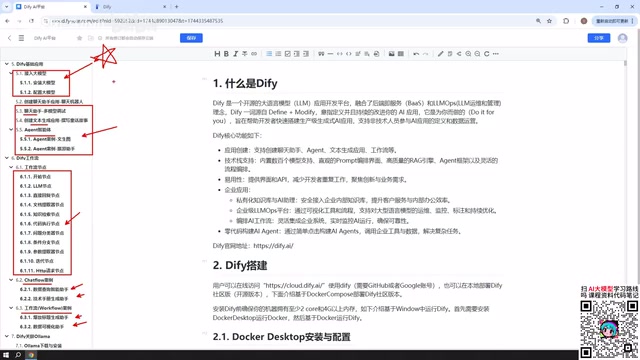
听到「付费」不必紧张。以DeepSeek为例,充值十元可以用很久——教程作者提到自己充了十元,用了很长时间还没花到一块钱,成本极低。之所以不推荐本地模型(如通过Ollama部署的小模型),是因为参数量小的模型效果有限,实际应用体验不佳。
当然,如果你的机器性能足够强,或者是企业级集群部署,用Ollama跑DeepSeek开源大模型(最大参数版本下载后可达400多G)也完全可行,效果会更好。Dify与本地Ollama模型的整合,教程后续也会配案例讲解。
Token是大语言模型计量输入输出长度的基本单位,粗略来说中文约1.5个汉字对应1个token,英文约4个字符对应1个token。云端模型通常按token消耗量计费:输入token(你发给模型的内容)和输出token(模型返回的内容)分别计价。DeepSeek、通义千问等模型的API价格已降至极低水平,百万token仅需数元人民币。部分平台还会在新用户注册时赠送免费额度,足够完成整套教程的学习实验。选择云端API而非本地部署的另一个优势是无需占用本机GPU资源,普通笔记本也能流畅运行所有Dify应用。
应用发布:从内部使用到公开上线
在Dify里构建的应用不只能在自己部署的平台内使用,发布方式相当多样:
- 发布为公开Web站点:生成一个所有人都能访问的链接,把应用发布到公网。本机部署的话需要配合内网穿透打通内外网。
- 嵌入到自有网站:将应用作为组件集成进你开发的网站。
- 通过API调用:以API(含Python API)方式接入,供其他系统程序化使用。
这一环节把Dify从「本地实验工具」提升为「可交付的产品能力」,无论是对外提供服务还是对内集成到业务系统,都有对应的落地路径。
内网穿透是将本地网络中的服务暴露到公网的技术手段。由于家庭宽带和企业内网通常没有固定公网IP,外部用户无法直接访问本机部署的Dify服务。内网穿透工具(如frp、ngrok、Cloudflare Tunnel等)通过在公网服务器上中转流量,为本地服务分配一个可公开访问的域名或IP。对于Dify的本地部署场景,如果只是内部团队使用,局域网内直接访问即可;若需要对外发布应用或让Dify的Webhook功能接收外部请求,则需配置内网穿透。企业环境下,将Dify部署在拥有公网IP的云服务器上是更稳定的替代方案。
总结
整套Dify教程的脉络清晰:从平台认知、Docker部署、数据库集成,到五大应用类型(聊天助手、文本生成、Agent智能体、Chatflow、Workflow)的逐一实操,再到模型接入与应用发布。对于想系统入门AI应用搭建的人来说,这条学习路径把可视化编排、数据集成和上线发布串成了一条完整链路,配合丰富的案例,比单纯啃文档更容易上手。
背景补充
Agent(智能体)的核心机制通常被称为ReAct或工具调用循环:模型接收用户指令后,自主判断需要调用哪些工具、按什么顺序执行,然后根据工具返回的结果决定下一步行动,直到任务完成。这与聊天助手的单轮问答有本质区别——智能体具备「规划-执行-观察-再规划」的迭代能力。常见的可调用工具包括网络搜索、代码执行、数据库查询、文件读写等。Dify的Agent应用封装了这套循环逻辑,用户只需配置工具列表和系统提示词,无需手动实现调用调度代码。
相关推荐
厦门大学AI编程课落地实践:从教材到教学的全解析
厦门大学林子雨副教授分享《AI编程与智能体开发》课程建设实践,涵盖AI编程三段演进、Claude Code生产级拐点、三种编程方法论及教材设计,详解免费可复现的高校教学落地方案。
DeepSeek研究员自白:亲手训练的AI即将取代自己
DeepSeek V4.1核心算子编写者刘胜宇发文自白:亲手训练的AI最快半年到一年将取代自己写算子的能力。他为何仍坚持优化模型?又为何担忧AI把世界推向赛博朋克式极端并选择开源?
n8n 自动化实战:AI 工作流如何为中小企业降本增效
本文基于一线从业者的实战分享,讲解如何用 n8n 与 AI 工具构建工作流自动化,涵盖多平台消息聚合、AI 自动回复、批量数据录入与智能校验,帮助中小企业降本增效。