Dify从部署到搭建智能体全流程实战教程

本文系统梳理Dify平台从部署到搭建智能体的完整入门流程,覆盖五大应用类型与模型接入策略。
Dify是一款开源的AI应用开发平台,定位为连接大模型、数据与业务逻辑的中间层,支持在线版、Docker本地部署和源码部署三种方式。教程以Windows Docker部署为基础,配合MySQL 8完成数据库配置,打通AI应用与业务数据的通路。Dify的核心功能涵盖五类应用:聊天助手、文本生成、Agent智能体(可调用外部工具完成多步骤任务)、ChatFlow(支持多轮对话的工作流)以及Workflow(一次性执行的节点化流程)。在大模型接入方面,教程建议优先选择DeepSeek、ChatGPT等付费云端模型,或百度文心一言、阿里通义千问等提供免费token的国产模型,不推荐初学者使用受限于硬件性能的本机小模型。构建完成的应用可发布为公开Web站点、嵌入自有网站或通过API调用,灵活适配各类业务场景。
Dify作为一款开源的AI应用开发平台,让开发者无论是构建企业级应用还是个人使用的AI工具,都能以较低门槛快速落地。本文基于B站UP主的系统化教程,梳理从Dify安装部署到搭建智能体的完整流程,帮助AI大模型初学者建立清晰的技术脉络。
Dify是什么:一站式AI应用构建平台
Dify本质上是一个AI应用开发平台,核心价值在于让用户无需从零编写大量代码,就能快捷地搭建各类AI应用。它既适合企业级的规模化部署,也能满足个人的日常使用需求。
对于初学者来说,理解Dify的定位很关键——它不是模型本身,而是一个连接大模型、数据和业务逻辑的中间层平台。你既可以直接使用官方提供的在线版本,也可以自行部署到本地环境。两者页面几乎一致,区别主要在于数据访问方式:在线版本如果需要调用本机的数据库或环境,往往需要借助内网穿透工具将本机IP暴露到公网。
在生产环境中,教程建议采用本地部署方案。这样可以让Dify直接访问本机的MySQL等数据库环境,在公司内部应用时更加方便可控。
内网穿透(Intranet Penetration)是指借助第三方服务器,将局域网内的服务映射到公网可访问的地址上。常用工具包括 frp、ngrok 和国内的花生壳等。其原理是:本地客户端与公网服务器保持长连接,外部请求到达公网服务器后,再通过该连接转发至本机。对于在本机部署 Dify 并希望让外部用户访问的场景,内网穿透是最常见的解决方案,但同时也带来了一定的安全风险——暴露在公网的服务需要配置访问鉴权,防止未授权访问本机数据库或敏感数据。
环境搭建:Docker部署与MySQL配置
教程采用的是基于Windows Docker的部署方式。除此之外,Dify还支持源码部署等多种方案,用户可根据自身情况选择。
部署完成后,一个关键环节是数据库的配置。由于后续在Dify中构建的AI应用往往需要读取数据库中的数据来完成交互,因此需要提前准备好数据库环境。教程以MySQL 8在Windows上的安装为例进行演示。
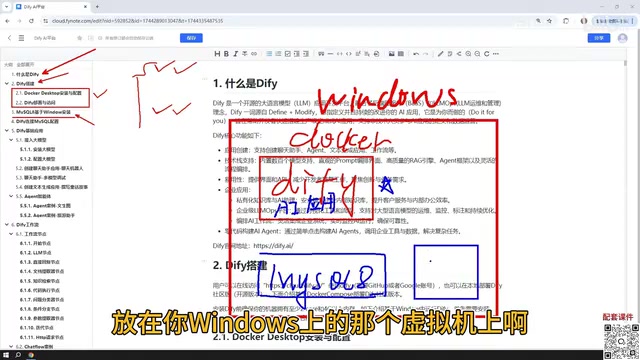
值得一提的是,MySQL的部署位置相当灵活:既可以直接装在Windows本机,也可以基于Docker部署,甚至放在VMware虚拟机上都没有问题。Docker安装完成后,Dify所在的网络能够与Windows本机的MySQL正常通信,因此数据库的物理位置并不会成为限制。
数据库就绪后,还需要完成Dify连接MySQL的配置,这一步是打通AI应用与业务数据的桥梁。
五大核心应用类型详解
梳理Dify的功能体系,其核心应用可归纳为五种类型,理解这五类应用是掌握整个平台的关键。
基础应用:聊天助手、文本生成与Agent智能体
前三类属于基础应用。聊天助手是最简单直接的形态,即与AI模型进行对话交互。文本生成则专注于内容产出,无论是撰写文章、生成文档,还是创作小说、故事,都可以通过这类应用实现。

Agent智能体是三者中能力最强的。它与聊天助手、文本生成的本质区别在于——Agent能够调用工具来完成用户指令。例如,你可以让Agent先爬取网页内容,再对结果进行分析,这种多步骤、需要外部工具协作的任务正是Agent的用武之地。
Agent(智能体)的核心机制是"推理-行动"循环(ReAct 框架):模型在每一步先分析当前状态,决定是否需要调用某个工具,获取工具返回结果后再继续推理,直到任务完成。这与普通对话的单次"输入→输出"模式有本质区别。Dify 中的 Agent 可以绑定搜索引擎、代码执行器、数据库查询、HTTP 请求等多种工具,使其具备与外部世界交互的能力。正因为 Agent 需要多次调用大模型进行推理,其 token 消耗通常远高于普通聊天助手,在使用付费模型时需注意成本控制。
进阶应用:ChatFlow与Workflow工作流
除三类基础应用外,Dify还提供了两种工作流应用:ChatFlow(聊天流)和Workflow(工作流)。

两者的核心区别在于交互方式:ChatFlow支持在工作流过程中进行多轮对话,而Workflow则是一次性执行、直接输出结果的模式。工作流由一个个节点组成,每个节点相当于一个功能模块,多个节点组合起来构成完整的流程。掌握常用节点的使用方法,是构建复杂AI应用的基础。
Workflow 的节点化设计与低代码/无代码(Low-code/No-code)平台的思路一脉相承:将复杂逻辑拆解为标准化的功能单元,通过可视化连线组合成完整流程,从而降低编程门槛。Dify 中常见的节点类型包括 LLM 节点(调用大模型)、条件判断节点(if/else 分支)、代码节点(执行 Python/JavaScript 片段)、知识检索节点(RAG 向量搜索)以及 HTTP 请求节点等。ChatFlow 在此基础上增加了对话状态管理,允许用户在流程执行过程中提供补充信息或做出选择,适合需要人机协作决策的复杂场景。
大模型接入:优先选择付费云端模型
由于以上所有应用都需要与大模型进行交互,接入大模型是使用Dify前的必要步骤。

在模型选择上,教程给出了明确建议:优先使用付费的云端模型,如DeepSeek广告、ChatGPT等。同时也有一些提供免费token的选择,比如百度文心一言、阿里通义千问广告,注册后通常能获得百万级别的免费token,日常学习足够使用。
相比之下,教程不建议初学者直接使用本机模型。虽然Dify支持与本地Ollama部署的模型整合,但受限于个人机器性能,本地小模型的实际效果往往不理想。当然,如果你拥有高性能设备或企业级集群部署的Ollama,能运行较大参数的模型,那么用Dify对接本地模型构建企业级应用同样可行。
Ollama 是一个开源的本地大模型运行框架,支持一键下载并运行 Llama、Mistral、Qwen 等主流开源模型,屏蔽了底层 GPU 驱动和推理引擎的配置复杂度。其本地服务默认监听 11434 端口,并提供兼容 OpenAI 接口规范的 API,因此 Dify 可以通过统一的接口格式对接本地 Ollama 模型。模型参数量与运行所需显存大致成正比:7B 参数模型约需 8GB 显存,13B 约需 16GB,70B 及以上则需要多卡或高端消费级显卡。对于仅有集成显卡或低配独显的个人设备,运行效果和响应速度往往难以满足实际使用需求,这也是教程建议初学者优先选择云端模型的主要原因。
应用发布:从本地到公网的多种方式
在Dify中构建好的应用,并不局限于本地部署环境内使用。平台提供了多种发布方式,让应用能够触达更广泛的用户。
最直接的方式是将应用发布为公开的Web站点,生成一个所有人都能访问的链接。需要注意的是,若基于本机部署,这同样需要配置内网穿透来打通内外网。
除此之外,应用还可以嵌入到自己开发的网站中,或者通过API(如Python API)的方式调用。这种灵活的发布机制,使得Dify构建的应用能够无缝集成到各类业务场景中,大大提升了实用价值。
总结
这套Dify教程从平台认知、环境部署、数据库配置,到五大应用类型、大模型接入与应用发布,覆盖了从零到一的完整链路。对于AI大模型初学者而言,Dify降低了构建AI应用的技术门槛,让更多人能够将大模型能力转化为实际可用的产品。后续每个环节都会配备详细案例,建议边学边动手实践,才能真正掌握这套工具的精髓。
相关推荐

付费用户因"网络滥用"遭ChatGPT封号:1分钟秒拒的申诉机制引众怒
一名付费ChatGPT用户因"网络滥用"被无预警封号,三次申诉均在一分钟内被机器人驳回,全程无人工审核。本文梳理事件经过、可能的误判原因,并剖析AI平台自动化治理的申诉困境与开发者应对建议。

OpenSOP:用Git管理多语音Agent提示词的开源方案
OpenSOP 是一个开源工具,用 Git、YAML 和 Markdown 管理多个AI语音Agent的提示词,解决提示词重复、漂移和手动同步难题,支持改动影响预览和一键回滚。
AI代购时代来临:Shopify开放Agent结账,抢占万亿新市场
AI代购时代来临:Shopify开放Agent结账,抢占万亿新市场
Shopify开放AI代理结账功能,允许Agent读取、更新并提交订单。本文解析AI代购时代的平台分化、结构化数据的重要性与agent-assisted安全机制,并给出商家应对策略。