Dify工作流实战:从零搭建20+AI应用

梳理Dify的五种应用类型、Docker部署、模型接入与应用发布,形成完整入门路径。
本文基于B站UP主「小飞棍来喽」的Dify教程,并结合YouTube频道与官方文档交叉验证,系统梳理了这款开源AI应用开发平台的学习路径。文章首先说明Dify通过可视化界面降低AI应用开发门槛,随后详解五种核心应用类型:聊天助手、文本生成、Agent智能体、Chatflow与Workflow,并厘清Chatflow支持多轮对话而Workflow仅做一次性输入输出的区别。部署部分对比本地Docker、源码与在线三种方式,强调MySQL作为前置准备的必要性。模型接入建议初学者使用DeepSeek等低成本付费API,对本地Ollama模型的效果持谨慎态度。最后介绍应用可发布为公网站点、嵌入第三方或通过API集成,并提醒关注工作流功能的最新版本状态。
Dify作为一款开源AI应用开发平台,正在成为开发者快速构建AI应用的热门选择。B站UP主「小飞棍来喽」发布了一套完整的Dify教程,声称手把手带你从零搭建20+AI应用。本文基于该教程内容,结合多源信息,为你梳理Dify的核心功能、部署方式以及学习路径。
Dify是什么?为什么值得学
Dify是一个AI应用开发平台,通过可视化界面和模块化组件,让开发者能够快速搭建企业级或个人使用的AI应用。据B站UP主「小飞棍来喽」介绍,Dify的核心优势在于“快捷方便地构建AI应用”,无需从零编写大量代码。
YouTube频道「AI开发者社区」也在近期视频中评价Dify为“目前最适合快速原型的LLM应用平台之一”,与LangChain等代码框架形成互补。两个来源均认同Dify降低了AI应用开发的门槛,尤其适合需要快速验证想法的场景。
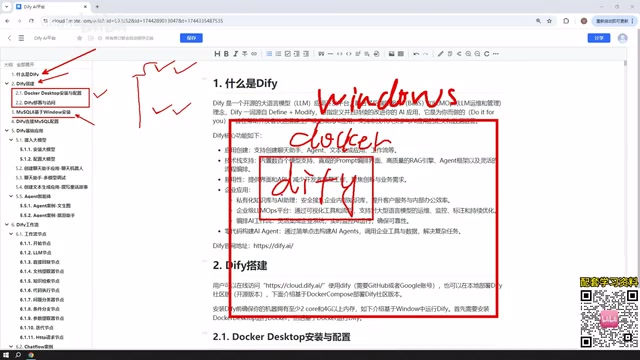
Dify的五种核心应用类型
根据教程内容,Dify主要支持五种应用类型,覆盖了从简单对话到复杂工作流的全部场景:
聊天助手与文本生成
聊天助手是最基础的应用类型,用于与AI模型进行对话交互。文本生成则专注于内容创作,如撰写文章、生成文档或小说。UP主在视频中演示了这两种应用的创建流程,并强调它们都配有详细案例。
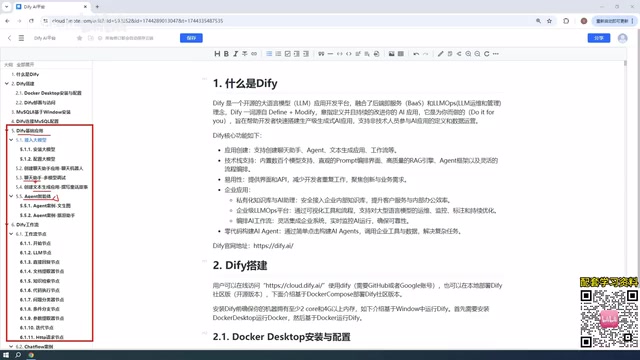
Agent智能体
Agent智能体与聊天助手的核心区别在于“可以调用工具”。UP主举例说明:让Agent先爬取网页再进行数据分析,这种多步骤任务正是Agent的强项。YouTube频道「AI开发者社区」同样指出,Agent模式是Dify区别于简单聊天界面的关键能力。
Function Calling(函数调用)机制是理解Agent能力的关键。大模型本身只能生成文本,无法直接执行爬虫、查数据库等操作。Function Calling 让模型在对话中输出结构化的“调用意图”(如 {"name": "web_scraper", "arguments": {"url": "..."}}),由 Dify 运行时解析后真正执行对应工具,再把结果回传给模型继续推理。Dify 的 Agent 节点本质上是把这套“模型决策—工具执行—结果回填”的循环封装成可视化配置,开发者只需在界面上挂载工具(内置插件或自定义 API),无需手写调度代码。这也解释了为什么 Agent 能完成“先爬网页再分析”的多步骤任务,而普通聊天助手做不到。
Chatflow与Workflow
工作流是Dify的重头戏,分为Chatflow(聊天流)和Workflow(工作流)两种。UP主解释两者的区别:Chatflow支持与工作流进行多轮对话,而Workflow只能进行一次性的输入输出。教程承诺会为工作流配备十多个案例,覆盖常见节点的使用。
Chatflow 与 Workflow 的底层差异来自“会话状态”的处理方式。Workflow 是单向的 DAG(有向无环图),每次运行接收一组输入变量,按节点顺序执行并输出结果,运行结束即销毁上下文,因此适合批处理、定时任务、文档加工等一次性场景。Chatflow 则在 Workflow 的基础上增加了会话变量(conversation variables)和对话历史管理,每个节点可以读写跨轮次保留的状态,并支持在流程中间插入“等待用户输入”的节点,从而形成多轮交互。二者共用同一套节点体系(LLM、知识检索、条件分支、代码执行、HTTP 请求等),区别只在于是否维护会话记忆和是否允许中断等待输入。
部署方案:Docker本地部署 vs 在线使用
教程选择基于Windows Docker进行本地部署。UP主对比了三种方式:本地Docker部署、源码部署、官方在线页面。在线版本功能与本地类似,但涉及本机数据库或环境时,需要内网穿透工具暴露公网IP。
对于生产环境,UP主建议自行部署到公司内部。这一观点与GitHub上Dify官方文档的推荐一致——官方文档同样将Docker Compose列为首选部署方式,并提供了详细的Windows安装指南。
为什么需要安装MySQL
教程专门讲解了MySQL 8在Windows上的安装,原因是后续构建的AI应用需要访问数据库进行数据读写。UP主说明,MySQL可以安装在Windows本机、Docker容器或VMware虚拟机中,Dify的Docker网络均能与之通信。这一步对于没有数据库基础的学员可能是个门槛,但属于必要的前置准备。
Docker 网络与宿主机服务的连通性是这里容易被忽略的技术点。Dify 通过 Docker Compose 启动时会创建一个独立的桥接网络,容器内的 localhost 指向容器自身而非 Windows 宿主机。因此当 MySQL 装在 Windows 本机时,Dify 容器不能写 127.0.0.1:3306,而要用 host.docker.internal 这个特殊域名(Docker Desktop 在 Windows/macOS 上提供)来访问宿主机;若 MySQL 也跑在同一个 Compose 网络里的容器中,则直接用服务名(如 mysql)作为主机名。此外还需在 MySQL 侧授权远程来源 IP 并确认 bind-address 未限制为仅本地,否则连接会被拒绝。理解这一点能避免大量“连接超时”的排错时间。
大模型接入:付费API vs 本地Ollama
教程建议初学者使用付费大模型API,如DeepSeek广告、ChatGPT,或利用百度文心一言、阿里通义千问广告的免费token。UP主以DeepSeek为例:“充十元钱可能用很久很久”,并展示自己的账户消费不到一元。
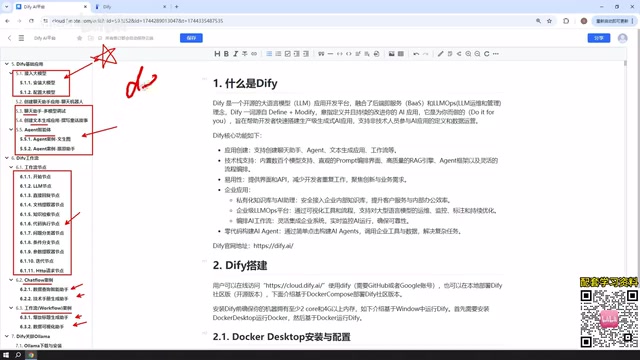
对于本地模型,UP主态度谨慎:虽然Dify可以整合Ollama部署的本地模型,但“那种应用一般都比较小,使用起来效果不是太好”。不过,如果机器性能足够或企业集群部署,本地大模型(如DeepSeek开源的数百GB参数模型)也能构建高质量应用。这一观点在Reddit的r/LocalLLaMA社区讨论中也有体现:本地模型适合隐私敏感场景,但效果通常落后于云端API。
Ollama 的定位需要澄清:它是一个本地模型运行时与模型分发工具,负责拉取量化后的模型权重(如 GGUF 格式)并通过兼容 OpenAI 的接口对外提供服务,Dify 只需把它当作一个自定义模型供应商接入即可。效果差距的主要来源不是 Ollama 本身,而是本地可运行的模型规模——消费级显卡通常只能跑 7B–32B 的量化模型,而云端 API 背后往往是数百 B 参数的稠密或 MoE 模型,在指令遵循、长上下文和工具调用稳定性上差距明显。因此本地部署的价值集中在数据不出内网、无调用成本和离线可用,而非追求与云端持平的生成质量。
应用发布:从本机到公网
Dify构建的应用不仅能在平台内使用,还支持发布为公开Web站点、嵌入第三方网站,或通过API集成到其他系统。UP主提到,公网发布需要内网穿透,而API方式则适合开发者灵活调用。这一能力使Dify应用可以脱离平台限制,融入实际业务流程。
学习路径总结
这套教程的内容结构清晰:从Dify介绍、部署、MySQL安装、数据库连接,到五种应用类型的案例实操,最后讲解Ollama集成和应用发布。UP主承诺配备20+案例,覆盖聊天助手、文本生成、Agent、Chatflow和Workflow。对于想系统学习Dify的开发者,这是一条完整的入门路径。
需要提醒的是,教程中提到的Dify工作流功能在当时版本中仍标注为测试版,UP主也表示“现在应该也比较稳定了”。实际学习时建议关注Dify官方文档的最新版本说明,以获取最准确的功能状态。
(本文基于B站UP主「小飞棍来喽」的教程内容整理,并结合YouTube频道「AI开发者社区」及Dify官方文档进行交叉验证。)
相关推荐

英伟达3万开发者用Cursor,代码提交量增3倍
Cursor现场工程师拆解企业AI编程从试点到规模化之间的五个缺口:战略清晰度、风险分级、治理审计、业务度量与运营战略。英伟达3万开发者每日使用Cursor,代码提交量增至3倍且缺陷率持平,关键在于重写SDLC而非叠加工具。

Ponytail:给AI编码代理装上资深工程师思维
Ponytail 是一个 GitHub 免费工具,为 AI 编码代理注入资深工程师思维,让 AI 先问代码是否必要。据 TamilDeck 介绍,它可将 AI 生成的 200 行代码压缩到 30 行,降低 token 成本,支持 Cursor rules 与 Claude Code skill 接入,但安全审查仍需人工把关。

Cursor AI 接入 GitHub MCP 服务器完整指南
手把手教你将 Cursor AI 接入 GitHub MCP 服务器:创建个人访问令牌、配置 mcp.json、用 ENV 块安全管理 token,并通过查询 PR 验证连接是否生效。